


BLOG / 05.11.2026
Mehrere Autoren des MIT CSAIL haben einen Blogbeitrag in den Vordergrund gerückt:Gewichts-Raum-Programmierung– Mit einem universellen Großmodell die Gewichte neuronaler Netze direkt lesen, ändern oder sogar von Grund auf neu schreiben. Die auffälligste Grafik auf der Titelkarte zeigt: Bei Qwen3.5-0.8B stieg die MATH-500-Punktzahl von 7,9 % auf 48,1 %, wobei lediglich 0,016 % der Gewichte angepasst wurden.
Im chinesischsprachigen Raum wurde dies schnell als „6-facher Anstieg, das Modell kann plötzlich Mathematik“ interpretiert. Der Autor-Beitrag und die Nachanalyse durch Dritte beziehen sich jedoch eigentlich auf etwas anderes: Zunächst muss die Denk-Endschleife durchbrochen werden, um dann das Potenzial des Modells freizusetzen, das zwar von Haus aus vorhanden ist, aber durch die Schleife blockiert wurde. Und der heutige Beitrag auf dieser Website über die graue Testphase von Codex 6.2 AstraDas ist überhaupt keine Neuigkeit.– In diesem Artikel geht es um eine Studie des MIT, in der mithilfe von GPT-6 Astra die Gewichte kleinerer Modelle angepasst wurden.
Die Beschreibung „6-facher Kursanstieg“ wurde herabgestuft auf „Rückkehr zum ursprünglichen Niveau nach Beseitigung der Zyklushürde + unabhängig überprüfbarer Gewichtsanpassung“.
Was haben sie denn eigentlich vorgeführt?
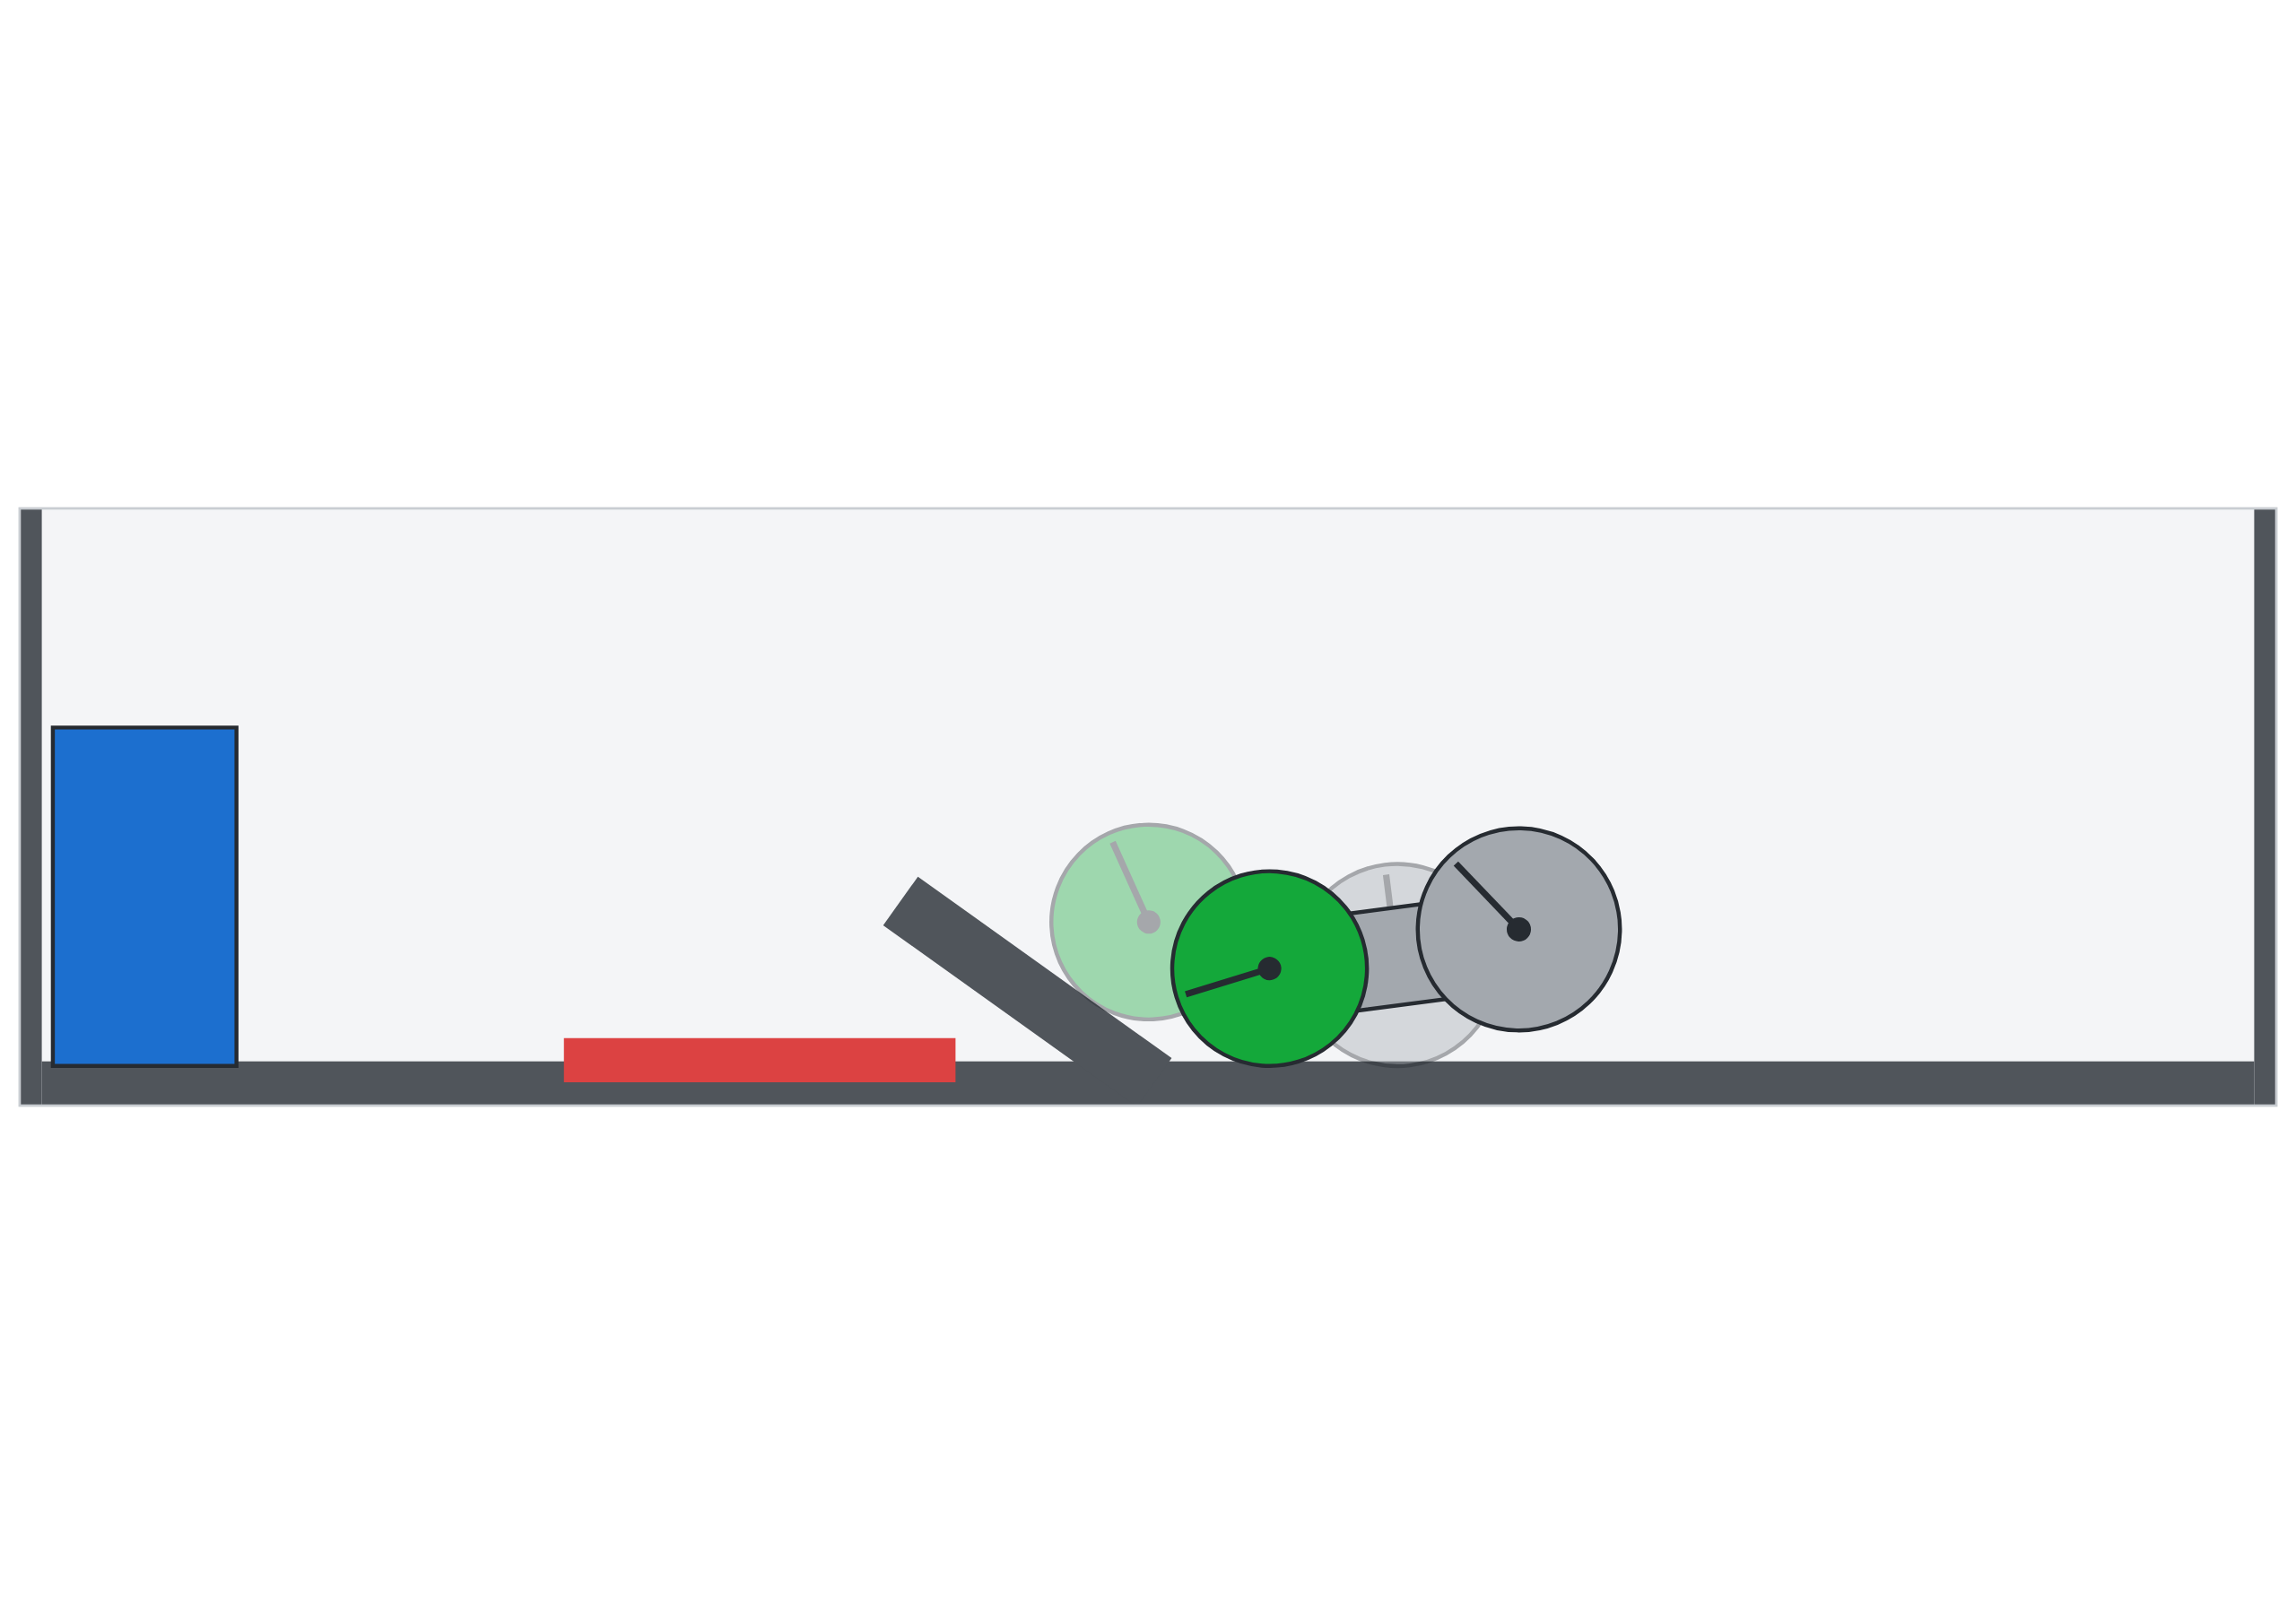
Der Blog unterteilt die Fähigkeiten in drei Bereiche: Gewichte lesen, Gewichte anpassen und Gewichte von Grund auf neu schreiben. In kleinen Netzwerken kann Astra allein anhand der Gewichte erkennen, welches Spiel das Strategie-Netzwerk gerade spielt; es kann die Strategie eines auf einer Steigung festgefahrenen Autos mit einem Klick so anpassen, dass es weiterkommt; und es kann auf MinAtar ein Netzwerk von Grund auf neu schreiben, das bereits 100 Millionen PPO-Schritte absolviert hat. Bei einigen dieser Experimente werden die Gewichte tatsächlich „als Text in einen Kontext eingefügt“, während andere bereits eine Python-Sandbox und eine begrenzte Anzahl von Vorwärtsdurchläufen zulassen.
Auf die Größenordnung von Sprachmodellen bezogen ändern sich die Regeln. Ob es nun darum geht, die schmeichlerische Gemma zu erkennen oder mathematische Bearbeitungen für Qwen vorzunehmen – beides ist nicht mehr nur eine reine „Fließkomma-Rechnung“: Man benötigt Python und muss die Vorwärtsberechnung bei Aufmerksamkeitswerkzeugen oder Übungsaufgaben berücksichtigen. Der Autor selbst stellt im weiteren Verlauf klar: Das Qwen-Experiment erlaubt maximal 50 Vorwärtsdurchläufe (Batch-Übungen) und verbietet ausdrücklich das Gradienten-Training.
MATH-Kurs schießt in die Höhe: Das Ende des Zyklus bedeutet nicht, dass eine neue Mathematik eingeführt wird
Beim Starten von „Qwen3.5-0.8B“ warnt das Modell selbst davor, dass es leicht in eine Denk-Schleife geraten kann. Der Autor berichtet: Bei der Baseline erreichten 85 der ersten 96 Antworten im Trainingsdatensatz die Obergrenze von 32.768 Token. Astra verfolgte die Schleife bis zu einer bestimmten Richtung in den MLP-Schichten 15 und 19 und subtrahierte diese Richtung von den jeweils 64 Ausgabespalten pro Schicht, wodurch insgesamt 131.072 Gewichte (0,016 %) geändert wurden.
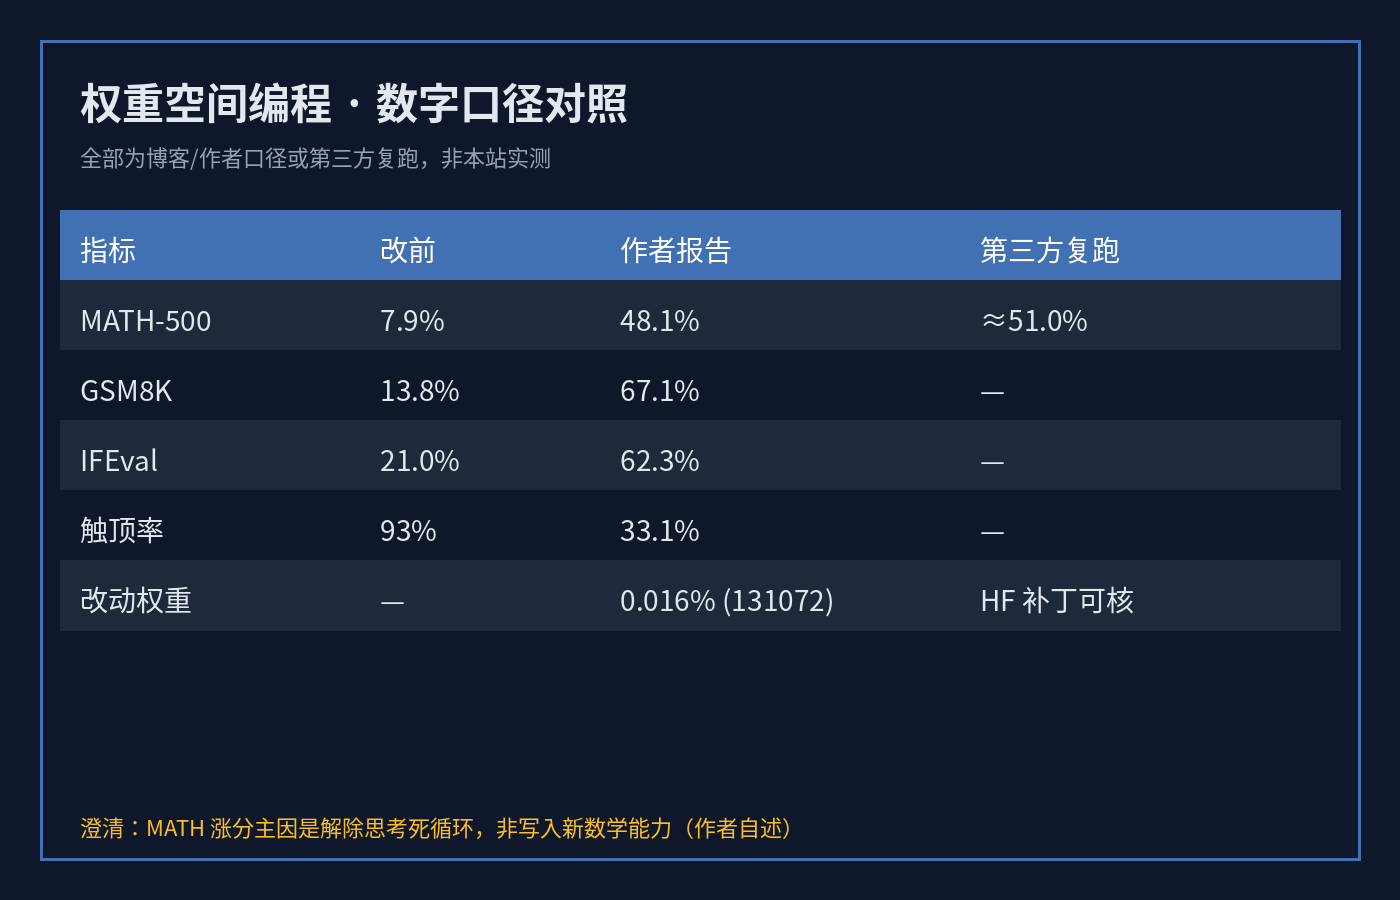
Unter den vom Autor angegebenen Bedingungen und mit derselben Sampling-Einstellung: MATH-500 7,9 % → 48,1 %, GSM8K 13,8 % → 67,1 %, IFEval 21,0 % → 62,3 %, Top-Rate 93 % → 33,1 %. Auf Hugging Face gibt es bereits ein Patch-Repository mit Gewichten und SHA-256; bei einer Wiederholung durch Dritte lag die MATH-500-Ergebnisquote bei etwa 51,0 %. All dies sind Angaben aus Blogs, vom Autor oder aus Wiederholungsversuchen,Keine eigenen Tests dieser Website.
Im selben Artikel gibt es auch einen Vergleich: Bei Gemma 3 270M, das kaum zyklisch arbeitet, bleibt der MATH-Wert bei gleichem Budget nahezu unverändert. Die Schlussfolgerung des Autors lautet – wörtlich zitiert –: Ein Editor kann Hindernisse beseitigen, die bereits vorhandene Fähigkeiten blockieren, aber es ist schwierig, dem Modell Fähigkeiten „einzuschreiben“, über die es ursprünglich nicht verfügt. Dieser Satz ist wichtiger als die grünen Balken auf der Titelkarte.
Warum sagt Honnibal, dass dies irreführend ist?
Matthew Honnibal, der Autor von spaCy, kritisierte in einem Beitrag: Die Zusammenfassung vermischt den Eindruck, dass „nur die ursprünglichen Gewichte betrachtet werden“, mit den nachfolgenden Qwen-Experimenten, die auf Python, Forward-Propagation und Übungsaufgaben basieren, sodass der Leser leicht den Eindruck gewinnen könnte, es handele sich um ein und dieselbe Methode, die das gesamte Spektrum von 17.000 bis 800 Millionen Parametern abdeckt. Seine Vergleichstabelle zeigt sehr deutlich, ob in den einzelnen Experimenten „nackte Gewichte“ gelesen, geschrieben oder das Netzwerk ausgeführt wurde – echte „nackte Gleitkommawerte im Kontext“ beschränken sich hauptsächlich auf kleine Netzwerke mit einigen Zehntausend bis zu einigen Hunderttausend Parametern.
Das bedeutet nicht, dass man das Ganze pauschal ablehnen muss. Die Fähigkeit, die Schleifenrichtung im „Harness“ zu lokalisieren und einen reproduzierbaren Patch bereitzustellen, ist an sich immer noch ein technisches Signal; wenn Marketingtexte jedoch so formuliert werden wie „Große Modelle durchschauen den Gewichtsraum und können mit ein paar kleinen Änderungen Olympiade-Mathematik lösen“, dann geht das zu weit. Auch die Autoren haben bereits eingeräumt, dass der Hauptgrund für die Punktesteigerung bei MATH in der Beseitigung von Endlosschleifen lag, und haben überprüfbare Gewichtsdateien nachgereicht – der Kern der Kontroverse hat sich somit von der Frage „Gibt es das überhaupt?“ hin zu der Frage verschoben, „Wird in der Überschrift ein unterschiedlicher Technologie-Stack als eine Art Zauberei dargestellt?“
Noch eine weitere Ebene an mechanischen Details, um zu vermeiden, dass man sich nur an die grünen Balken erinnert: Der Autor beschreibt, dass die Schleife einer „bestimmten Richtung“ entspricht, die vom MLP wiederholt in den Residualfluss geschrieben wird; die Bearbeitungsaktion ähnelt eher dem Subtrahieren dieser Richtung aus einer bestimmten Ausgabespalte als dem erneuten Trainieren der Aufmerksamkeit oder dem Wechseln des Tokenizers. Erst nachdem die Top-Rate von 93 % auf 33,1 % gesunken war, hatte das Modell die Möglichkeit, die bereits korrekt berechneten Zwischenschritte zu Ende zu berechnen – der Anstieg der Punktzahl ist zu einem großen Teil darauf zurückzuführen, dass „endlich die Arbeit abgegeben wurde“, und nicht darauf, dass plötzlich ein neuer Satz beherrscht wurde.
Protokolle und Gewichtungen wurden veröffentlicht: Der vollständige Dialog, der Code und die Auswertung befinden sich im GitHub-Repository „logs“; das HF-Repository enthält die angepassten Gewichtungen und Prüfsummen, um Dritten die Wiederholung der Berechnungen zu erleichtern. Für Hochschulen oder Teamlabore lautet der minimale Überprüfungsablauf wie folgt: Bei fester Temperatur und „top-p“ sollte zunächst die Top-Rate gemessen und anschließend der MATH-500-Test durchgeführt werden, anstatt sich nur auf ein Vergleichsdiagramm zu konzentrieren und dieses weiterzuleiten.
Die Hauptanweisung „Das Modell soll besser in Mathematik werden“ ist an sich sehr kurz; anschließend wurde sie von Tools wie Claude Code zu „harness“ erweitert – dies ist auch einer der strittigen Punkte: Der Titel lässt leicht den Eindruck entstehen, dass Astra allein „800 Millionen Gewichte verstanden“ habe, tatsächlich handelt es sich jedoch um eine Engineering-Sitzung mit Tools und einem Budget für Übungsaufgaben. Die Formulierung „Prompt-Engineering + Gewichtsanpassung“ ist genauer als „Hellsehen“.
One More Thing: Getrennt von den Nachrichten zur Astra-Beta-Testphase
Auf der Website taucht außerdem kurz die Codex-Nutzung auf gpt-6.2-astra Tracking von A/B-Tests; das ist der Produktverfügbarkeits-Radar. Das in diesem Artikel erwähnte „Astra“ ist ein Objekt aus dem Forschungsblog, das zur Veranschaulichung des Lesens und Schreibens von Gewichtungen dient. Beide Seiten können real sein, doch die Aufgaben der Leser sind völlig unterschiedlich: Die eine entscheidet darüber, ob Sie die Modell-ID ändern oder nicht, die andere darüber, ob Sie glauben, dass „eine Änderung der Gewichtung um 0,016 % gleichbedeutend ist mit dem Erlernen der Mathematik“.
So können Sie dies selbst überprüfen: Sehen Sie sich zunächst die Tabelle mit den Versuchseinstellungen im Blog des Autors an, wenden Sie dann den HF-Patch auf SHA-256 an und führen Sie schließlich den MATH-500-Test bzw. die Maximalratenmessung mit derselben Stichprobe erneut durch. Das ist weitaus hilfreicher als das Weiterleiten eines Screenshots mit der Angabe „6-fach“.
Unsere Einschätzung:Die Aussage „6-facher Anstieg“ sollte in „Rückkehr zum ursprünglichen Niveau nach Beseitigung der Zyklushürde + unabhängig überprüfbarer Gewichts-Patch“ umformuliert werden. Weight-Space Programming ist als Forschungsrichtung durchaus verfolgenswert, aber bitte führen Sie „das Auslesen der Gewichte aus kleinen Netzwerken“ und „die Anpassung großer Modelle mithilfe von Tools“ in zwei getrennten Spalten auf; trennen Sie dies vollständig von den Nachrichten zur Beta-Testphase von Codex 6.2 Astra, um zu vermeiden, dass zwei verschiedene Themen in einem Artikel gegenseitig beschönigt werden.
Weiterführende Links
- Rikiya Takehi et al.: „Sparks of Weight-Space Programming“
- HF: Qwen 3.5-0.8B – Patch für das „Weight-Space-Programming“-Verfahren
- Matthew Honnibal: Der Artikel über „Astra read/write“ wird als irreführend bezeichnet
- QuantumBit-Themenradar (maßgeblich sind die Angaben im Blog des Autors)


评论列表 (0条):
加载更多评论 Laden...