


BLOG / 05.11.2026
Vários autores do MIT CSAIL destacaram um artigo de blogue:Programação do Espaço de Peso——Utilizar um modelo geral de grande escala para ler, alterar e até mesmo escrever do zero os pesos de uma rede neural. A imagem mais impressionante na apresentação foi esta: o Qwen3.5-0.8B melhorou a pontuação no MATH-500 de 7,9% para 48,1%, tendo alterado apenas 0,016% dos pesos.
A comunidade de língua chinesa interpretou rapidamente isto como «um aumento vertiginoso de 6 vezes; o modelo de repente sabe matemática». O diário do autor e os testes repetidos por terceiros, na verdade, referem-se a outra questão: primeiro, eliminar o ciclo vicioso de pensamento; depois, libertar o potencial que o modelo já possuía, mas que estava a ser sufocado pelo ciclo. E o artigo publicado hoje no site sobre o teste beta do Codex 6.2 AstraNão é, de todo, uma notícia——Este artigo aborda a investigação do MIT sobre a utilização do GPT-6 Astra para ajustar os pesos de modelos mais pequenos.
Redefinir «aumento de 6 vezes» para «recuperação do nível original após a resolução do problema de ciclo + correção de ponderação verificável de forma independente».
Afinal, o que é que eles demonstraram?
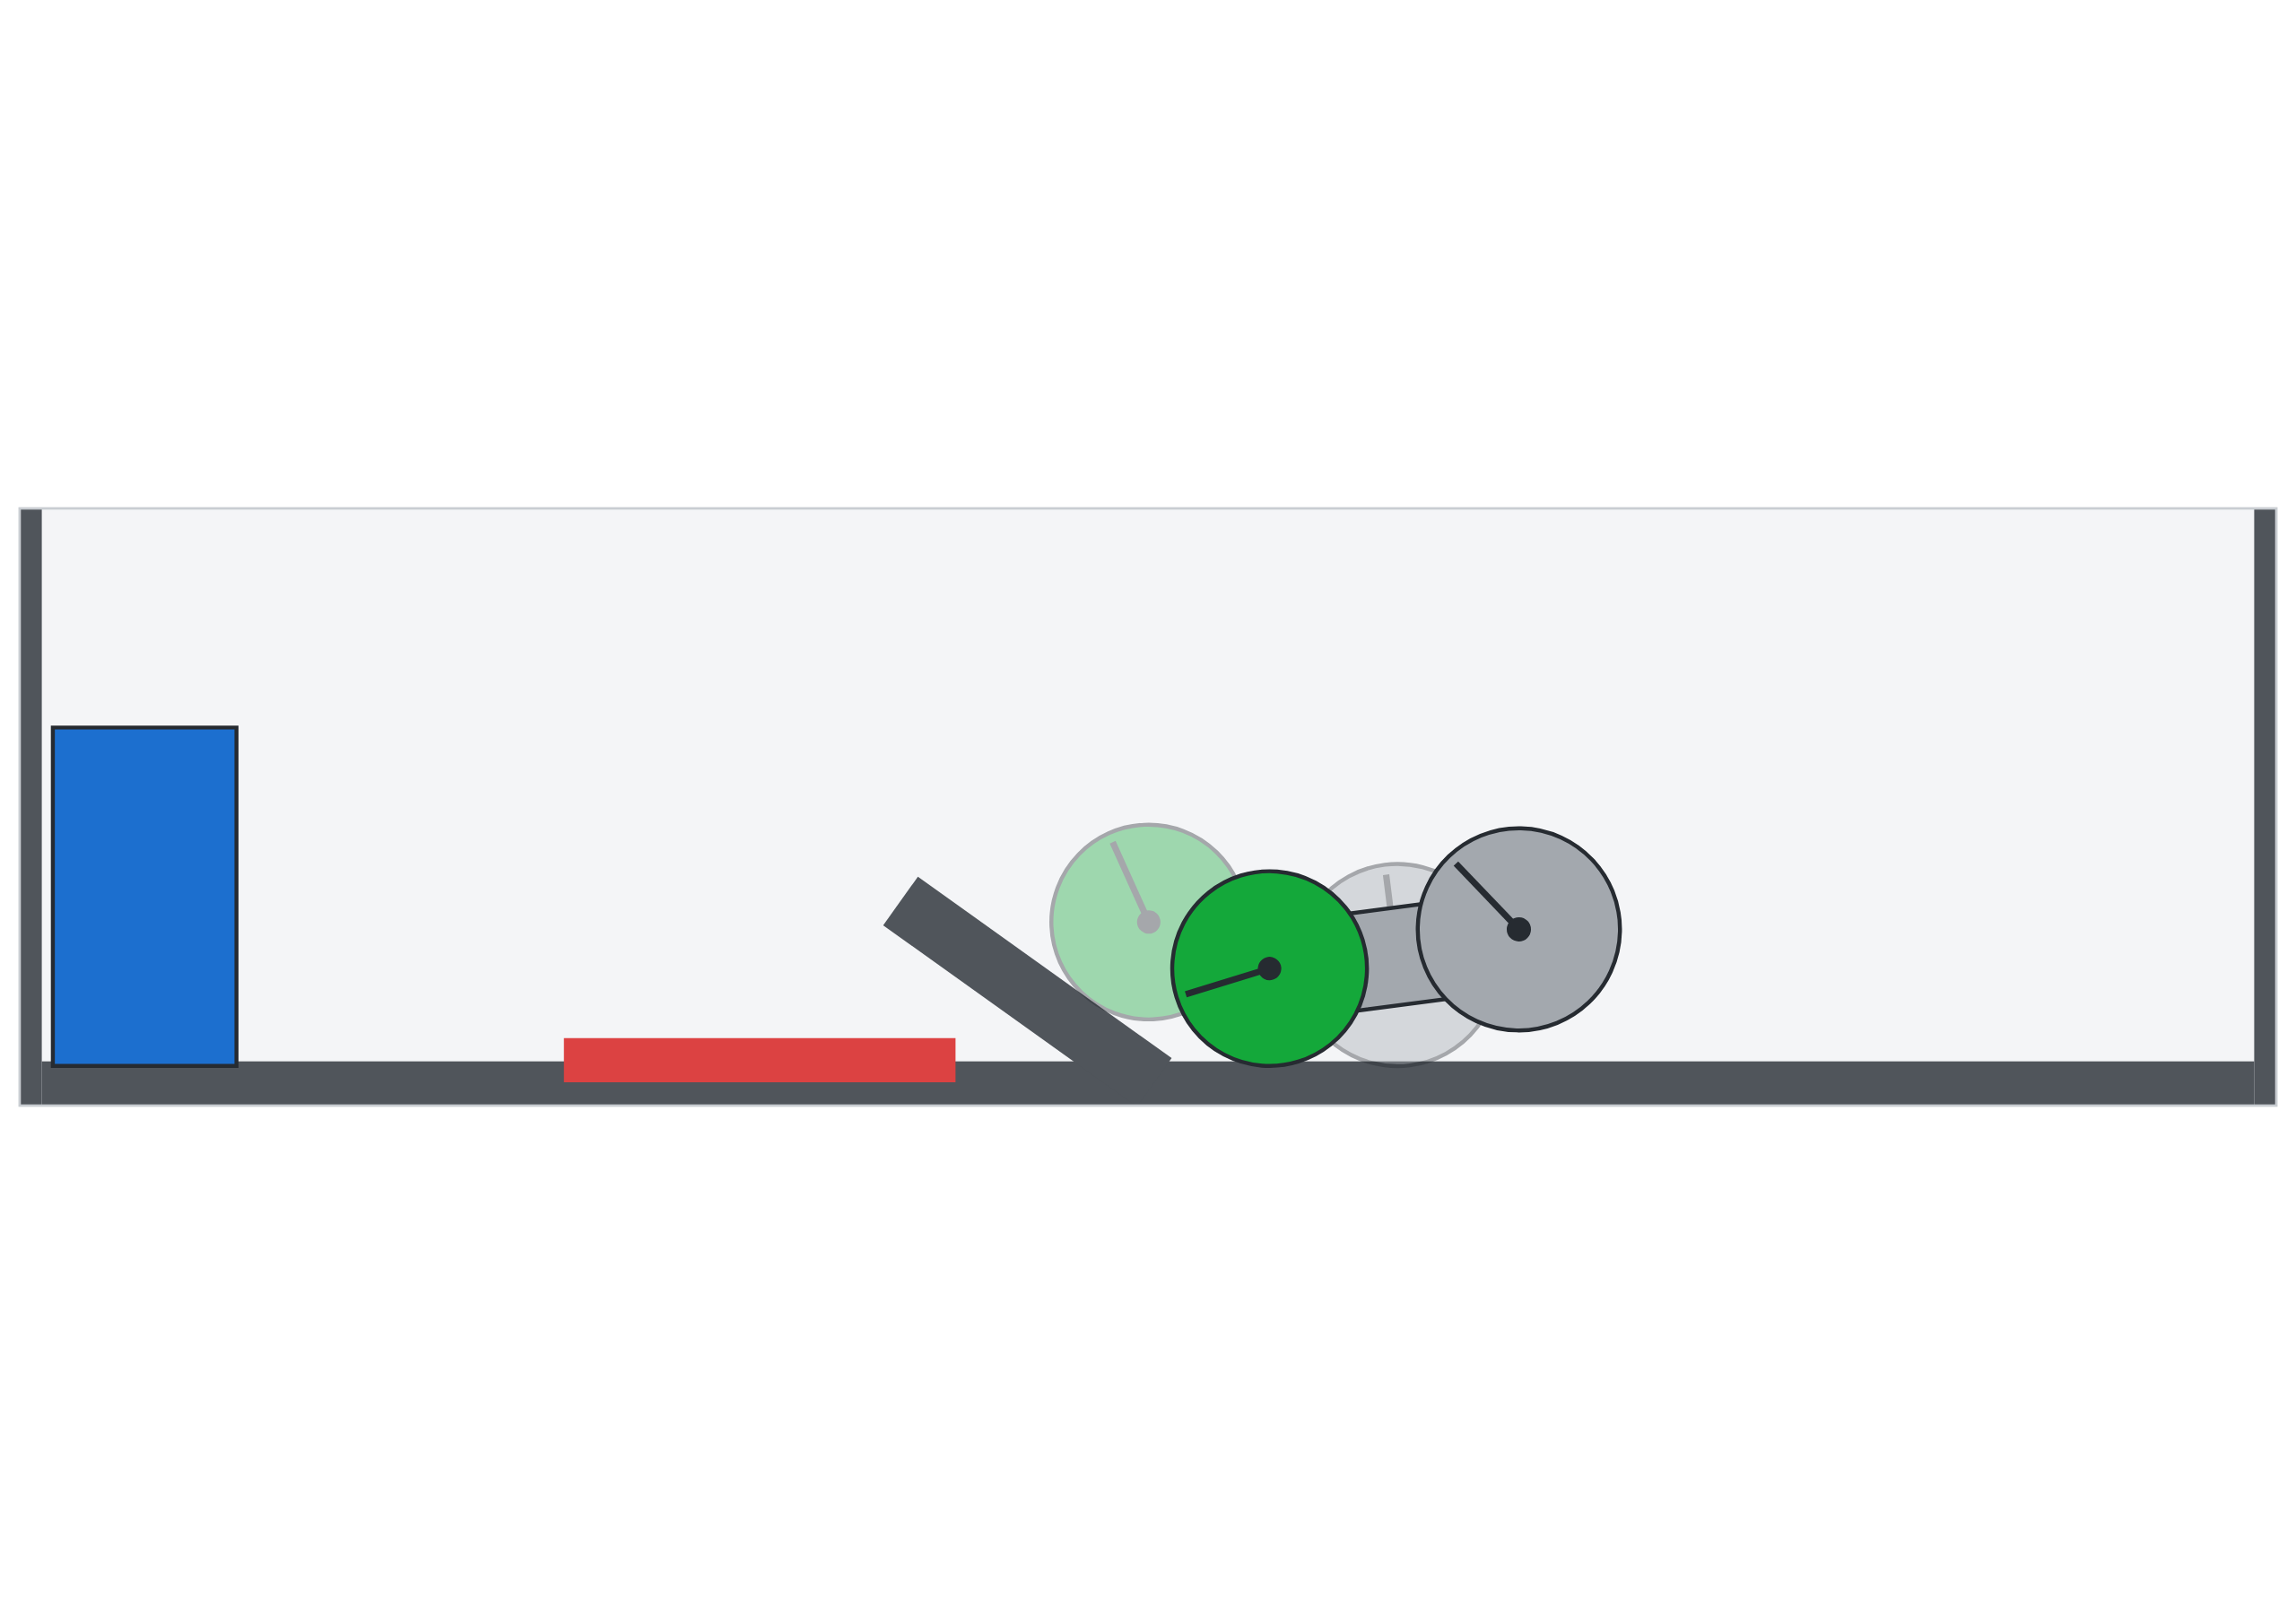
O blogue divide as capacidades em três pontos: ler pesos, ajustar pesos e escrever pesos a partir do zero. Em redes pequenas, o Astra consegue identificar, apenas observando os pesos, qual o jogo que a rede de estratégia está a jogar; consegue, com um único clique, ajustar a estratégia de um carro preso numa inclinação para que consiga passar; e ainda consegue criar, no MinAtar, a partir do zero, uma rede que já jogou 100 milhões de passos no PPO. Nestas experiências, algumas consistem realmente em «inserir os pesos como texto num contexto», enquanto outras já permitem a utilização de uma sandbox Python e um número limitado de passagens em sentido direto.
Quando se trata de modelos linguísticos de grande escala, as regras mudam. Identificar a bajulação na Gemma ou fazer edições de caráter matemático no Qwen já não se resume a «analisar apenas os números de ponto flutuante»: é necessário saber Python e ter em conta o orçamento de avanço nas ferramentas de atenção ou nos exercícios. O próprio autor esclarece mais adiante: a experiência com o Qwen permite um máximo de 50 iterações de pré-treino (exercícios em lote) e proíbe expressamente o treino por gradientes.
MATH dispara: o fim do ciclo não significa necessariamente a introdução de uma nova matemática
Quando o Qwen3.5-0.8B entra em «pensamento», o próprio modelo avisa que é fácil entrar num ciclo de reflexão. Os autores relatam que, no conjunto de treino, 85 das 96 primeiras respostas da linha de base atingiram o limite máximo de 32 768 tokens. O Astra localizou o ciclo numa determinada direção das camadas 15 e 19 da MLP, subtraindo essa direção das 64 colunas de saída de cada camada, o que resultou na alteração de 131 072 pesos (0,016%).
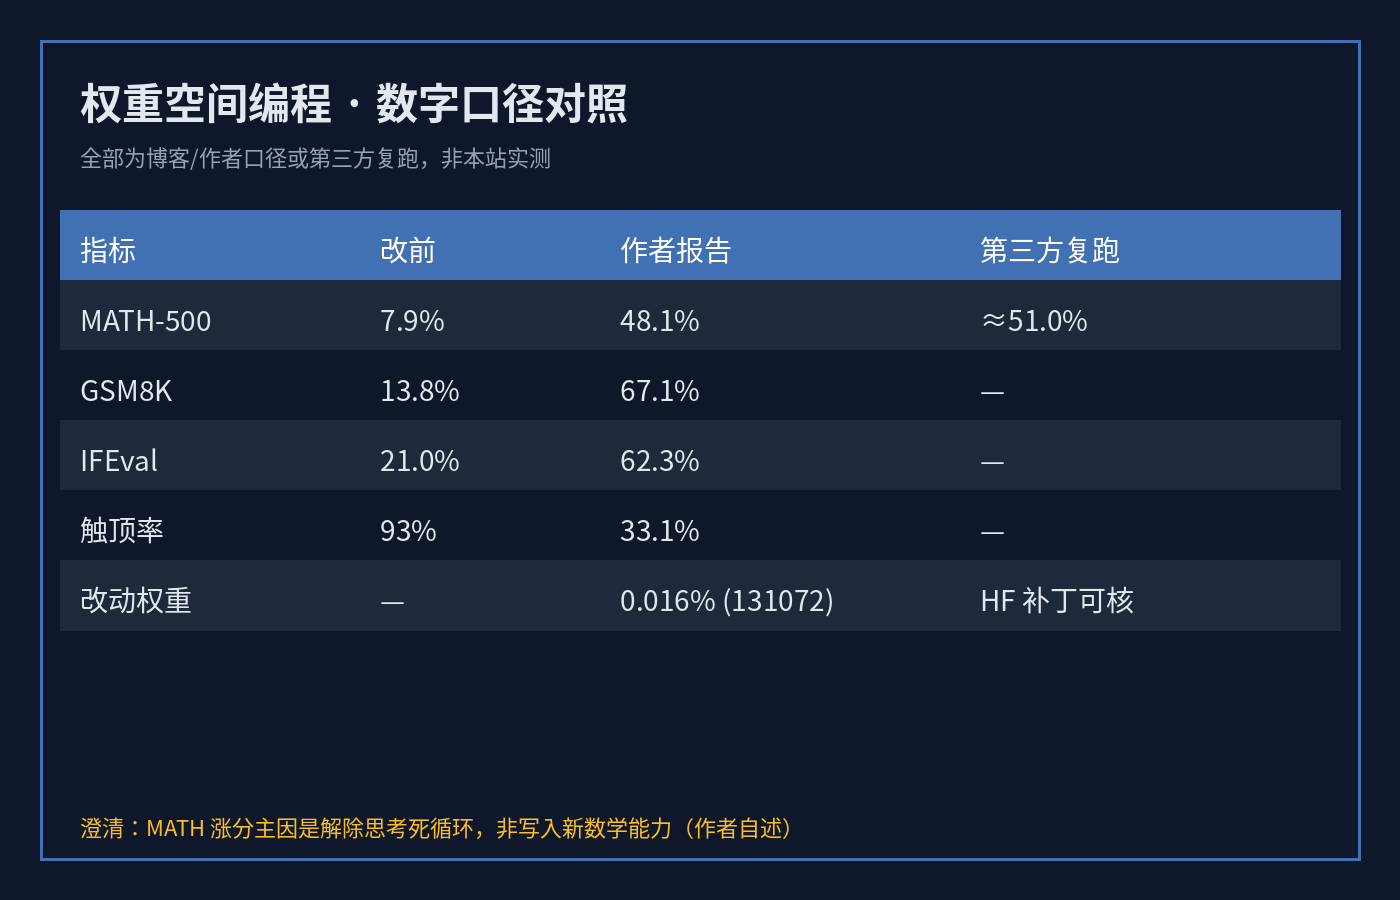
De acordo com os dados do autor e com a mesma configuração de amostragem: MATH-500 7,9% → 48,1%, GSM8K 13,8% → 67,1%, IFEval 21,0% → 62,3%, taxa de atingimento do máximo 93% → 33,1%. Já existe no Hugging Face um repositório de patches com pesos e SHA-256; uma repetição do teste do MATH-500 por terceiros atingiu cerca de 51,0%. Todos estes dados provêm de blogs, do autor ou de repetições do teste,Não se trata de um teste realizado por este site.
No mesmo artigo há também uma comparação: o Gemma 3 270M, que quase não apresenta variações, enquanto o MATH permanece praticamente inalterado com o mesmo orçamento. A conclusão, nas palavras do próprio autor, é a seguinte: os editores podem remover os obstáculos que impedem o aproveitamento das capacidades já existentes, mas é difícil «incorporar» capacidades que o modelo não possui de origem. Esta frase é mais importante do que a coluna verde apresentada no cartão do título.
Por que é que o Honnibal diz que é «misleading»?
Matthew Honnibal, autor do spaCy, publicou um texto de crítica: o resumo mistura a ideia de «analisar apenas os pesos originais» com a experiência do Qwen, que se baseia em Python, na propagação para a frente e em exercícios práticos, o que leva o leitor a pensar facilmente que foi a mesma abordagem que abrangeu todo o espectro, desde 17 mil parâmetros até 800 milhões de parâmetros. A sua tabela comparativa indica claramente se cada experimento lê pesos «a nu», se grava pesos e se executa a rede — os casos em que se utiliza verdadeiramente «pontos flutuantes a nu em contexto» limitam-se principalmente a redes pequenas, com entre algumas dezenas de milhares e mais de cem mil parâmetros.
Isto não significa uma negação total. Conseguir identificar a direção do ciclo no «harness» e apresentar um patch reproduzível continua a ser, por si só, um sinal de competência técnica; mas se o slogan de marketing for formulado como «os grandes modelos têm uma perceção sobrenatural do espaço de pesos e, com apenas algumas alterações, conseguem resolver problemas de matemática avançada», isso já ultrapassa os limites. O próprio autor já admitiu que a principal razão para o aumento da pontuação do MATH foi a eliminação de ciclos infinitos e a inclusão de ficheiros de pesos verificáveis — o foco da controvérsia passou de «isso aconteceu ou não» para «se o título apresenta diferentes pilhas tecnológicas como se fossem um único tipo de magia».
Mais um pormenor sobre o mecanismo, para evitar que nos lembremos apenas da coluna verde: o autor descreve que o ciclo corresponde a «uma determinada direção» que é repetidamente inserida pelo MLP no fluxo residual; a ação de edição assemelha-se a subtrair essa direção de uma coluna de saída específica, em vez de retreinar a atenção ou mudar o tokenizador. Só depois de a taxa de estagnação ter descido de 93% para 33,1% é que o modelo teve a oportunidade de concluir os passos intermédios que já tinha calculado corretamente — o aumento da pontuação deve-se, em grande parte, ao facto de «ter finalmente concluído o trabalho», e não a uma súbita compreensão de um novo teorema.
Os registos e os pesos foram divulgados: o diálogo completo, o código e a avaliação encontram-se no repositório de registos do GitHub; o repositório HF disponibiliza os pesos revistos e a soma de verificação, facilitando a repetição do processo por terceiros. Para as escolas ou laboratórios de equipas, o caminho mínimo para a verificação é o seguinte: temperatura fixa e top-p; testar primeiro a taxa de atingimento do limite máximo e, em seguida, o MATH-500, em vez de se limitar a partilhar apenas um gráfico de barras comparativo.
A sugestão principal «Tornar o modelo mais competente em matemática» é, por si só, extremamente curta, tendo sido posteriormente expandida por ferramentas como o Claude Code — o que constitui também um dos pontos de controvérsia: o título pode facilmente levar a pensar que foi o Astra, por si só, que «compreendeu 800 milhões de pesos»; na realidade, trata-se de uma sessão de engenharia que envolveu ferramentas e um conjunto de exercícios. Descrever isto como «engenharia de prompts + edição de pesos» é mais preciso do que referir-se a «comunicação com o além».
One More Thing: separar das notícias sobre o teste beta do Astra
No site, também apareceu rapidamente uma referência ao uso do Codex gpt-6.2-astra Rastreio de testes cinzentos; trata-se do «Radar de Disponibilidade do Produto». O «Astra» mencionado neste artigo é um objeto de referência do blogue de investigação, utilizado para demonstrar a leitura e escrita de pesos. Ambos podem ser reais, mas as tarefas do leitor são completamente diferentes: uma determina se deve ou não alterar o ID do modelo, e a outra determina se deve ou não acreditar que «alterar 0,016% dos pesos = aprender matemática».
Para verificar por si próprio: consulte primeiro a tabela de configurações experimentais no blogue do autor, aplique depois o patch HF ao sha256 e, por fim, execute novamente o MATH-500 / taxa de atingimento do limite máximo com a mesma amostragem. É muito mais útil do que partilhar uma captura de ecrã com «6 vezes».
A nossa opinião:Redefinir «aumento de 6 vezes» como «recuperação do nível original após a resolução de obstáculos cíclicos + correção de pesos verificável de forma independente». A «Weight-Space Programming» é uma área de investigação que vale a pena acompanhar, mas por favor, separe em duas secções distintas a «leitura direta dos pesos da rede pequena» e a «modificação de modelos grandes com ferramentas»; separe completamente esta informação das notícias sobre o teste beta do Codex 6.2 Astra, para evitar que dois assuntos diferentes se justifiquem mutuamente num único artigo.
Links de referência
- Rikiya Takehi e outros: Sparks of Weight-Space Programming
- HF: Patch para o Qwen 3.5-0.8B - programação de treino com pesos
- Matthew Honnibal: Artigo sobre a leitura e escrita no Astra é acusado de ser enganador
- Radar de Temas da QuantumBit (as informações oficiais encontram-se no blogue do autor)


评论列表 (0条):
加载更多评论 Carregando...