


BLOG / 5 novembre 2026
Plusieurs auteurs du CSAIL du MIT ont mis un article de blog en avant :Programmation « Weight-Space »——Utiliser un grand modèle général pour lire, modifier, voire écrire à partir de zéro les poids d’un réseau neuronal. L'image la plus frappante de la diapositive est la suivante : le score de Qwen3.5-0.8B au test MATH-500 est passé de 7,9 % à 48,1 %, en ne modifiant que 0,016 % des poids.
La communauté chinoise l’a très vite interprété comme « une explosion de 6 fois, le modèle sait soudain faire des maths ». Le journal de l’auteur et les tests effectués par des tiers évoquent en réalité autre chose : il s’agit d’abord de mettre fin à la boucle de réflexion sans issue, puis de libérer le potentiel dont le modèle disposait déjà, mais qui était étouffé par cette boucle. Et l’article publié aujourd’hui sur le site concernant la bêta de Codex 6.2 Astra…Ce n'est absolument pas une nouvelle——Cet article traite des recherches menées par le MIT sur l'utilisation de GPT-6 Astra pour ajuster les poids des petits modèles.
Revenir d'une « hausse vertigineuse multipliée par 6 » à « un retour au niveau initial après la suppression des obstacles cycliques + un correctif de pondération vérifiable de manière indépendante ».
Qu'ont-ils donc présenté exactement ?
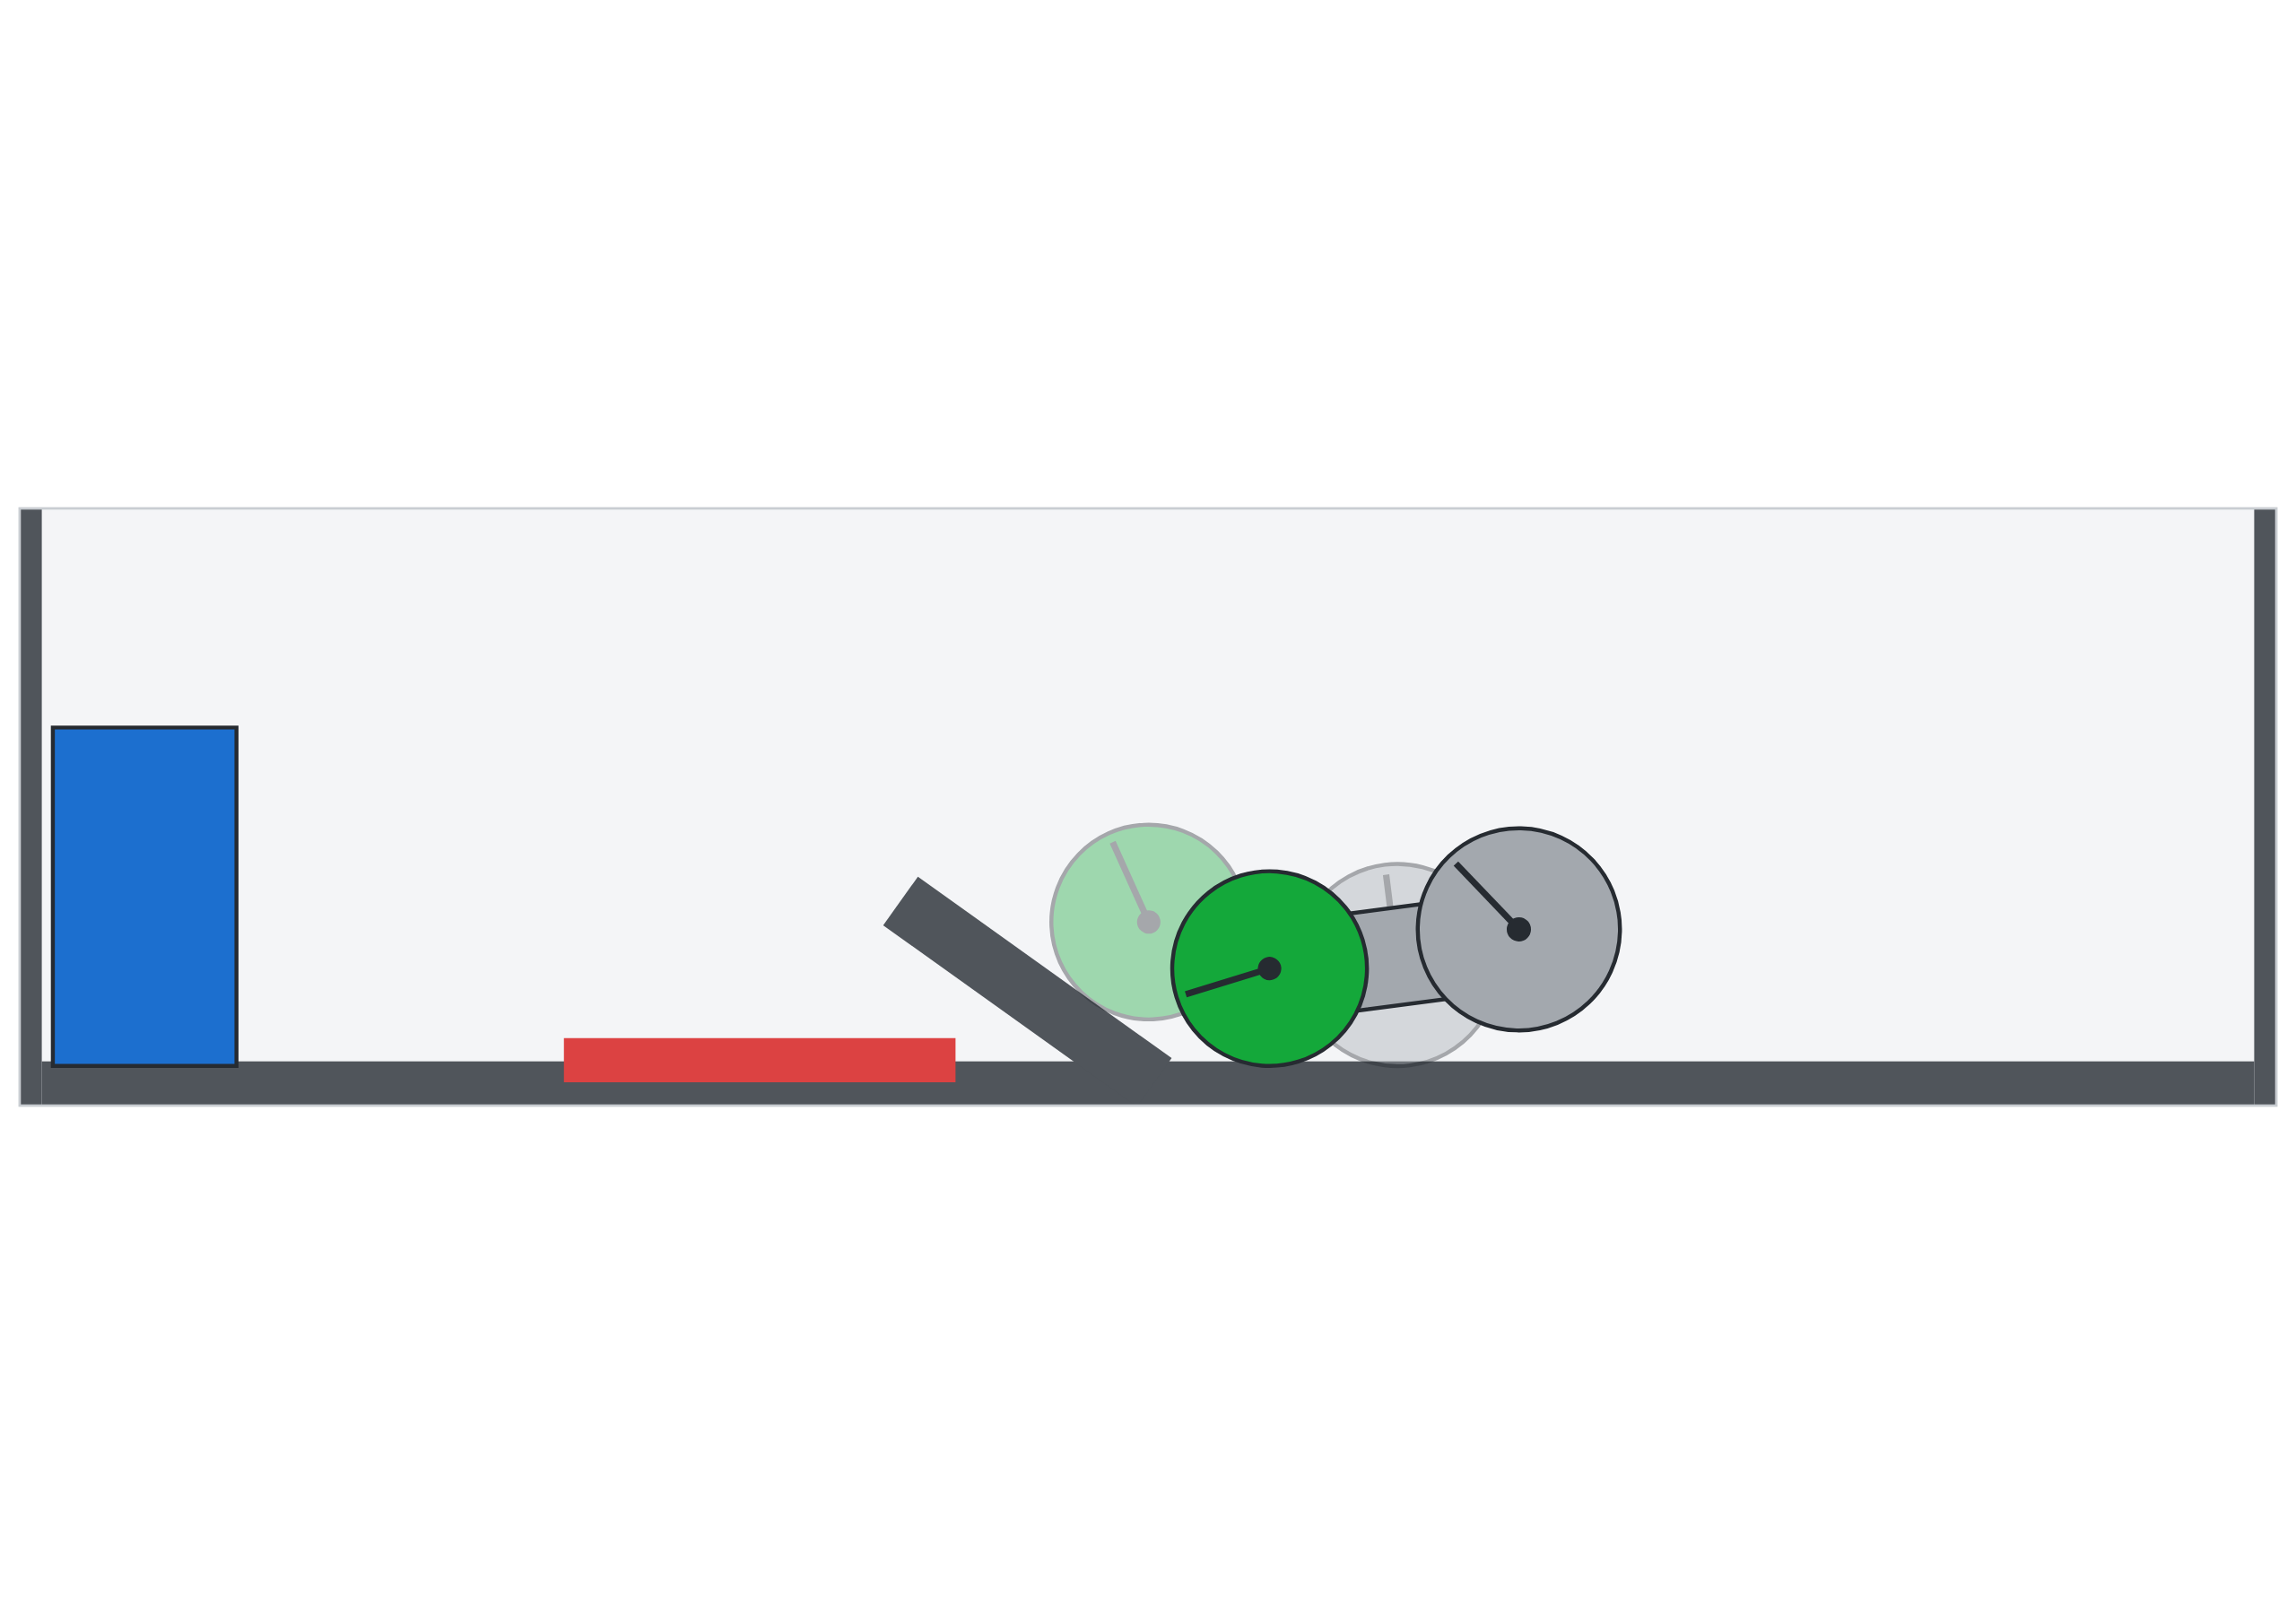
Le blog décompose ces capacités en trois points : lire les poids, modifier les poids et écrire les poids à partir de zéro. Sur de petits réseaux, Astra est capable, en analysant uniquement les poids, de déterminer à quel jeu le réseau de stratégie joue ; il peut modifier d’un simple clic la stratégie d’une petite voiture bloquée sur une pente pour lui permettre de passer ; il peut également créer de toutes pièces, sur MinAtar, un réseau ayant effectué 100 millions de pas en PPO. Parmi ces expériences, certaines consistent véritablement à « insérer les poids comme du texte dans un contexte », tandis que d’autres autorisent déjà l’utilisation d’un bac à sable Python et un nombre limité d’itérations vers l’avant.
À l’échelle des modèles linguistiques, les règles changent. Qu’il s’agisse de détecter la flagornerie avec Gemma ou d’effectuer des modifications mathématiques sur Qwen, il ne s’agit plus de « se contenter d’examiner les nombres à virgule flottante » : il faut utiliser Python et prêter attention aux outils d’attention ou au budget de propagation dans les exercices. L’auteur précise lui-même plus loin dans le texte que l’expérience Qwen autorise au maximum 50 itérations (exercices par lots) et interdit formellement l’entraînement par gradients.
MATH en forte hausse : la fin du cycle ne signifie pas pour autant l'introduction d'une nouvelle mathématique
Lors du lancement de Qwen3.5-0.8B, le modèle a lui-même émis un avertissement indiquant qu’il risquait de se retrouver dans une boucle de réflexion. Les auteurs rapportent que, sur l’ensemble d’entraînement, 85 des 96 premières réponses du modèle de référence ont atteint la limite de 32 768 tokens. Astra a identifié la boucle dans une direction spécifique des couches 15 et 19 du MLP ; en supprimant cette direction parmi les 64 colonnes de sortie de chaque couche, 131 072 poids ont été modifiés au total (0,016 %).
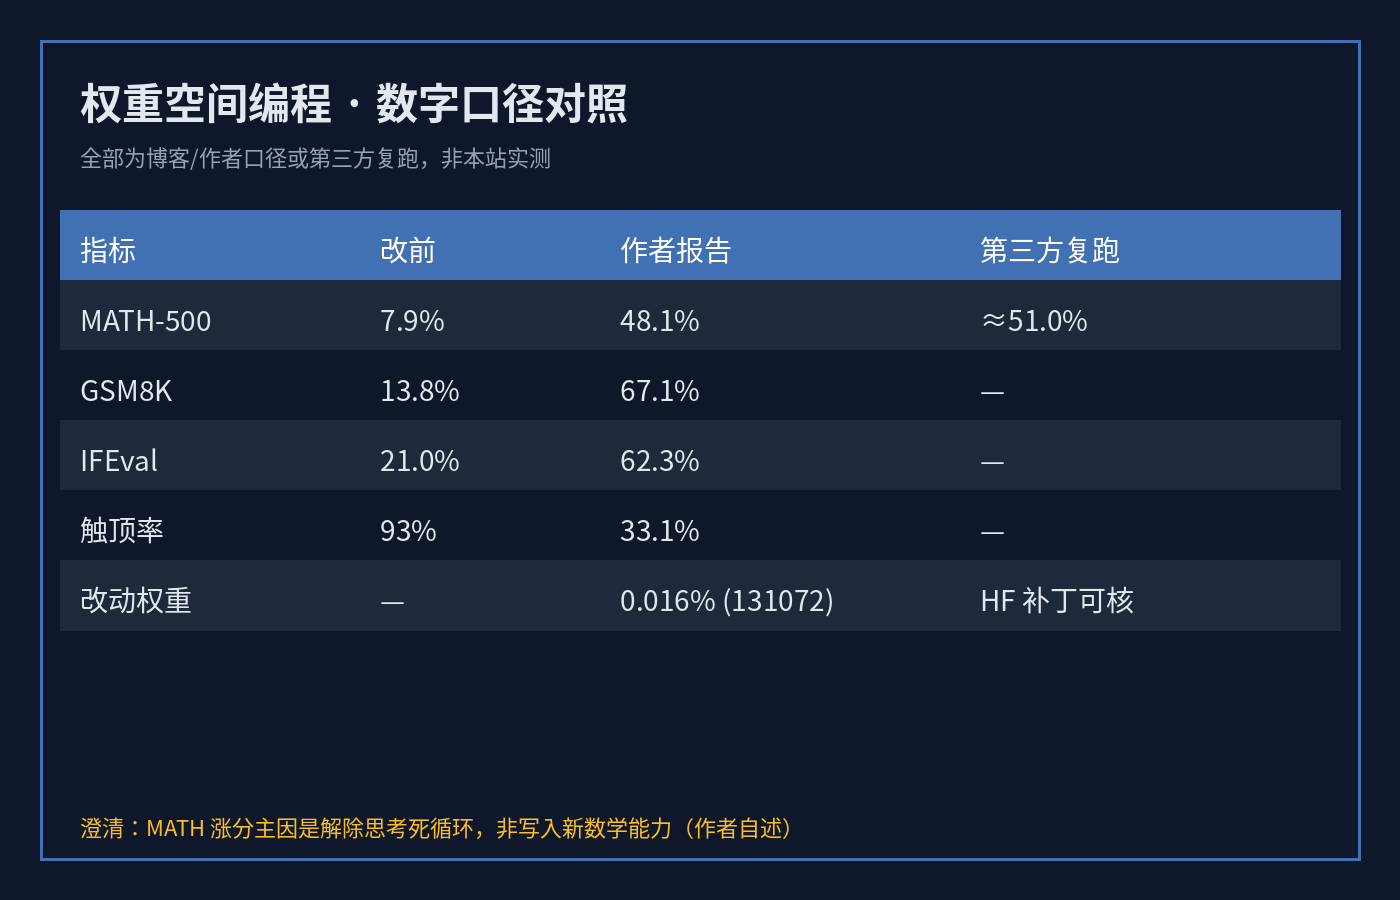
Selon les critères de l'auteur et avec les mêmes paramètres d'échantillonnage : MATH-500 7,9 % → 48,1 %, GSM8K 13,8 % → 67,1 %, IFEval 21,0 % → 62,3 %, taux de pic 93 % → 33,1 %. Il existe déjà sur Hugging Face un dépôt de correctifs comprenant les poids et le hachage SHA-256 ; une reproduction par un tiers du MATH-500 a donné environ 51,0 %. Ces chiffres proviennent respectivement du blog, de l'auteur et de la reproduction,Ce n'est pas le résultat d'un test effectué par ce site.
Le même article présente également une comparaison : Gemma 3 270M, qui ne fait pratiquement pas l’objet de boucles, tandis que MATH reste pratiquement inchangé pour un budget identique. La conclusion, formulée dans les propres mots de l’auteur, est la suivante : les éditeurs peuvent supprimer les obstacles qui entravent les capacités existantes, mais il est difficile d’« insérer » dans le modèle des capacités qu’il ne possède pas à l’origine. Cette phrase est plus importante que les colonnes vertes affichées sur le titre.
Pourquoi Honnibal dit-il que c'est « trompeur » ?
Matthew Honnibal, l'auteur de spaCy, a publié un article critique : le résumé mélange l'idée de « ne considérer que les poids bruts » avec l'expérience Qwen, qui repose sur Python, l'apprentissage direct et des exercices pratiques. Les lecteurs pourraient facilement penser qu'il s'agit d'une seule et même méthode ayant permis de couvrir tout le spectre, de 17 000 paramètres à 800 millions de paramètres. Son tableau comparatif indique clairement pour chaque expérience si les poids bruts sont lus, si les poids sont écrits et si le réseau est exécuté — les expériences véritablement basées sur « des nombres à virgule flottante bruts dans un contexte » se limitent principalement à de petits réseaux comptant entre quelques dizaines de milliers et plus de cent mille paramètres.
Cela ne revient pas à rejeter le projet en bloc. Le fait de pouvoir localiser le sens de la boucle dans le « harness » et de fournir un correctif reproductible reste en soi un signe de rigueur technique ; mais lorsque le slogan marketing affirme que « les grands modèles maîtrisent l’espace des poids et qu’il suffit de les modifier légèrement pour résoudre des problèmes d’Olympiades mathématiques », cela va trop loin. Les auteurs ont d’ailleurs eux-mêmes reconnu que l’amélioration des scores de MATH était principalement due à l’élimination des boucles infinies, et ont fourni des fichiers de poids vérifiables — le cœur de la controverse est ainsi passé de la question « est-ce vrai ou non ? » à celle de savoir « le titre présente-t-il différentes piles technologiques comme s’il s’agissait d’une seule et même forme de magie ? ».
Ajoutons encore quelques détails sur le fonctionnement du mécanisme, afin de ne pas se limiter à retenir uniquement les colonnes vertes : l’auteur décrit que la boucle correspond à une « certaine direction » qui est réitérément intégrée dans le flux résiduel par le MLP ; l’action d’édition s’apparente à une soustraction de cette direction à partir d’une colonne de sortie spécifique, plutôt qu’à un réentraînement de l’attention ou à un changement de tokenizer. Ce n’est qu’après que le taux de plafonnement est passé de 93 % à 33,1 % que le modèle a eu la possibilité de mener à bien les étapes intermédiaires qu’il avait déjà calculées correctement — la hausse du score s’explique en grande partie par le fait qu’il a « enfin rendu sa copie », et non par la maîtrise soudaine d’un nouveau théorème.
Les journaux et les pondérations ont été rendus publics : l'intégralité des échanges, le code et les évaluations sont disponibles dans le dépôt GitHub « logs » ; le dépôt « HF » fournit les pondérations modifiées et les sommes de contrôle, afin de faciliter la reproduction des résultats par des tiers. Pour les universités ou les laboratoires d’équipes, la procédure minimale de vérification est la suivante : à température fixe et avec le top-p, mesurer d’abord le taux d’atteinte du plafond, puis le MATH-500, plutôt que de se contenter de partager un simple graphique à barres comparatif.
La consigne principale « Améliorer les compétences mathématiques du modèle » est en soi très brève ; elle a ensuite été développée par des outils tels que Claude Code — ce qui constitue d’ailleurs l’un des points de controverse : le titre peut facilement laisser croire qu’Astra a « compris à elle seule les 800 millions de poids », alors qu’il s’agit en réalité d’une session d’ingénierie s’appuyant sur des outils et un ensemble d’exercices. Il serait plus précis de la décrire comme de « l’ingénierie des prompts + l’édition des poids » plutôt que comme de la « voyance ».
One More Thing : séparé de l'actualité concernant la bêta d'Astra
On a également aperçu une mention de l'utilisation de Codex ailleurs sur le site gpt-6.2-astra Suivi des tests gris ; il s'agit du « radar de disponibilité des produits ». Dans cet article, « Astra » est un objet appelé dans le blog de recherche, utilisé pour illustrer la lecture et l’écriture des poids. Les deux cas peuvent être réels, mais les objectifs du lecteur sont totalement différents : l’un détermine si vous modifiez ou non l’identifiant du modèle, l’autre détermine si vous croyez ou non que « modifier les poids de 0,016 % = apprendre les mathématiques ».
Pour vérifier par vous-même : consultez d'abord le tableau des paramètres expérimentaux sur le blog de l'auteur, puis appliquez le patch HF à sha256, et enfin relancez MATH-500 / taux de plafonnement avec le même échantillon. C'est bien plus utile que de partager une capture d'écran indiquant un « multipliateur par 6 ».
Notre analyse :Réévaluer la « hausse multipliée par 6 » en « retour au niveau initial après suppression des obstacles cycliques + correctif de pondération vérifiable de manière indépendante ». La programmation dans l'espace des poids (Weight-Space Programming) mérite d'être suivie en tant que domaine de recherche, mais veuillez distinguer clairement dans deux colonnes distinctes la « lecture brute des poids sur un petit réseau » et la « modification de grands modèles à l'aide d'outils » ; séparez complètement cette information de l'actualité concernant la bêta de Codex 6.2 Astra, afin d'éviter que ces deux sujets ne se valident mutuellement dans un même article.
Liens utiles
- Rikiya Takehi et al. : « Sparks of Weight-Space Programming »
- HF : Patch Qwen 3.5-0.8B pour la programmation par poids et par série
- Matthew Honnibal : l'article sur la lecture/écriture d'Astra est jugé trompeur
- Radar des sujets de QuantumBit (les informations sont tirées du blog de l'auteur)


评论列表 (0条):
加载更多评论 Chargement...