



思考模式该不该开满:何时降 effort,何时必须用 max_tokens 封顶?
官方资料解读:不要把思考档位默认开到 xhigh 或 max,先按当前型号的官方建议从中间或默认档起步;effort 是...
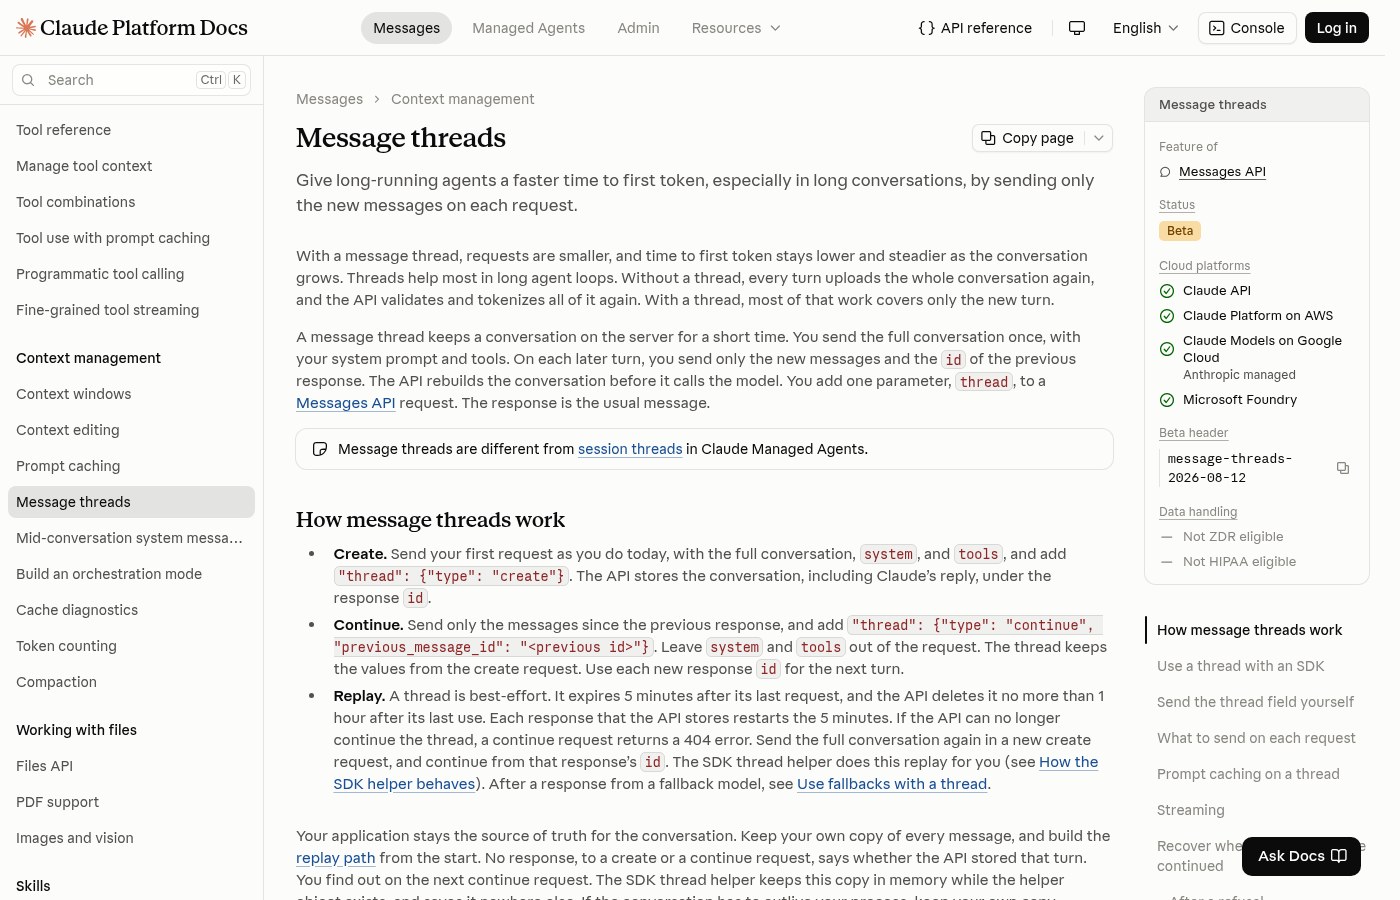
Nach der öffentlichen Testphase von Claude Message Threads: Geringere Latenz oder geringere Kosten?
Auswertung der offiziellen Daten: „Message Threads“ verkürzt vor allem die TTFT (Time to First Thread), ohne die Token-Abrechnung zu ändern; die Kostensenkung hängt weiterhin von den Prompts ab ...
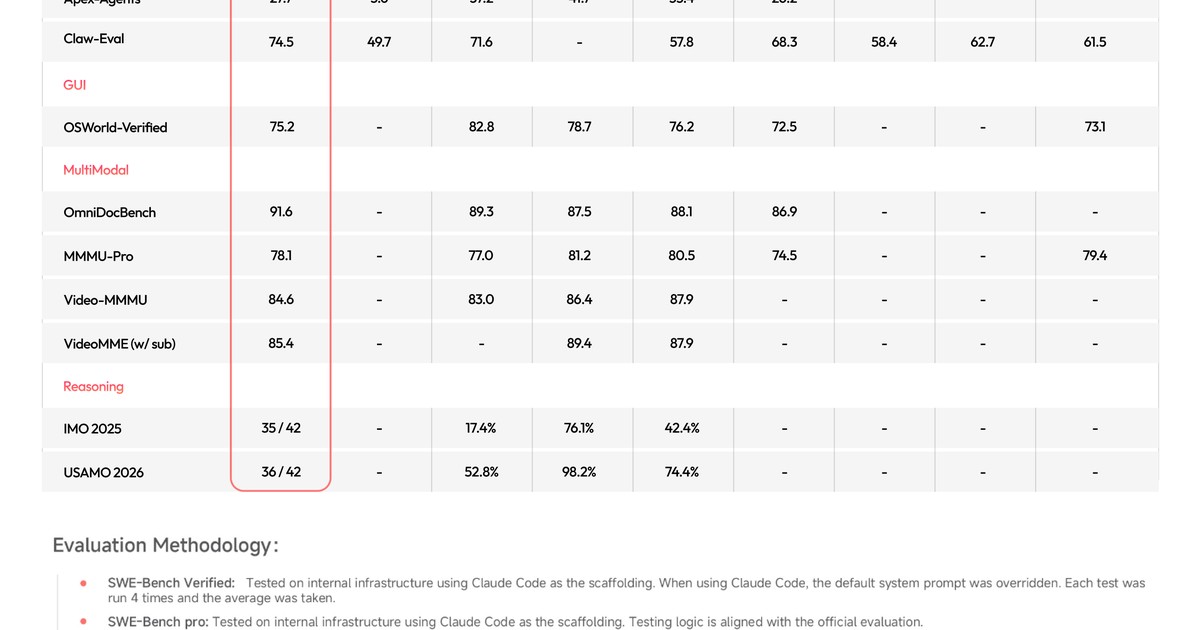
Sollte der Codierungs-Agent nach der Veröffentlichung des MiniMax M3 als Open-Source-Projekt sofort umgestellt werden?
Ein dreidimensionaler Vergleich rund um die Open-Source-Gewichtungen von MiniMax M3: Closed-Source-Modelldateien des Flaggschiffmodells vs. M3-API/Gewichtungsdienst – unter Berücksichtigung der Long-Position-Erfüllungsrate, der Stückkosten und multimodaler Aspekte...
Sollten Agent-Aufträge im Stapelbetrieb sofort auf eine günstigere „computer-use“-Tarifstufe umgestellt werden?
Im Vergleich zu GPT-6.1 Terra: Offizielle Preise – Flaggschiff-Segment vs. kostengünstiges Segment für den Computergebrauch hinsichtlich Fertigstellungsrate, Kosten pro Aufgabe und Fehlerquote...
Bei derselben Aufgabe lege ich zunächst das JSON-Schema fest und kümmere mich erst danach um die Formulierung: So lassen sich die Fehler vor der Veröffentlichung um die Hälfte reduzieren.
Vergleich zwischen freiformatierten Ausgabedaten und vorab festgelegten JSON-Schema-/strukturierten Ausgabedaten; Bezugnahme auf öffentlich zugängliche Praxisstandards; Anhang: Vertrag von heute Abend → Minimal...
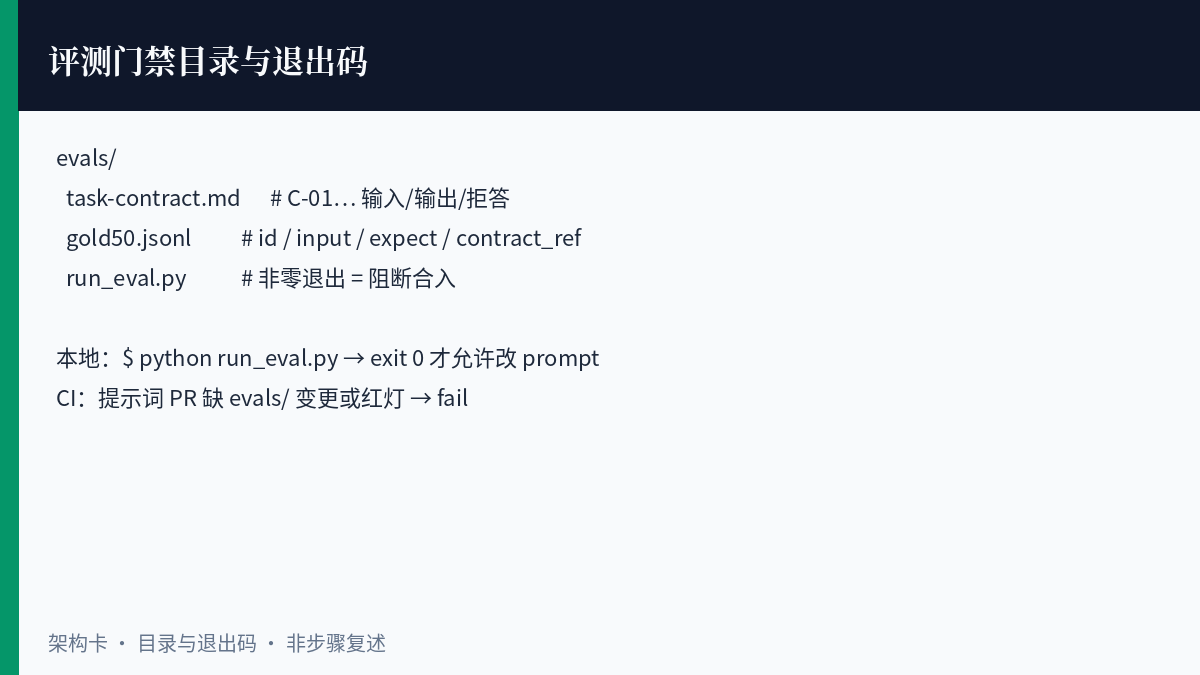
Vor der Veröffentlichung würde ich lieber 50 Testfälle sammeln, die das System zum Absturz bringen, als noch mehr „intelligentere“ Systemaufforderungen einzubauen.
Vergleich der System-Prompts von Stacks mit der Erstellung eines Testdatensatzes mit 50 reproduzierbaren Testfällen; Verweis auf promptfoo / OpenAI Evals ...
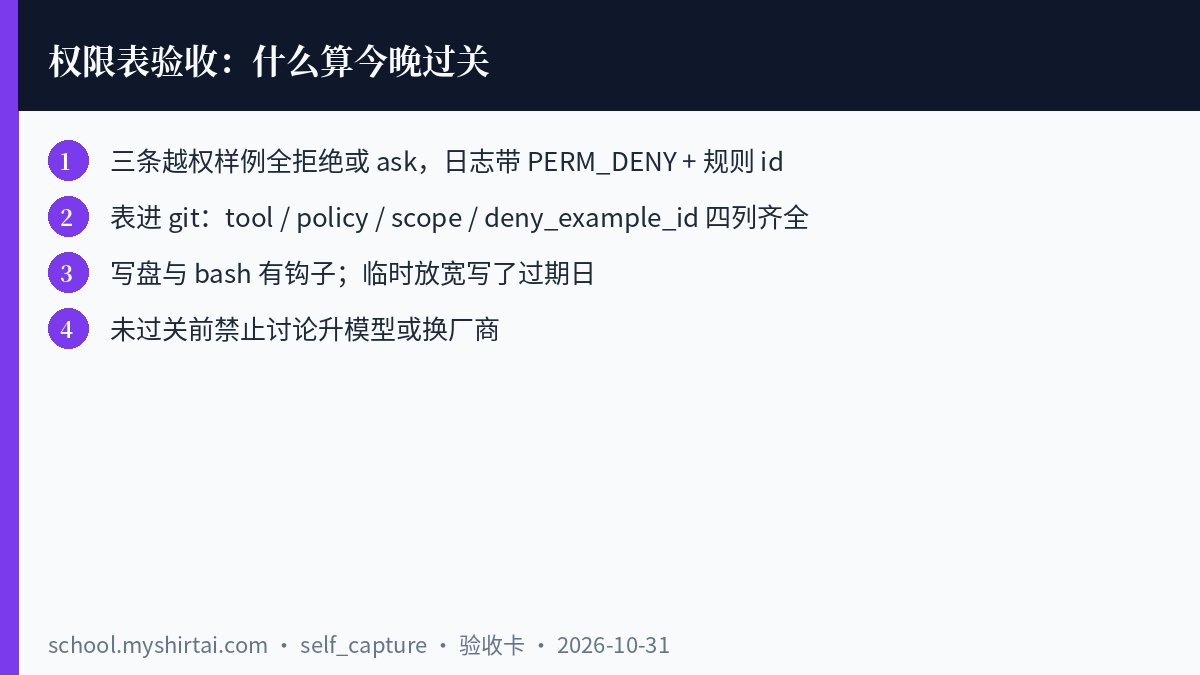
Wenn der Agent wieder einen Fehler macht, überprüfe ich zunächst die Berechtigungen und die Grenzen des Tools, anstatt sofort auf ein größeres Modell umzusteigen.
Vergleich zwischen dem „Escalation“-Modell und der Einschränkung der Whitelist: Nach dem Absturz zunächst die Berechtigungstabelle erstellen, Hooks einbinden und drei Beispiele für Berechtigungsüberschreitungen nachstellen; unter Bezugnahme auf Anthropic / Clau...
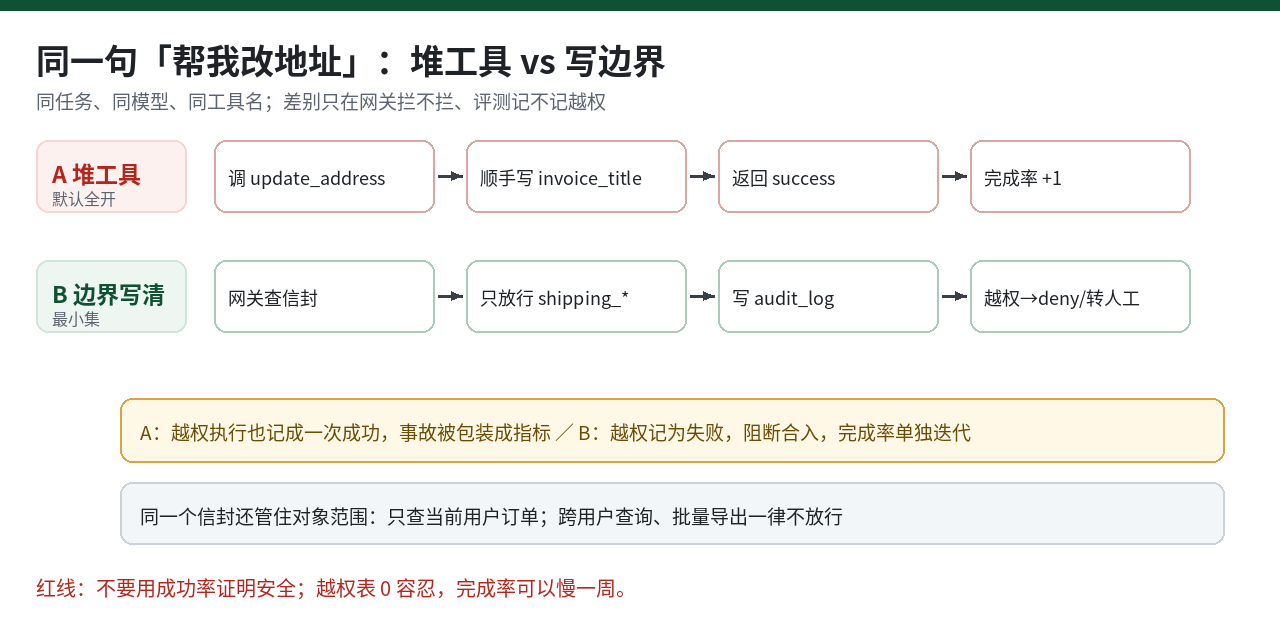
Wenn ein Agent versagt, liegt das meist nicht daran, dass die Werkzeuge nicht ausreichen, sondern daran, dass die Handlungsgrenzen nicht klar definiert sind.
Vergleich: Klar definierte Grenzen vs. Heap-Tools. Die Erfolgsquote ist kein Sicherheitskriterium; heute Abend werde ich die Umschläge vorbereiten und die Tests mit Use-Case-Szenarien, die die Zugriffsgrenzen überschreiten, wiederholen.
Da das Kontextfenster immer größer wird, fange ich stattdessen an, Suchsegmente zu kürzen.
Vergleich: „Vollstopfen“ vs. „Sorgfältiges Aussortieren“. Ein größeres Fenster bedeutet nicht, dass man mehr hineinpacken sollte; heute Abend werde ich eine Version der Suchausschnitte streichen und die Schwelle für die erneute Überprüfung beibehalten.
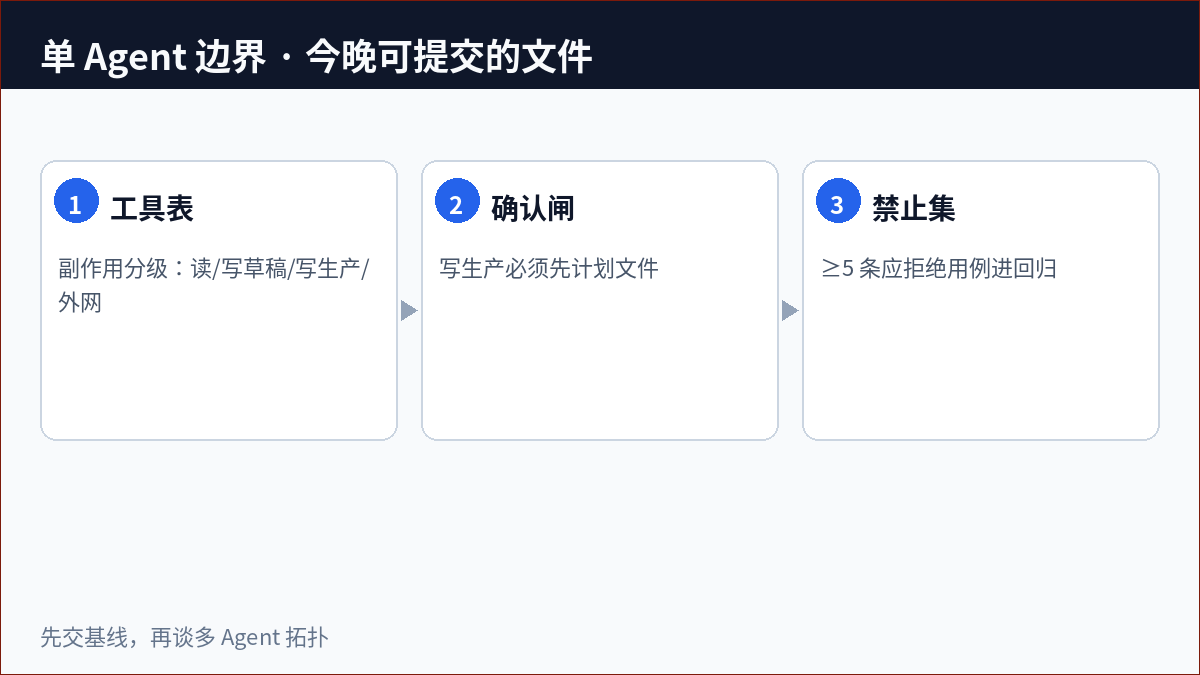
Multi-Agent-Systeme sehen zwar spannend aus, aber ich möchte lieber zunächst die Grenzen des Single-Agent-Tools klar definieren.
Dreiteiliges Set zur Aggregation ausführbarer Grenzen: Tool-Tabelle, Bestätigungsschleuse, verbotene Anwendungsfälle; kann heute Abend eingereicht werden, keine leeren Worte über mehrere Agenten.
Ein langer Kontext ist kein Ersatz für eine strukturierte Wissensdatenbank – je nachdem, ob ich weiterhin auf RAG/Ordner setze oder direkt den vollständigen Text einfüge.
Letzten Freitag habe ich einem Kommilitonen dabei geholfen, die Fragen und Antworten in der Kundendienst-Wissensdatenbank durchzugehen. Er hatte die Support-Tickets der letzten zwei Jahre, die Produkthandbücher und die FAQs alle in ein etwa 200K großes Kontextfenster eingefügt und fragte: „Anmelden...“.
Hör auf, „Skill“, „MCP“, „Project“ und „Custom GPT“ als ein und dasselbe zu betrachten – wähle einfach je nach „Zweck“ aus.
Letzte Woche hat mich wieder jemand mit einer Frage konfrontiert, in der drei Dinge unter einen Hut gebracht wurden: „Soll ich ein Custom GPT erstellen? Oder einen Skill schreiben? Oder ein Projekt starten...
Der Mensch kann sehen, die KI nicht: der wesentliche Unterschied, den das verborgene Herz offenbart
Eine statische Schwarz-Weiß-Rauschkarte offenbart ein dynamisches Herzmuster bei der Betrachtung mit dem Handy oder beim Skalieren der Seite, während KI-Modelle wie Gemini 2.5 Pro, GPT-5 und Beanbag...

Manus und die KI-Agentenblase: Vom Ideal zur Desillusionierung
Manus, als Vertreter des KI-Agenten-Booms im Jahr 2025, stützt sich auf große Modelle, Toolchain und Speichertechnologie, um die Aufgabenerfüllung zu erreichen, aber aufgrund des Mangels an professionellen Szenarien der tiefen Kultivierung und geschlossenen...

Byte Jump XVerse: Eine eingehende Analyse der revolutionären Technologie zur Erzeugung von Bildern aus mehreren Subjekten
Das Team von ByteDance Intelligent Creation hat das Modell XVerse auf den Markt gebracht, das auf der DiT-Architektur basiert und eine unabhängige und präzise Steuerung mehrerer Subjekte in komplexen Szenen ermöglicht, einschließlich Körperhaltung, Stil, Licht...

Eingehende Analyse von Baidu MuseSteamer: ein neuer Meilenstein in der heimischen KI-Videoerzeugung
Das kommerzielle Forschungs- und Entwicklungsteam von Baidu hat MuseSteamer, ein multimodales generatives Makromodell, auf den Markt gebracht, das den weltweit ersten Platz in der graphengenerierten Videoprüfung VBench erreicht hat und Audio und Video auf Chinesisch synchronisiert...

Cursor MCP Server Konfigurationshandbuch und Cursor Practical MCP Recommendations
MCP (Model Context Protocol) ist ein Protokoll, das es großen Modellen ermöglicht, mit externen Werkzeugen und Diensten zu interagieren, Cursor IDE durch...

Google DeepMind AlphaEvolve: Der Aufstieg einer revolutionären kodierten KI-Intelligenz
Google DeepMind hat AlphaEvolve auf den Markt gebracht, eine KI-Kodierintelligenz, die in der Lage ist, selbständig Code zu schreiben und zu optimieren und wissenschaftliche Entdeckungen zu machen. Das System beinhaltet...
