


Quando há uma elevada repetição nos prefixos das rondas de diálogo, do RAG e do agente, o que se desperdiça com mais frequência numa pilha de inferência criada internamente é Cálculo repetido na cache KV.LMCache Colocar o KV fora do motor (CPU / disco / remoto), permitindo que o vLLM, o SGLang e outros o reutilizem com um prefixo partilhado. Este artigo é 05/11/2026 Guia de utilização da versão de verificação de documentos: Ambiente, instalação, pontos-chave para o arranque do daemon e do motor, licenças e restrições. Como não consegui ativar o canal da GPU neste computador, não incluí números comparativos de débito ao longo do texto.
Depois de ler, poderá avaliar
- Devemos ou não implementar o LMCache (se o prefixo é realmente repetido e se suporta uma operação com múltiplos processos)?
- Métodos de ligação recomendados oficialmente pelo vLLM e pelo SGLang, respetivamente
- O que é que ele não consegue fazer (não substitui o modelo, não garante a compatibilidade entre versões do KV, o README ≠ prova de que funciona)
O que resolve e o que não resolve
- É possível fazer:Reutilização de KV entre pedidos/instâncias; colocação de prefixos frequentes na CPU ou em armazenamento remoto; integração com vLLM, SGLang e outros através de conectores oficiais (a documentação indica que, em conjunto com o agendamento centrado em KV, é possível reduzir o TTFT e aumentar a taxa de transferência).
- Não pode ser:Repositório de modelos, descarregador de pesos, avaliador automático; também não se deve considerar que as estrelas do GitHub ou a pré-visualização nas redes sociais significam que «o seu modelo já foi executado com sucesso».
- Licença:O repositório está sujeito à licença Apache-2.0. Antes de qualquer utilização comercial, é necessário verificar por conta própria o ficheiro NOTICE e as licenças das dependências.
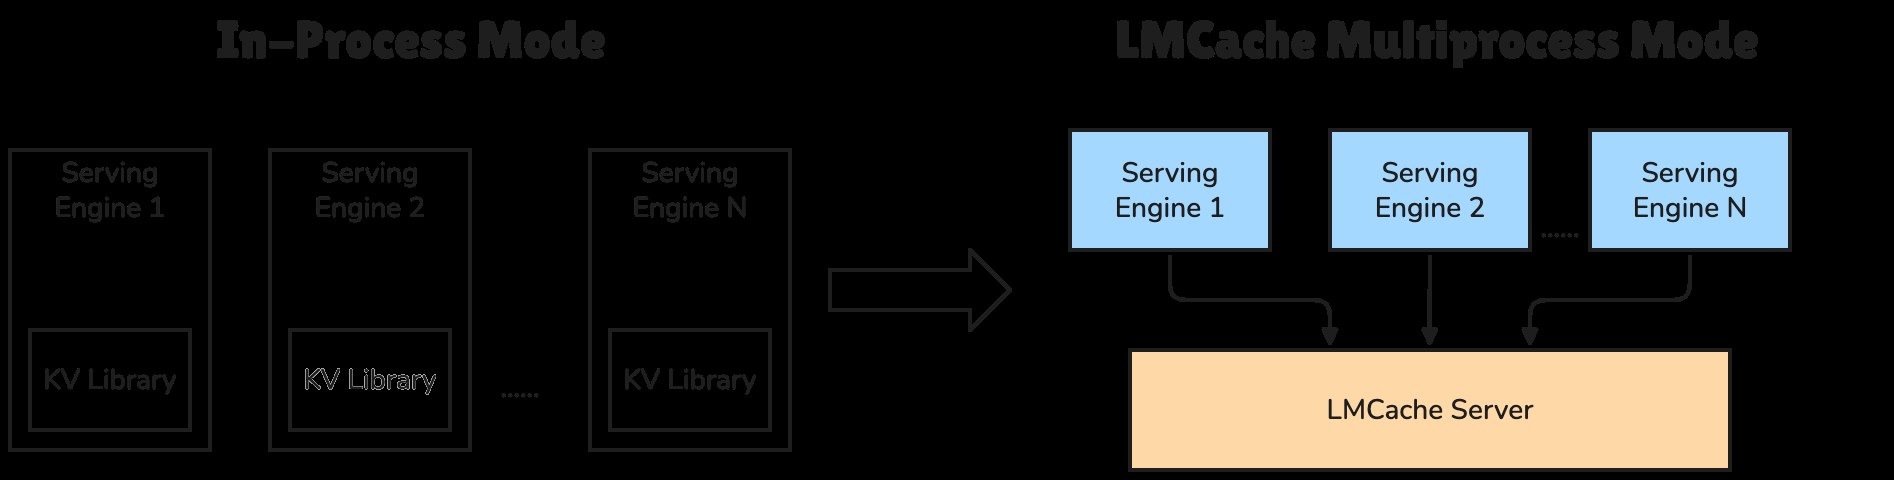
Duas formas de implementação: prioridade ao Multi-process
O guia oficial «Getting Started» divide a implementação em duas categorias:
| Modelo | Como correr | Posição do documento |
|---|---|---|
| Multiprocessos (MP) | Independência servidor lmcache daemon / controlador + conector do lado do motor |
Recomendações: isolamento de falhas, partilha entre vários motores, limites claros de operação e manutenção |
| Em curso | O LMCache está integrado no processo do motor | É leve, mas está acoplado ao ciclo de vida do motor; a documentação do SGLang indica que apenas suporta MP |
No cenário em que «vários trabalhadores/vários motores partilham o mesmo conjunto de pares-chave», siga as instruções da documentação: inicie primeiro servidor lmcache daemon, reiniciar o motor e apontá-lo para o endereço do daemon (no YAML, mp_host/mp_port).
Ambiente e instalação (caminho do documento)
Página de verificação:Instalação. O procedimento habitual consiste na instalação do pacote Python (a versão deve seguir o indicado no PyPI / na documentação do dia em questão; à data da redação deste texto, os exemplos da documentação referiam-se à linha 0.5.x) e em garantir que o conector é compatível com a versão do motor de destino —A matriz de versões deve basear-se na documentação do LMCache e do motor, respetivamente; não se devem utilizar nomes de conectores demasiado antigos.
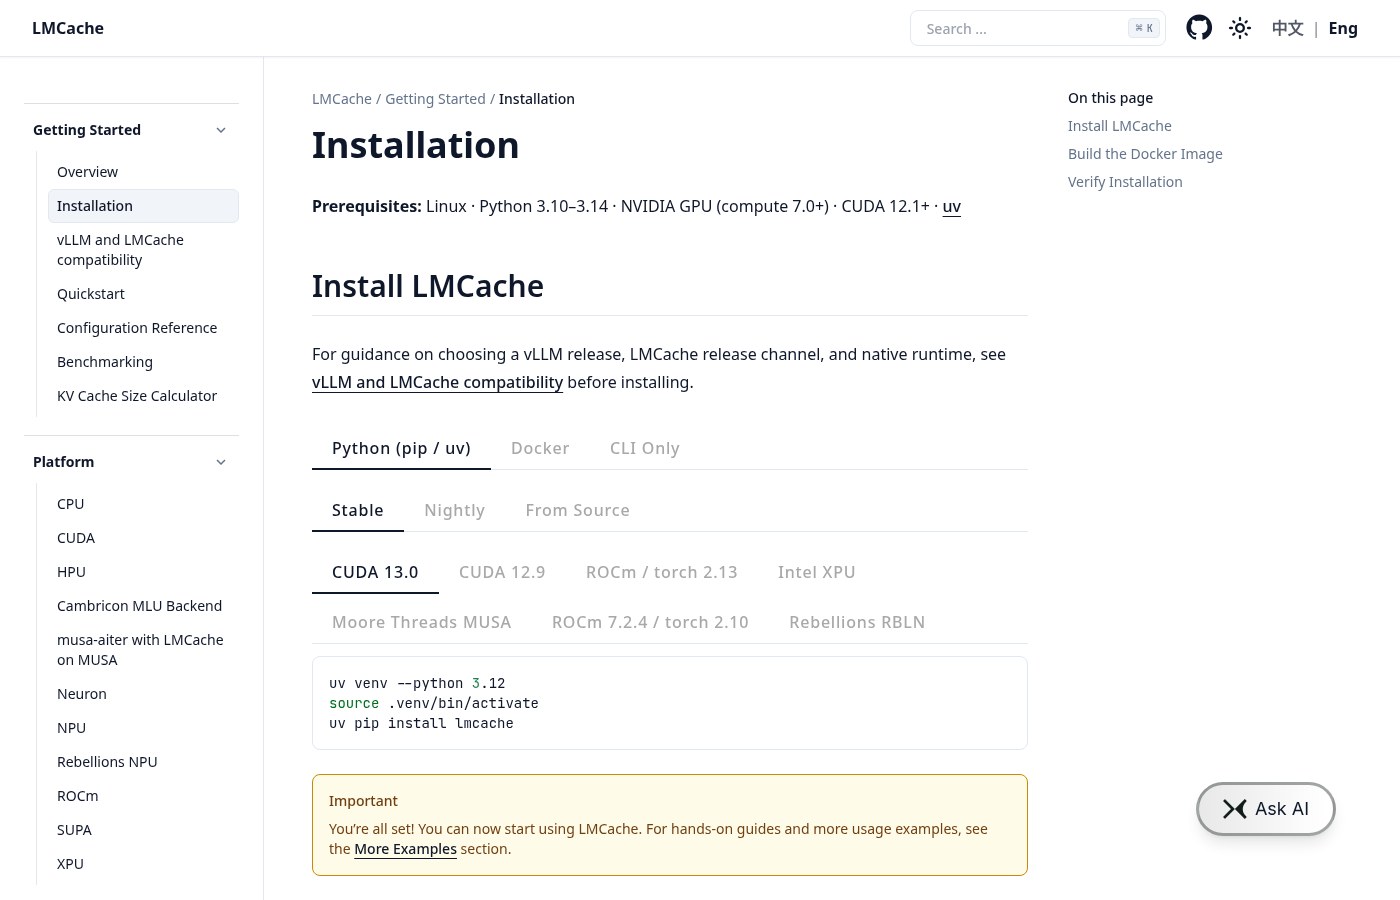
# Exemplo da documentação (com base nos comandos indicados na página «Installation» do site docs.lmcache.ai)
pip install lmcache
# Ou, conforme indicado na documentação, opte pela instalação com o backend/motor de armazenamento adicional «extra»
Após a instalação, verifique primeiro se a CLI e os módulos podem ser importados e, em seguida, avance para o guia de introdução rápida.
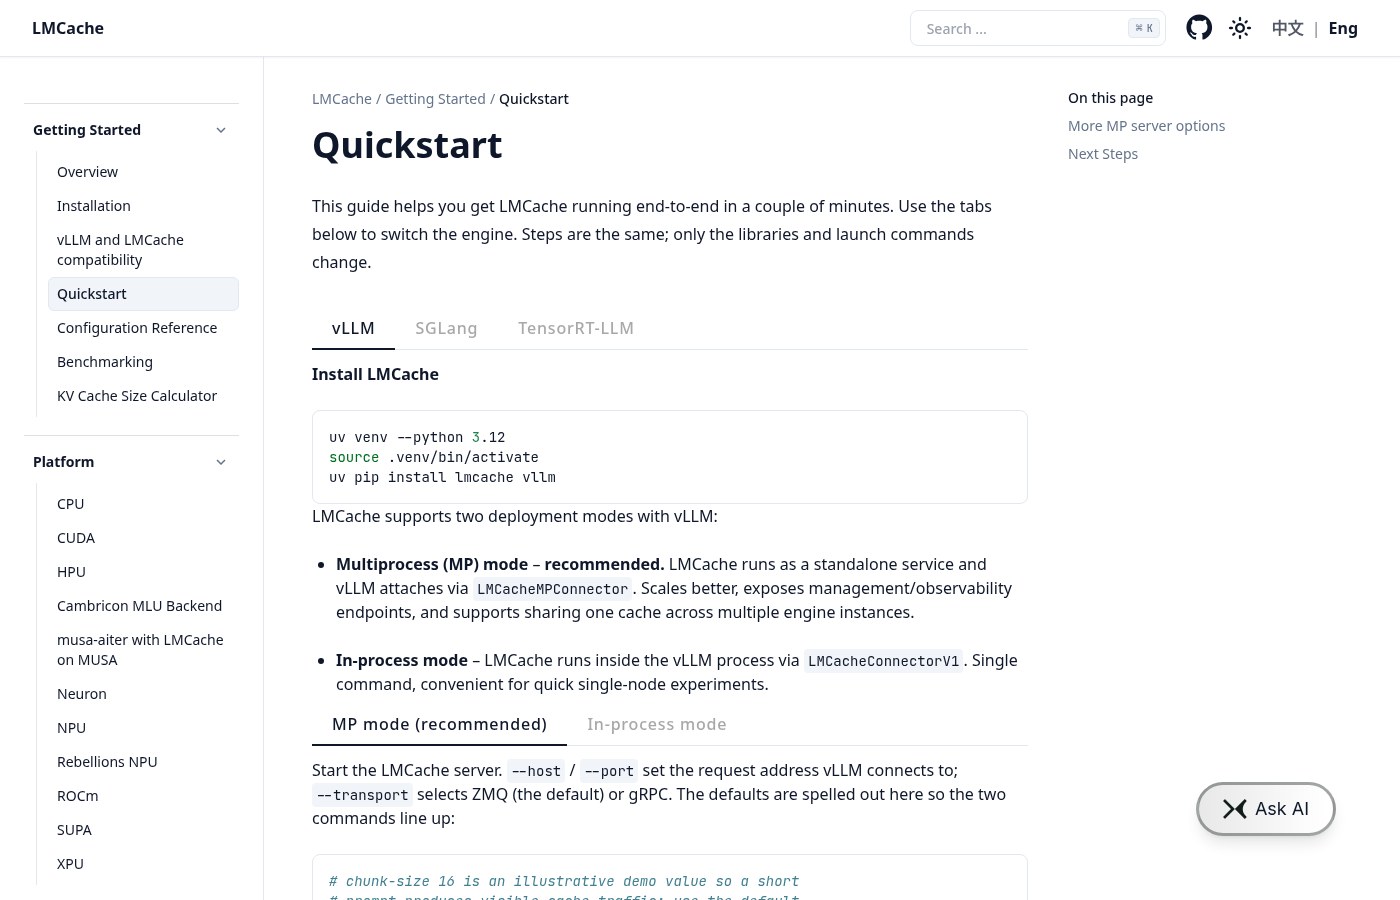
Recebimento do vLLM: pontos-chave do conector
A página oficial de integração descreve dois tipos de métodos de ligação comuns (os nomes variam consoante a versão; antes de proceder à integração, verifique qual é a versão do vLLM que selecionou):
- LMCacheMPConnector / Conector multiprocessos:O motor é configurado para apontar para o daemon LMCache já iniciado; adequado para partilha entre várias instâncias em ambiente de produção.
- Opções no motor, como o LMCacheConnectorV1:Ativar de acordo com a documentação do vLLM relativa ao sinalizador / plugin da página atual; certifique-se de que está em consonância com o tamanho do chunk e o backend de armazenamento (CPU / disco / remoto).
# Fluxo de trabalho ilustrativo (comandos de verificação não locais)
# 1) Iniciar o daemon do LMCache (porta/caminho de armazenamento conforme o ficheiro lmcache.yaml)
lmcache server --host 127.0.0.1 --port 5556 --l1-size-gb 4 --eviction-policy LRU
# 2) Iniciar o vLLM e ativar as opções de configuração do conector LMCache indicadas na documentação
#    (Os nomes específicos da CLI e das variáveis de ambiente devem seguir as indicações da página de integração vLLM × LMCache)
Lista de verificação lateral do vLLM
- A versão do motor e o nome do conector constam na tabela de compatibilidade?
- Se o endereço do daemon, o protocolo de serialização e o tamanho do chunk correspondem aos do motor
- Deve-se armazenar em cache apenas os prefixos estáveis (segmentos fixos do sistema / RAG), evitando encher a pilha da CPU com tokens altamente variáveis?
- Observe os indicadores TTFT / cache hit; se não houver nenhum hit, verifique primeiro se o alinhamento do hash está consistente com o tokenizador
Recebido do SGLang: Apenas multiprocessos
README oficial do SGLang (python/sglang/srt/mem_cache/storage/lmcache/README.md) e LMCache examples/sgl_integration Indicar: ligação MP(Código do motor por predefinição LMCacheMode.MP), é necessário iniciar primeiro um daemon independente e, em seguida, adicionar no motor --enable-lmcache juntamente com --lmcache-config-file(Fornecido pelo YAML) mp_host/mp_port). Não se deve partir do princípio de que é «in-process» / «apenas definido» LMCACHE_CONFIG_FILE Basta definir a variável de ambiente.
# Ilustração (não verificado neste computador; com base no README do SGLang LMCache e no diretório examples/sgl_integration da data em questão)
# Terminal 1
lmcache server --host 127.0.0.1 --port 5556 --l1-size-gb 4 --eviction-policy LRU
# Terminal 2
# python -m sglang.launch_server ... --enable-lmcache --lmcache-config-file lmcache_config.yaml
- Verifique primeiro, de forma independente, o estado do daemon LMCache e, em seguida, ligue o SGLang.
- O YAML
mp_host/mp_portTem de corresponder à porta em que o daemon está a escutar. - Após atualizar o SGLang ou o LMCache, verifique novamente as instruções de compatibilidade; a sintaxe «in-process» do antigo guia de início rápido poderá estar desatualizada.
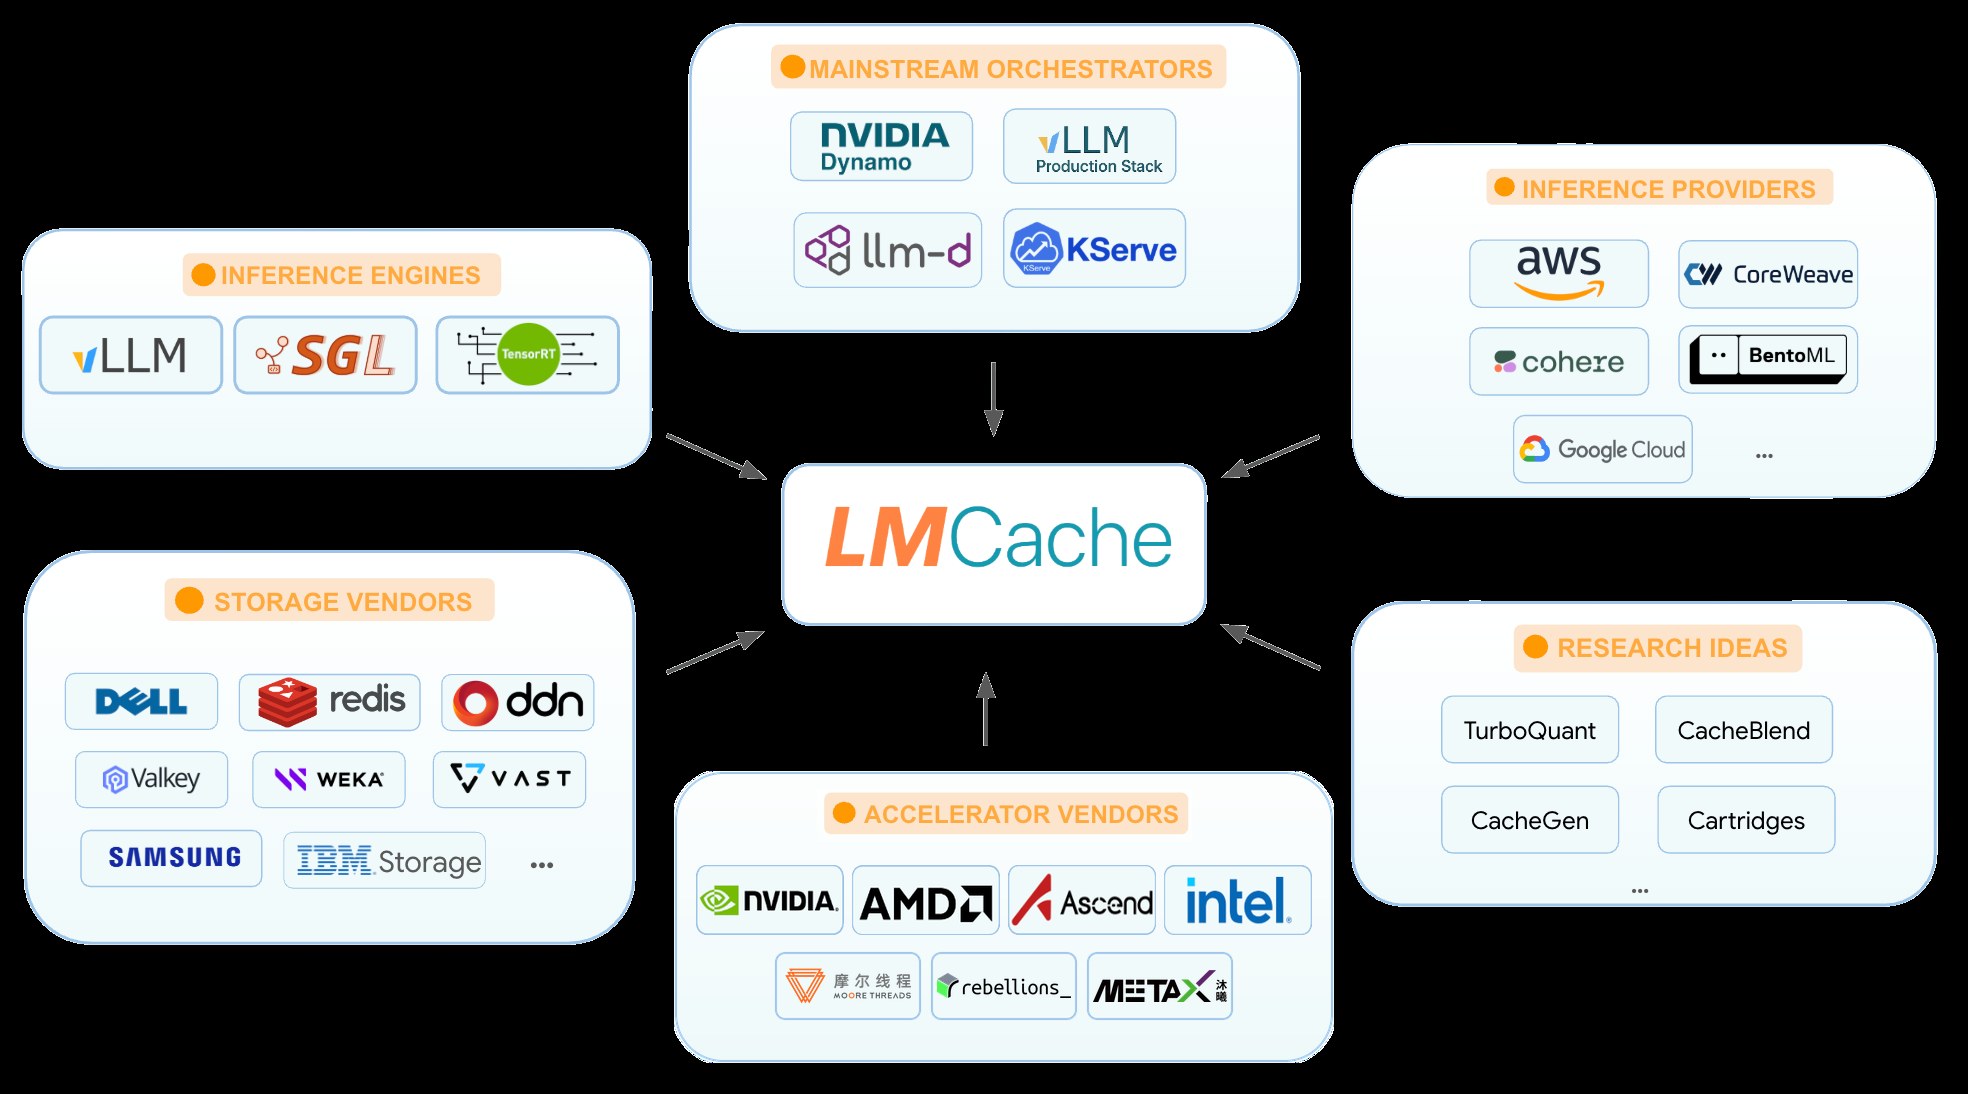
Configurações e restrições (a ler antes da publicação)
- Níveis de armazenamento:CPU DRAM → disco local → remoto; quanto mais distante, maior o atraso, sendo adequado para KV menos ativos.
- Estabilidade do prefixo:tokenize / Tabela de ferramentas / Só vale a pena partilhar blocos RAG fixos; não se deve contar com acertos entre sessões para mensagens de utilizadores que sofrem grandes alterações a cada ronda.
- Correção:A reutilização de KV pressupõe que o tokenizador seja compatível com a versão do modelo; caso se mude de modelo ou se altere um token específico, é necessário esvaziar ou isolar o conjunto de cache.
- Operações e manutenção:O facto de o daemon ter deixado de funcionar não significa que o motor entre imediatamente em colapso, mas o número de acessos (hit) será zerado; é necessário definir uma estratégia de monitorização e reinício.
- Segurança:O KV remoto pode conter conteúdo sensível, sendo encriptado e sujeito a controlo de acesso de acordo com a política de dados sensíveis.
Explicação das provas:Extrato de «Passos e Limites das Capacidades» docs.lmcache.ai(Instalação / Introdução rápida / Modos de implementação / Ecossistema) e GitHub LMCache/LMCacheeexamples/sgl_integrationeSGLang LMCache README(05/11/2026 – Verificado; o caminho original da documentação, production/integrations/sglang, apresenta um erro 404). Este ambiente não dispõe da pilha de inferência por GPU correspondente, pelo que não são fornecidas comparações de débito nem capturas de ecrã a comprovar que «funciona»; o bloco de comandos serve apenas para ilustrar o caminho da documentação.
Links de referência
- Documentação do LMCache
- Instalação · Guia de início rápido
- GitHub · LMCache/LMCache
- Documentação do vLLM(O nome do conector LMCache é o que consta na página de integração desse dia)
- SGLang · LMCache README
- LMCache · exemplos/sgl_integration


评论列表 (0条):
加载更多评论 Carregando...