


多轮对话、RAG 与 Agent 前缀高度重复时,自建推理栈最常浪费的是 KV cache 重复计算.LMCache 把 KV 放到引擎之外(CPU / 磁盘 / 远端),让 vLLM、SGLang 等在共享前缀上复用。本文是 2026-11-05 文档核验版上手指南:环境、安装、daemon+engine 启动要点、许可与限制。本机未跑通 GPU 通路,故全文不写吞吐对比数字。
读完你能判断
- 该不该上 LMCache(前缀是否真重复、是否接受多进程运维)
- vLLM 与 SGLang 各自官方推荐的接法
- 什么事情它做不到(不替代模型、不保证跨版本 KV 兼容、README ≠ 跑通证据)
它解决什么、不解决什么
- 能做:跨请求 / 跨实例复用 KV;把热前缀放 CPU 或远端存储;与 vLLM、SGLang 等通过官方 connector 对接(文档称可配合 KV-centric 调度降 TTFT、提吞吐)。
- 不能当:模型仓库、权重下载器、自动评测器;也不能把 GitHub star / 社交预览当成「你的机器已跑通」。
- 许可:仓库声明 Apache-2.0。商用前仍需自行核对 NOTICE 与依赖许可证。
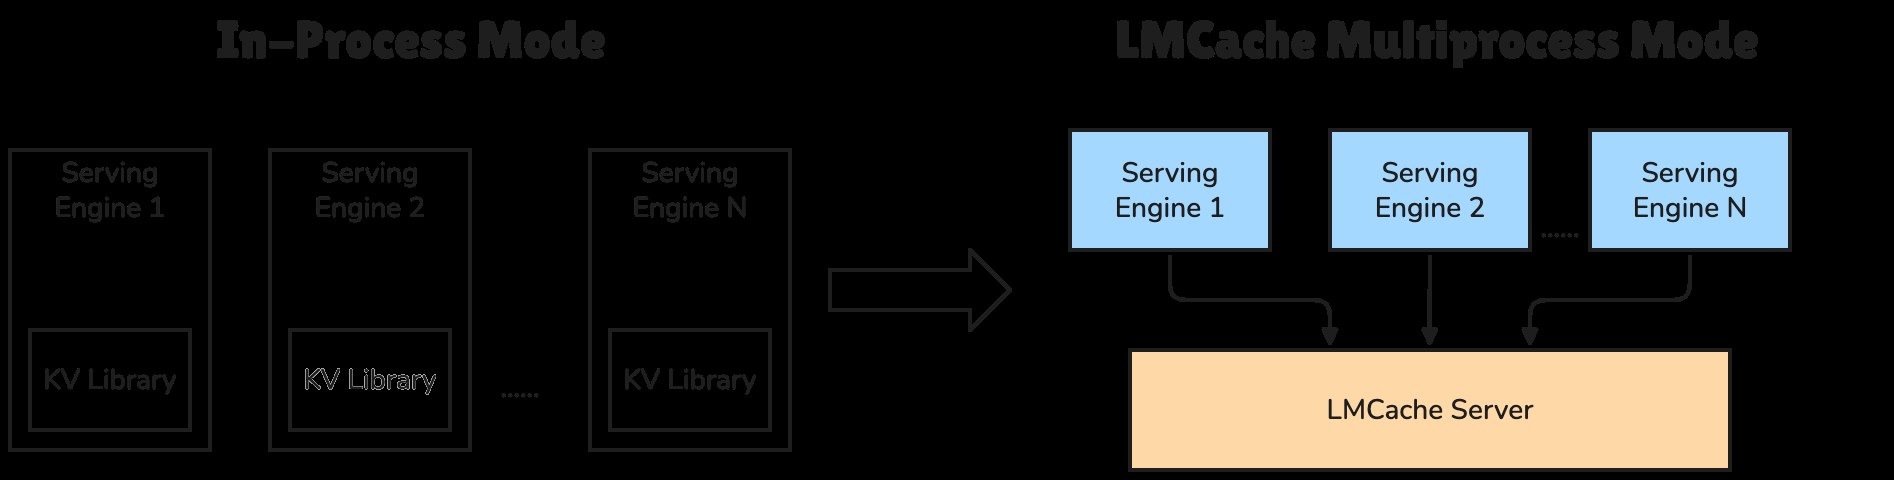
两种部署:优先 Multi-process
官方 Getting Started 把部署分成两类:
| 模式 | 怎么跑 | 文档立场 |
|---|---|---|
| Multi-process(MP) | 独立 lmcache server daemon / controller + 引擎侧 connector |
推荐:隔离故障、可多引擎共享、运维边界清晰 |
| In-process | LMCache 嵌在引擎进程内 | 轻量,但与引擎生命周期耦合;SGLang 文档写明仅支持 MP |
对「多 worker / 多引擎共享同一 KV 池」的场景,按文档走 MP:先起 lmcache server daemon,再起引擎并指向 daemon 地址(YAML 里 mp_host/mp_port).
环境与安装(文档路径)
核验页:Installation。常见路径是 Python 包安装(版本以当日 PyPI / 文档为准,撰写时文档示例指向 0.5.x 线),并确保与目标引擎版本的 connector 匹配——版本矩阵以 LMCache 与引擎各自文档为准,勿混用过旧 connector 名称.
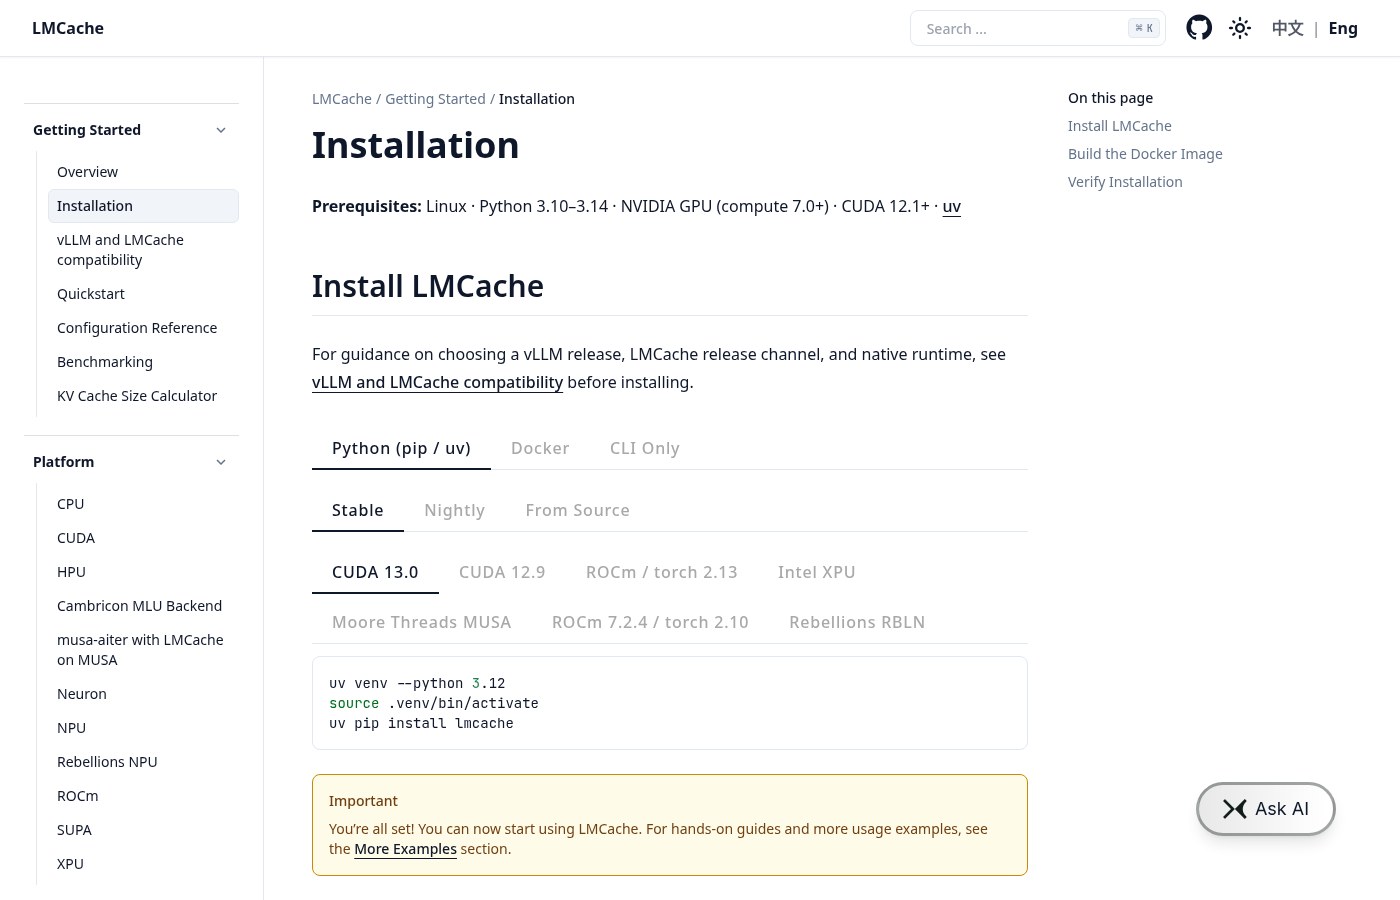
# 文档示意(以 docs.lmcache.ai Installation 当日命令为准)
pip install lmcache
# 或按文档选择带额外存储后端 / 引擎 extra 的安装方式
装完后先确认 CLI / 模块可导入,再进快速上手。
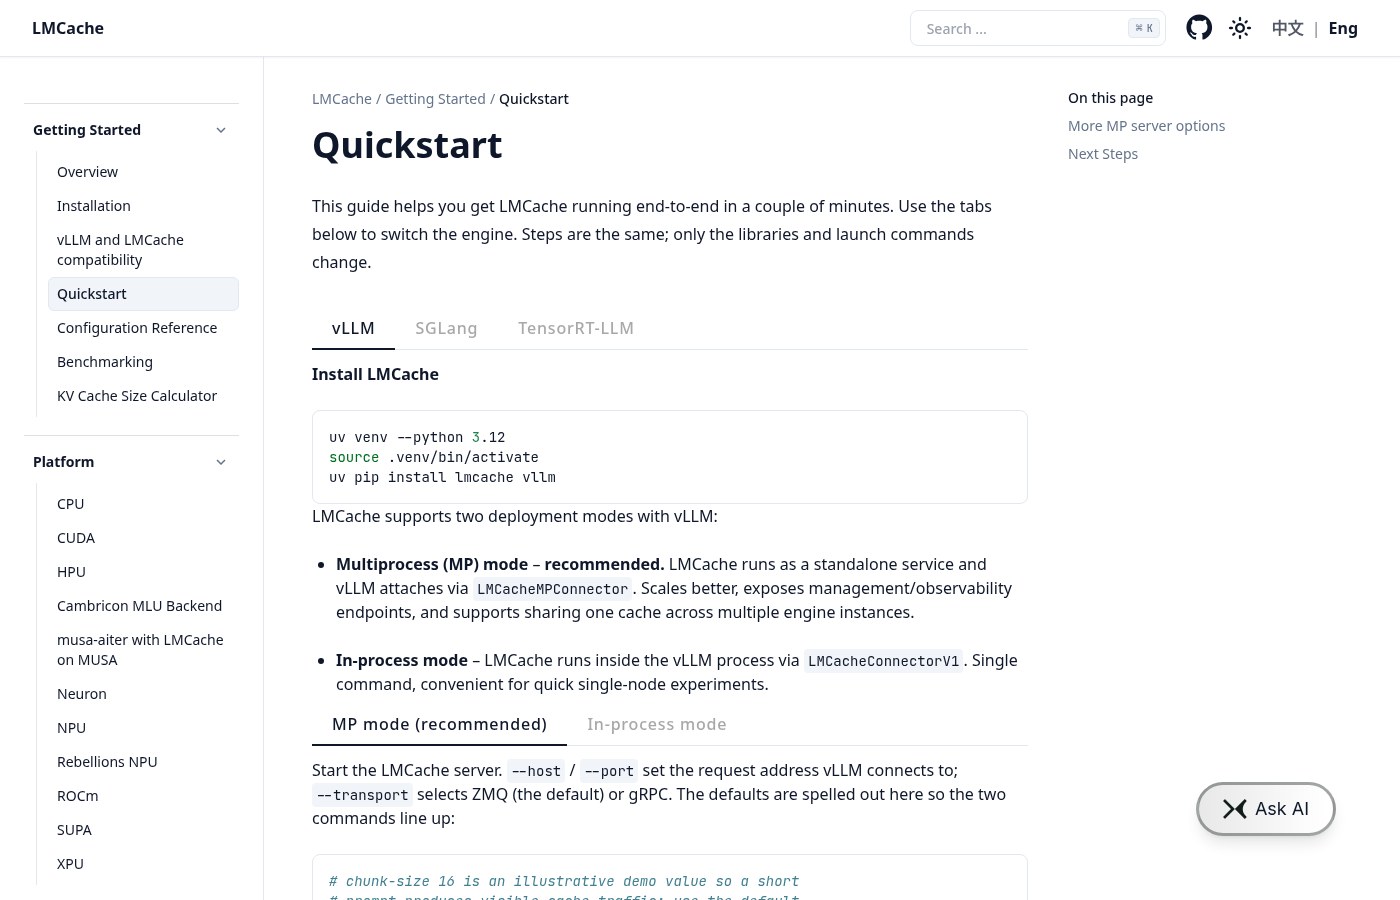
接到 vLLM:connector 要点
官方集成页描述两类常见连接方式(名称随版本演进,接入前对照你锁定的 vLLM 版本):
- LMCacheMPConnector / 多进程连接器:引擎通过配置指向已启动的 LMCache daemon;适合生产多实例共享。
- LMCacheConnectorV1 等引擎内选项:按 vLLM 当页 flag / plugin 文档启用;注意与 chunk size、存储后端(CPU / disk / remote)一致。
# 示意流程(非本机验证命令)
# 1) 启动 LMCache daemon(端口/存储路径按 lmcache.yaml)
lmcache server --host 127.0.0.1 --port 5556 --l1-size-gb 4 --eviction-policy LRU
# 2) 启动 vLLM,并启用文档给出的 LMCache connector 配置项
#    (具体 CLI / 环境变量名以 vLLM × LMCache 集成页为准)
vLLM 侧核对清单
- 引擎版本与 connector 名称是否在兼容表内
- daemon 地址、序列化协议、chunk size 是否与引擎一致
- 是否只缓存稳定前缀(system / RAG 固定段),避免把高度易变 token 塞满 CPU 池
- 观察 TTFT / cache hit 指标;无 hit 先查 hash 对齐与 tokenizer 一致性
接到 SGLang:仅 Multi-process
SGLang 侧官方 README(python/sglang/srt/mem_cache/storage/lmcache/README.md)与 LMCache examples/sgl_integration 写明:对接走 MP(引擎代码默认 LMCacheMode.MP),须先起独立 daemon,再在引擎加 --enable-lmcache junto con --lmcache-config-file(YAML 提供 mp_host/mp_port)。不要假设 in-process / 仅设 LMCACHE_CONFIG_FILE 环境变量即可。
# 示意(非本机验证;以 SGLang LMCache README 与 examples/sgl_integration 当日为准)
# Terminal 1
lmcache server --host 127.0.0.1 --port 5556 --l1-size-gb 4 --eviction-policy LRU
# Terminal 2
# python -m sglang.launch_server ... --enable-lmcache --lmcache-config-file lmcache_config.yaml
- 先独立验证 LMCache daemon 健康,再挂 SGLang。
- YAML 的
mp_host/mp_port必须与 daemon 监听一致。 - 升级 SGLang 或 LMCache 任一侧后,重新核兼容说明;旧 quickstart 的 in-process 写法可能已过时。
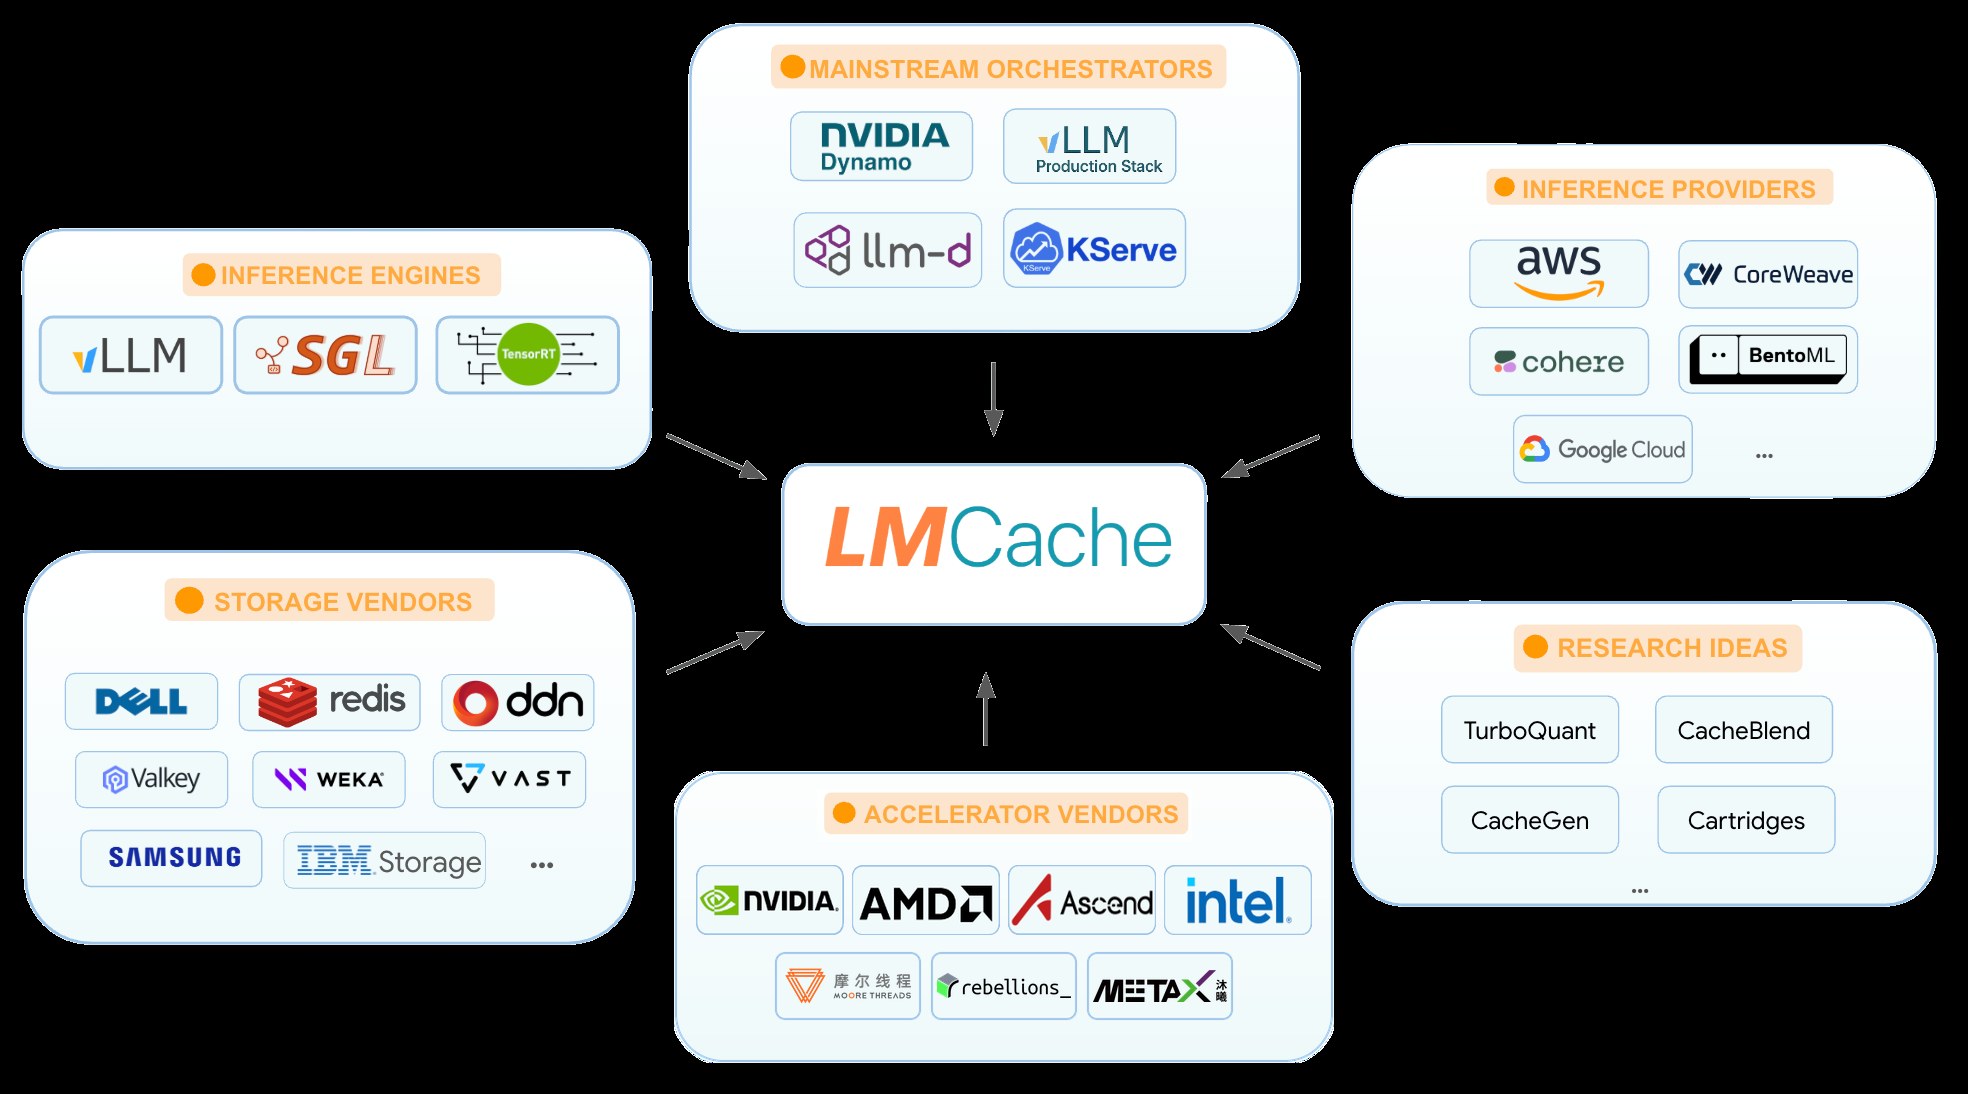
配置与限制(上线前必读)
- 存储层级:CPU DRAM → 本地盘 → 远端;越远延迟越高,适合更冷的 KV。
- 前缀稳定性:tokenize / 工具表 / 固定 RAG 块才值得共享;每轮大变的用户消息不要指望跨会话命中。
- 正确性:KV 复用假设 tokenizer 与模型版本一致;换模型或改特殊 token 须清空或隔离缓存池。
- 运维:daemon 挂了不等于引擎立刻崩,但 hit 会归零;需要监控与重启策略。
- 安全:远端 KV 可能含提示内容,按敏感数据策略加密与访问控制。
Exposición de las pruebas:步骤与能力边界摘自 docs.lmcache.ai(Installation / Quickstart / Deployment modes / Ecosystem)及 GitHub LMCache/LMCacheyexamples/sgl_integrationySGLang LMCache README(2026-11-05 打开核对;原 docs 路径 production/integrations/sglang 已 404)。本环境无对应 GPU 推理栈,故不提供吞吐对比或「已跑通」截图;命令块仅为文档路径示意。
Enlaces de referencia
- LMCache Documentation
- Installation · Quickstart
- GitHub · LMCache/LMCache
- vLLM Docs(LMCache connector 以集成页当日名为准)
- SGLang · LMCache README
- LMCache · examples/sgl_integration


评论列表 (0条):
加载更多评论 Cargando...