


Lorsque les préfixes des dialogues à plusieurs tours, du RAG et de l'agent se répètent fortement, ce qui est le plus souvent gaspillé dans une pile de raisonnement développée en interne, c'est Calculs redondants dans le cache KV.LMCache Placer le KV en dehors du moteur (CPU / disque / distant) afin de permettre à vLLM, SGLang et autres de le réutiliser sur un préfixe commun. Cet article est 5 novembre 2026 – Guide pratique de la version de vérification des documents: Environnement, installation, points clés pour le démarrage du démon et du moteur, licence et restrictions. Le passage par le GPU n'ayant pas fonctionné sur cette machine, le texte ne contient aucun chiffre comparatif de débit.
Après avoir lu ce texte, vous pourrez déterminer
- Faut-il passer à LMCache (le préfixe est-il vraiment en double, le système prend-il en charge l'exploitation multiprocessus) ?
- Méthodes de connexion officiellement recommandées par vLLM et SGLang respectivement
- Ce qu'il ne peut pas faire (ne remplace pas le modèle, ne garantit pas la compatibilité KV entre les versions, le README ne constitue pas une preuve de bon fonctionnement)
Ce qu'il résout et ce qu'il ne résout pas
- Possibilités :Réutilisation de la base de données clé-valeur (KV) entre requêtes et entre instances ; stockage des préfixes fréquemment utilisés sur le processeur ou sur un stockage distant ; intégration avec vLLM, SGLang, etc. via un connecteur officiel (selon la documentation, cela permet, en combinaison avec une planification centrée sur la base de données clé-valeur, de réduire le temps de traitement total (TTFT) et d'améliorer le débit).
- Ne peut pas être :Référentiels de modèles, outils de téléchargement de poids, outils d'évaluation automatique ; il ne faut pas non plus considérer les étoiles GitHub ou les aperçus sur les réseaux sociaux comme une garantie que « votre modèle fonctionne correctement ».
- Licence :Le dépôt est soumis à la licence Apache 2.0. Avant toute utilisation commerciale, il convient de vérifier par soi-même le fichier NOTICE et les licences des dépendances.
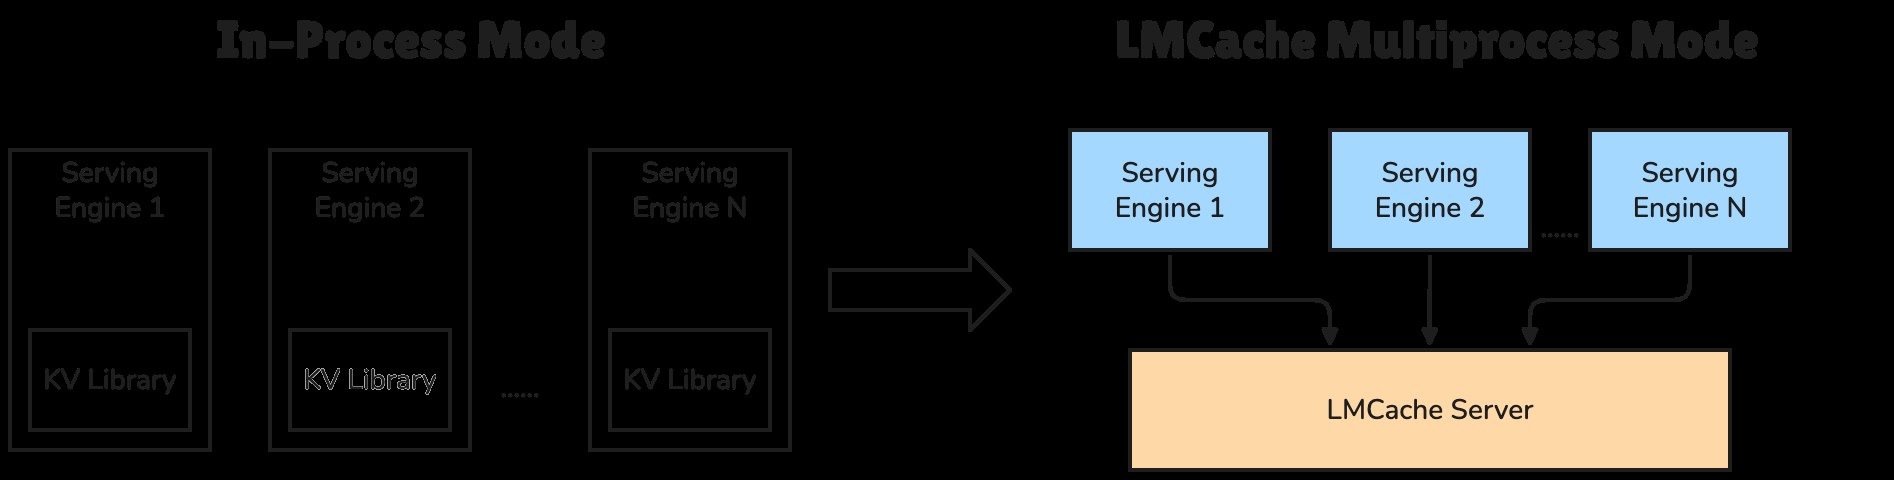
Deux types de déploiement : priorité au mode multiprocessus
Le guide officiel « Getting Started » classe les déploiements en deux catégories :
| Mode | Comment courir ? | Position de la documentation |
|---|---|---|
| Multiprocès (MP) | Indépendance Serveur lmcache daemon / contrôleur + connecteur côté moteur |
Avantages : isolation des pannes, partage entre plusieurs moteurs, délimitation claire des responsabilités en matière d'exploitation et de maintenance |
| En cours de traitement | LMCache est intégré au processus du moteur | Léger, mais couplé au cycle de vie du moteur ; la documentation de SGLang précise qu'il ne prend en charge que MP |
Dans le cas d'un scénario où « plusieurs workers / plusieurs moteurs partagent le même pool KV », suivez les instructions de la documentation concernant MP : lancez d'abord Serveur lmcache daemon, redémarrer le moteur et le pointer vers l'adresse du daemon (dans le fichier YAML) mp_host/mp_port).
Environnement et installation (chemin d'accès au dossier)
Page de vérification :Installation. La procédure habituelle consiste à installer le module Python (la version à utiliser est celle indiquée ce jour-là sur PyPI ou dans la documentation ; au moment de la rédaction de ce document, les exemples de la documentation faisaient référence à la branche 0.5.x) et à s'assurer que le connecteur est compatible avec la version du moteur cible —La matrice des versions se réfère aux documentations respectives de LMCache et du moteur ; veuillez ne pas utiliser de noms de connecteurs obsolètes..
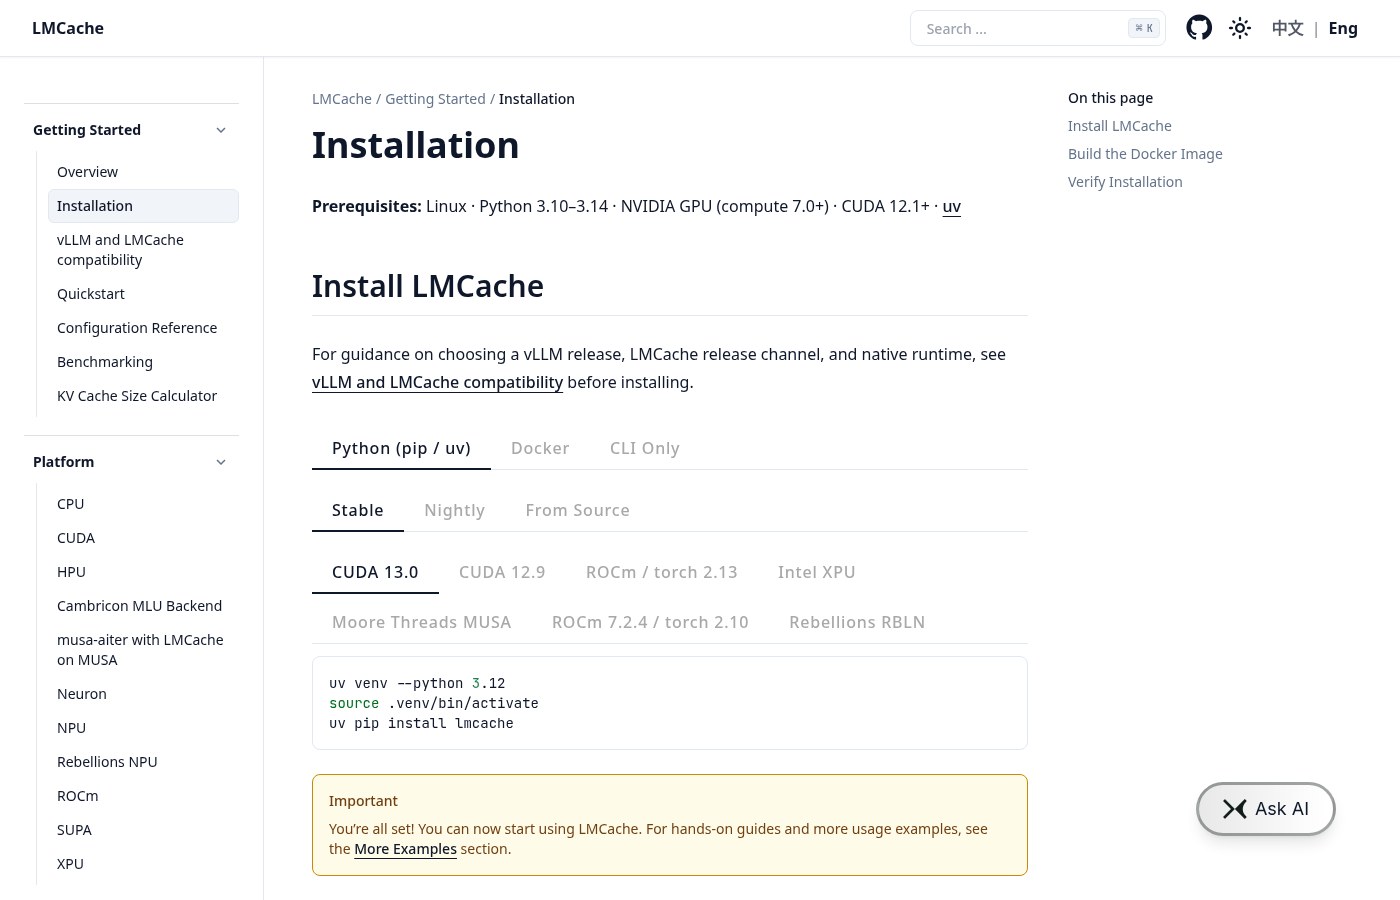
# Exemple tiré de la documentation (les commandes indiquées le jour de l'installation de docs.lmcache.ai font foi)
pip install lmcache
# Ou choisissez, selon la documentation, la méthode d'installation avec le backend / moteur de stockage supplémentaire « extra »
Une fois l'installation terminée, vérifiez d'abord que la CLI et les modules peuvent être importés, puis passez au guide de démarrage rapide.
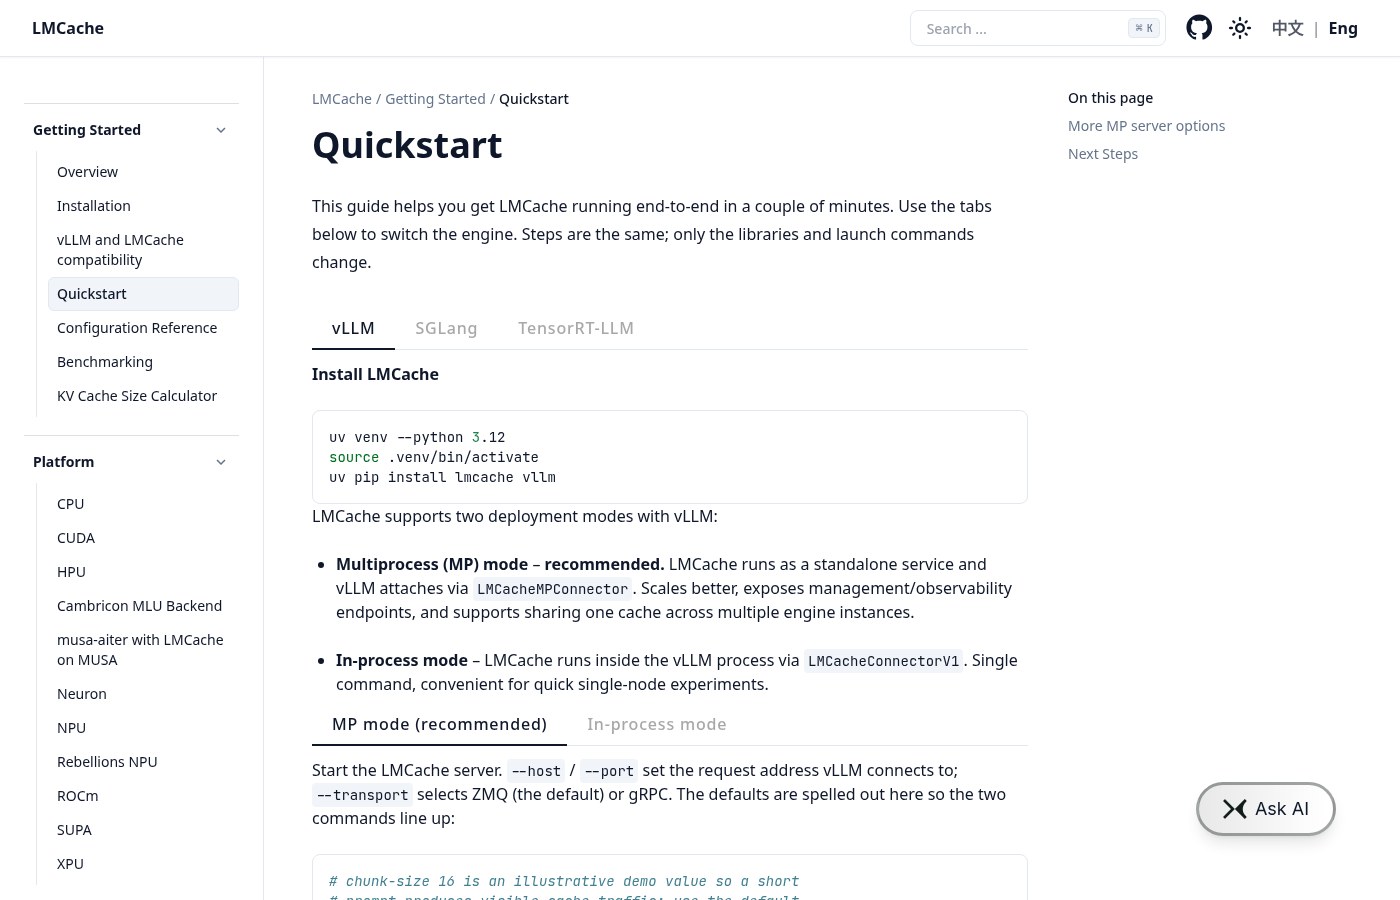
Points clés concernant le vLLM : connecteur
La page officielle d'intégration décrit deux types de méthodes de connexion courantes (les noms évoluent au fil des versions ; avant de vous connecter, vérifiez bien la version du vLLM que vous avez choisie) :
- LMCacheMPConnector / Connecteur multiprocessus :Le moteur est configuré pour pointer vers le démon LMCache déjà lancé ; cette solution est adaptée au partage entre plusieurs instances en production.
- Options intégrées au moteur, telles que LMCacheConnectorV1 :Activer en suivant les instructions de la documentation relative au drapeau / plugin « vLLM » de la page en question ; veiller à ce que la taille des blocs (chunk size) et le backend de stockage (CPU / disque / distant) soient cohérents.
# Processus indicatif (commandes de vérification hors machine)
# 1) Démarrer le démon LMCache (port et chemin de stockage selon le fichier lmcache.yaml)
lmcache server --host 127.0.0.1 --port 5556 --l1-size-gb 4 --eviction-policy LRU
# 2) Démarrer vLLM et activer les paramètres de configuration du connecteur LMCache indiqués dans la documentation
#    (Les noms précis de la CLI et des variables d’environnement sont ceux indiqués sur la page d’intégration vLLM × LMCache)
Liste de contrôle pour les vLLM
- La version du moteur et le nom du connecteur figurent-ils dans le tableau de compatibilité ?
- L'adresse du démon, le protocole de sérialisation et la taille des blocs correspondent-ils à ceux du moteur ?
- Faut-il mettre en cache uniquement les préfixes stables (segments fixes « system » / « RAG ») afin d'éviter de saturer le pool du processeur avec des tokens très volatils ?
- Surveiller les indicateurs TTFT / cache hit ; en l'absence de hit, vérifier d'abord l'alignement du hachage et la cohérence avec le tokenizer
Reçu de SGLang : multi-process uniquement
Fichier README officiel de SGLang (python/sglang/srt/mem_cache/storage/lmcache/README.md) et LMCache exemples/sgl_intégration Indiquer : « Raccordement » MP(Code du moteur par défaut) LMCacheMode.MP), il faut d'abord lancer un démon indépendant, puis ajouter dans le moteur --enable-lmcache avec --lmcache-config-file(Fourni par YAML) mp_host/mp_port). Ne partez pas du principe que c'est « in-process » / « uniquement configuré » LMCACHE_CONFIG_FILE Il suffit de définir une variable d'environnement.
# À titre indicatif (non vérifié sur cette machine ; se référer au README de SGLang LMCache et au dossier examples/sgl_integration à la date du jour)
# Terminal 1
lmcache server --host 127.0.0.1 --port 5556 --l1-size-gb 4 --eviction-policy LRU
# Terminal 2
# python -m sglang.launch_server ... --enable-lmcache --lmcache-config-file lmcache_config.yaml
- Vérifiez d'abord de manière indépendante l'état de fonctionnement du démon LMCache, puis connectez-vous à SGLang.
- YAML
mp_host/mp_portCela doit correspondre à l'écoute du démon. - Après avoir mis à jour SGLang ou LMCache, veuillez consulter à nouveau les notes de compatibilité ; l'approche « in-process » de l'ancien guide de démarrage rapide est peut-être désormais obsolète.
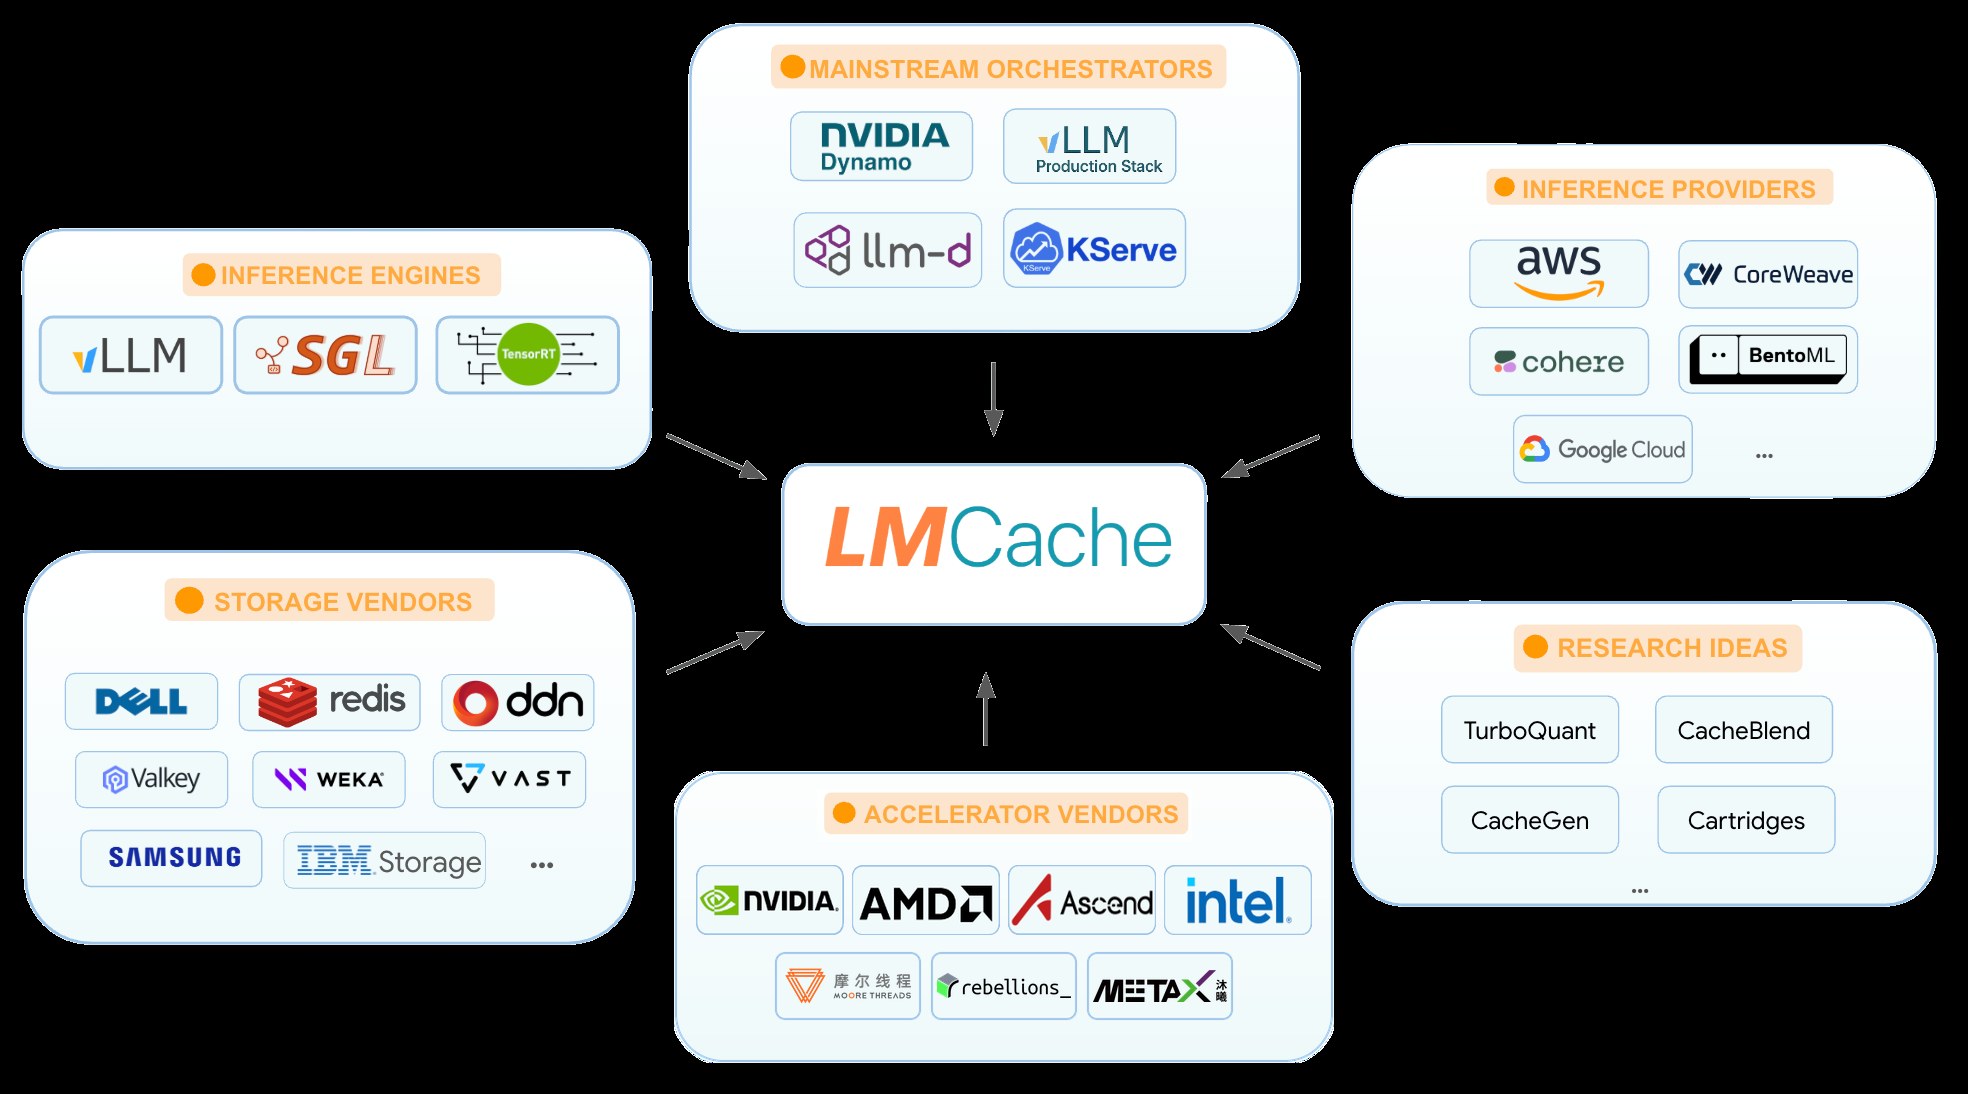
Configuration et restrictions (à lire impérativement avant la mise en ligne)
- Niveaux de stockage :CPU DRAM → disque local → distant ; plus la distance est grande, plus la latence est élevée, ce qui convient mieux aux bases de données clé-valeur moins sollicitées.
- Stabilité du préfixe :tokenize / Tableau des outils / Seuls les blocs RAG fixes méritent d'être partagés ; ne comptez pas sur la correspondance entre sessions pour les messages utilisateur qui changent considérablement à chaque itération.
- Exactitude :Le KV multiplexage suppose que le tokenizer correspond à la version du modèle ; en cas de changement de modèle ou de modification d'un token spécifique, il est nécessaire de vider ou d'isoler le pool de cache.
- Exploitation et maintenance :Le fait que le démon se bloque ne signifie pas que le moteur plante immédiatement, mais le nombre de visites est remis à zéro ; il faut mettre en place une stratégie de surveillance et de redémarrage.
- Sécurité :Les clés-valeurs distantes peuvent contenir des informations sensibles ; elles sont chiffrées et soumises à un contrôle d'accès conformément à la politique relative aux données sensibles.
Exposé des faits :Extrait de « Étapes et limites des capacités » docs.lmcache.ai(Installation / Démarrage rapide / Modes de déploiement / Écosystème) et GitHub LMCache/LMCacheetexemples/sgl_intégrationetSGLang LMCache - Fichier README(5 novembre 2026 : vérification effectuée ; le chemin d'accès d'origine aux documents, production/integrations/sglang, renvoie une erreur 404). Cet environnement ne dispose pas de la pile d'inférence GPU correspondante ; par conséquent, aucune comparaison de débit ni aucune capture d'écran attestant du bon fonctionnement n'est fournie ; le bloc de commandes sert uniquement à illustrer le chemin d'accès aux documents.
Liens utiles
- Documentation LMCache
- Installation · Guide de démarrage rapide
- GitHub · LMCache/LMCache
- Documentation vLLM(Le nom du connecteur LMCache dépend de celui de la page d'intégration du jour)
- SGLang · LMCache README
- LMCache · examples/sgl_integration


评论列表 (0条):
加载更多评论 Chargement...