


ブログ / 2026年11月5日
MIT CSAILの著者数名が、あるブログ記事をトップに押し上げた:ウェイト・スペース法――汎用大型モデルを用いて、ニューラルネットワークの重みを直接読み取り、変更し、さらにはゼロから書き込むことさえ可能。タイトルカードの中で最も目を引く図は、Qwen3.5-0.8BのMATH-500スコアが7.9%から48.1%へと向上し、その際に調整された重みはわずか0.016%だったというものである。
中国語圏では、すぐに「6倍に急騰、モデルが突然数学を解けるようになった」と解釈されてしまった。しかし、著者のログやサードパーティによる再実行の結果は、実は別のことを示している。まず思考の無限ループを断ち切り、次に、モデルが本来持っていたものの、ループによって阻まれてしまっていた能力を解き放つことだ。そして、本日当サイトに掲載された「Codex 6.2 Astra ベータテスト」の記事については……まったくニュースにはならない――本記事では、MITがGPT-6 Astraを用いて小型モデルの重みを調整した研究について論じている。
「6倍の急騰」という表現を、「循環の障害が解消された後の本来のレベルへの回復+独自に検証可能な重み付けパッチ」へと修正する。
彼らは一体何を披露したのか
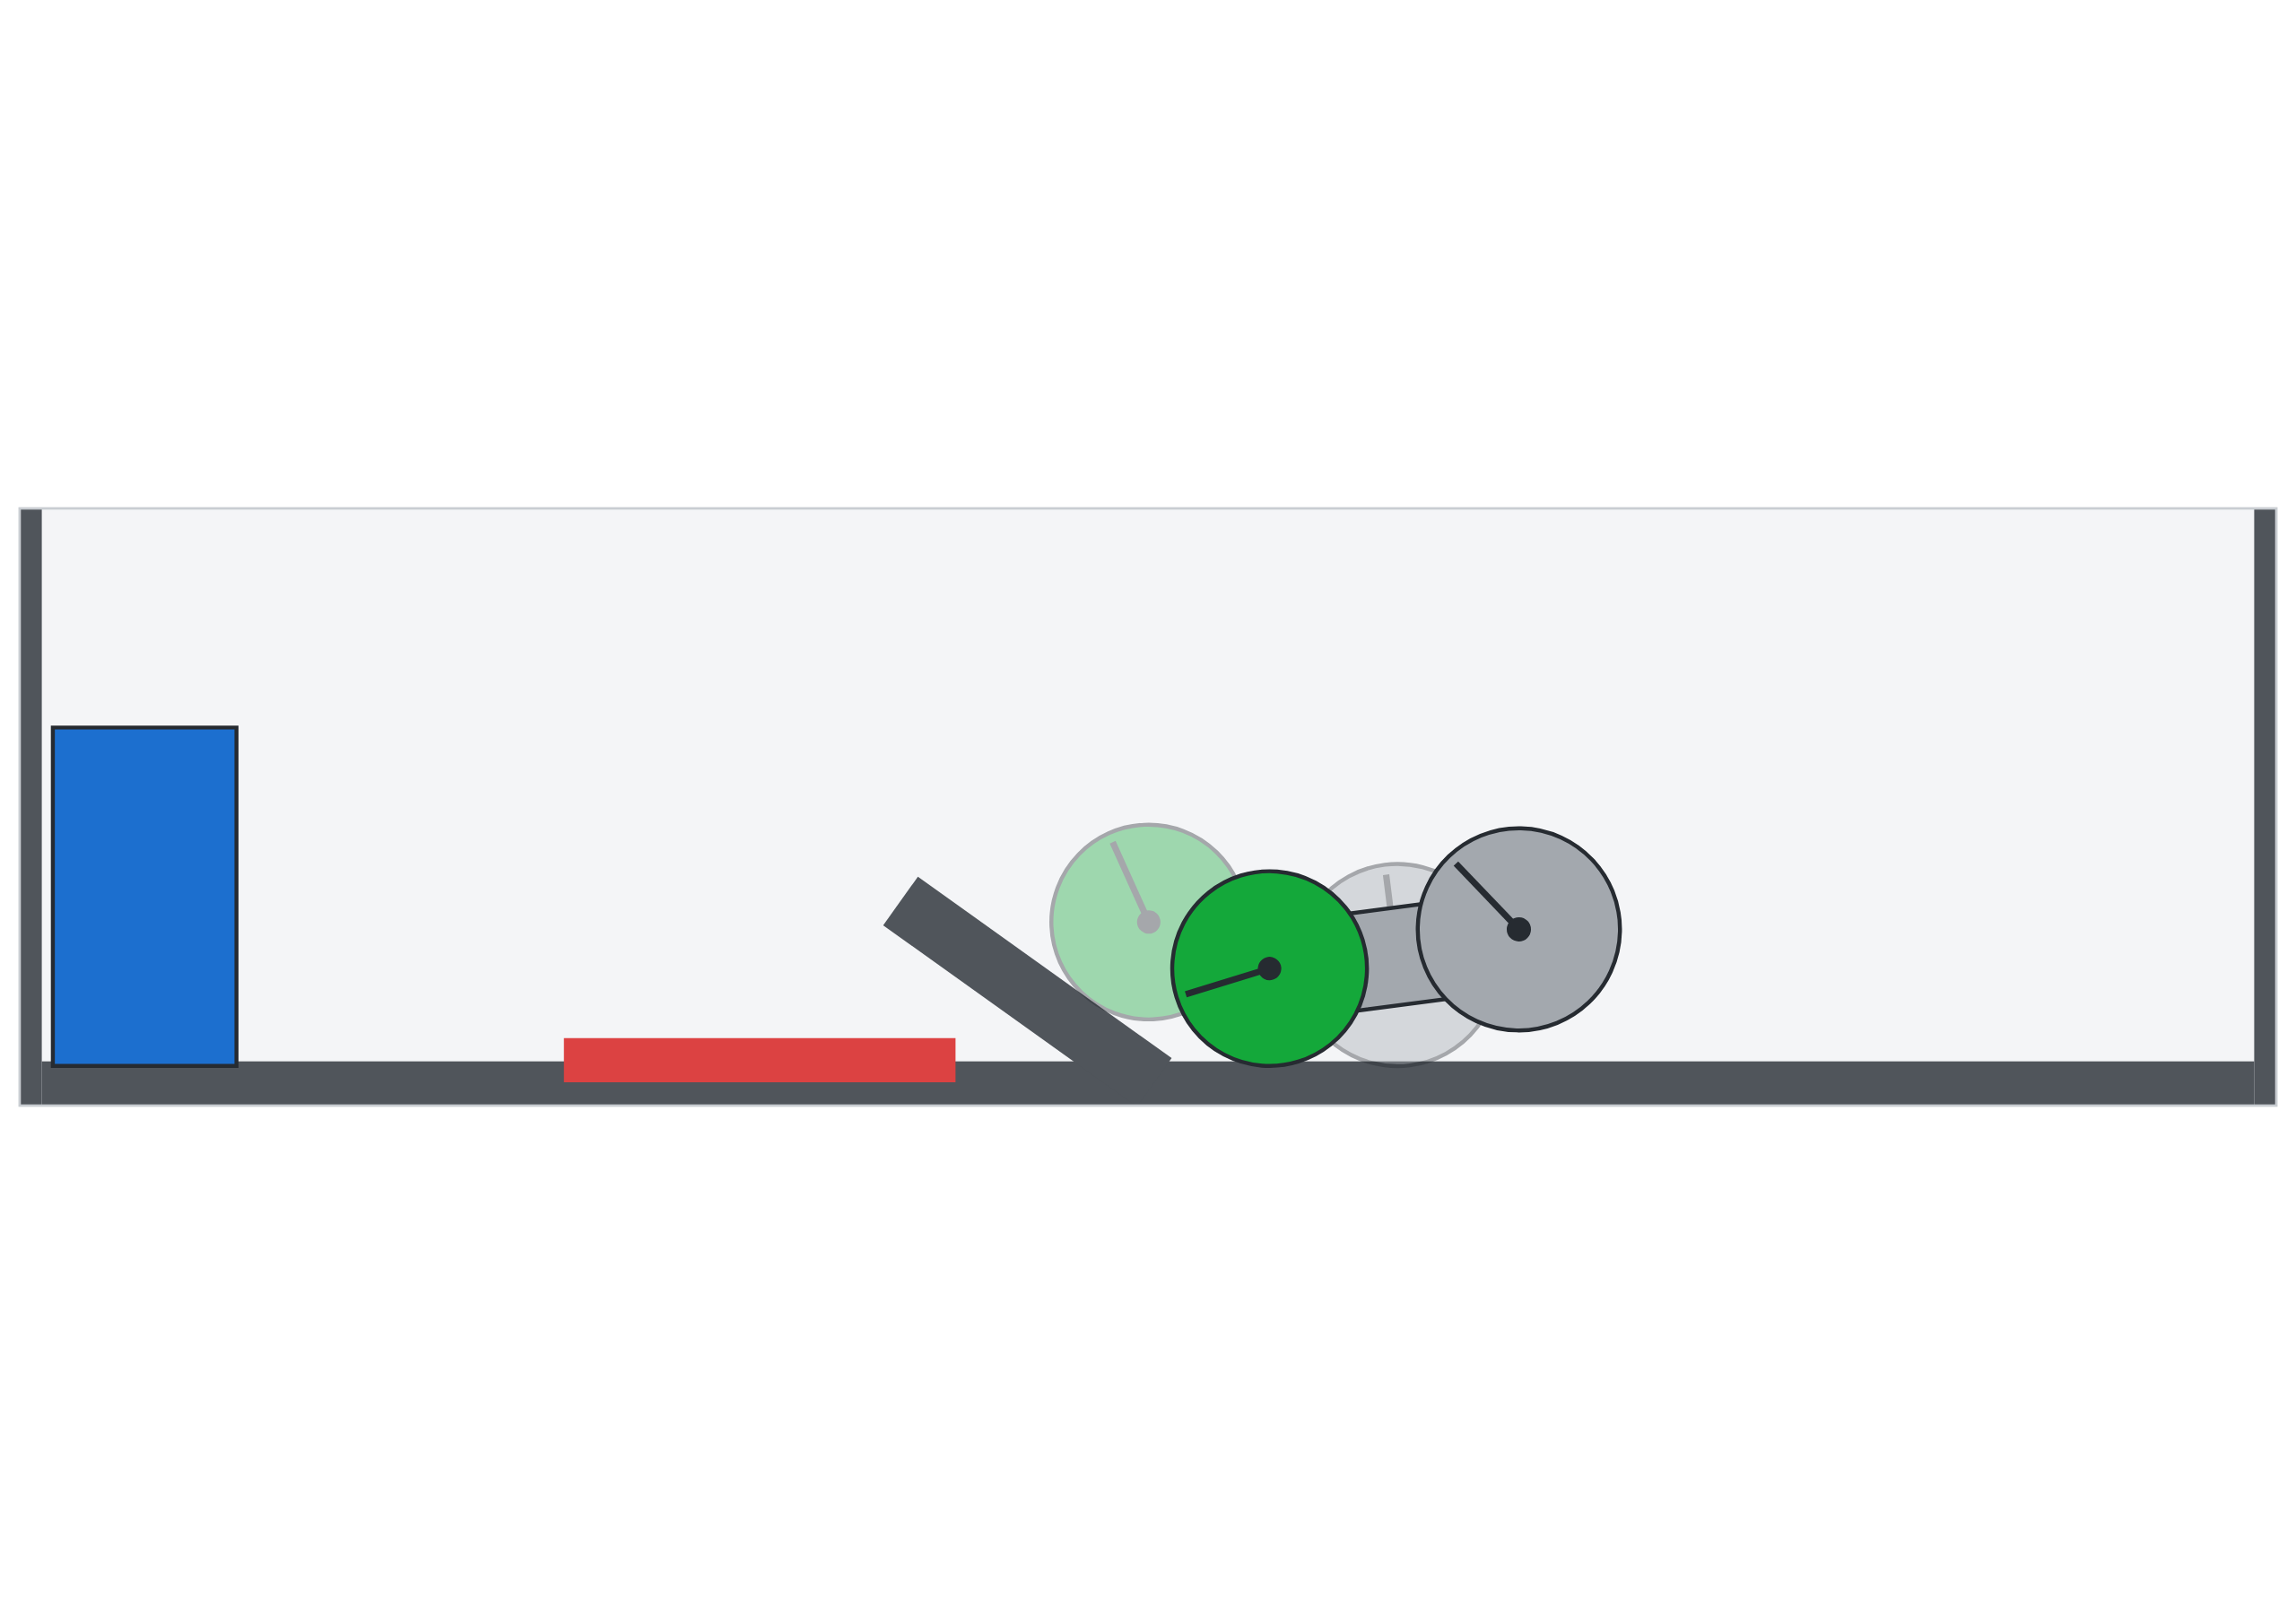
ブログでは、その能力を「重みの読み取り」「重みの修正」「ゼロからの重みの記述」の3つに分類している。小規模なネットワークにおいて、Astraは重みを見るだけで、ポリシーネットワークがどのゲームをプレイしているかを特定できるほか、坂で立ち往生している車のポリシーをワンクリックで修正し、通過できるようにすることも可能です。さらに、MinAtar上で、PPOで1億ステップを消化したネットワークをゼロから構築することもできます。これらの実験の中には、文字通り「重みをテキストとして文脈に埋め込む」ものもあれば、Pythonサンドボックスや有限回のフォワード計算を許可したものもあります。
言語モデルの規模に拡大すると、ルールが変わります。Gemmaによるお世辞の識別や、Qwenへの数学的な編集は、もはや「浮動小数点数をそのまま見る」ような単純な作業ではありません。Pythonが必要となり、注意ツールや演習問題におけるフォワード予算に注意を払う必要があります。著者自身も後段で次のように明記している。Qwenの実験では、最大50回のフォワードパス(バッチ学習)が許可されており、勾配学習は明確に禁止されている。
MATHの急騰:ループがなくなったからといって、新しい数学が導入されたわけではない
Qwen3.5-0.8Bが思考を開始すると、モデル自体が思考ループに陥りやすいと警告する。著者によると、ベースラインモデルはトレーニングセットの最初の96件の回答のうち、85件で32,768トークンの上限に達していた。Astraは、ループの原因をMLPの第15層および第19層の特定の方向まで特定し、各層の64個の出力列からその方向を除外することで、合計131,072個の重み(0.016%)を修正した。
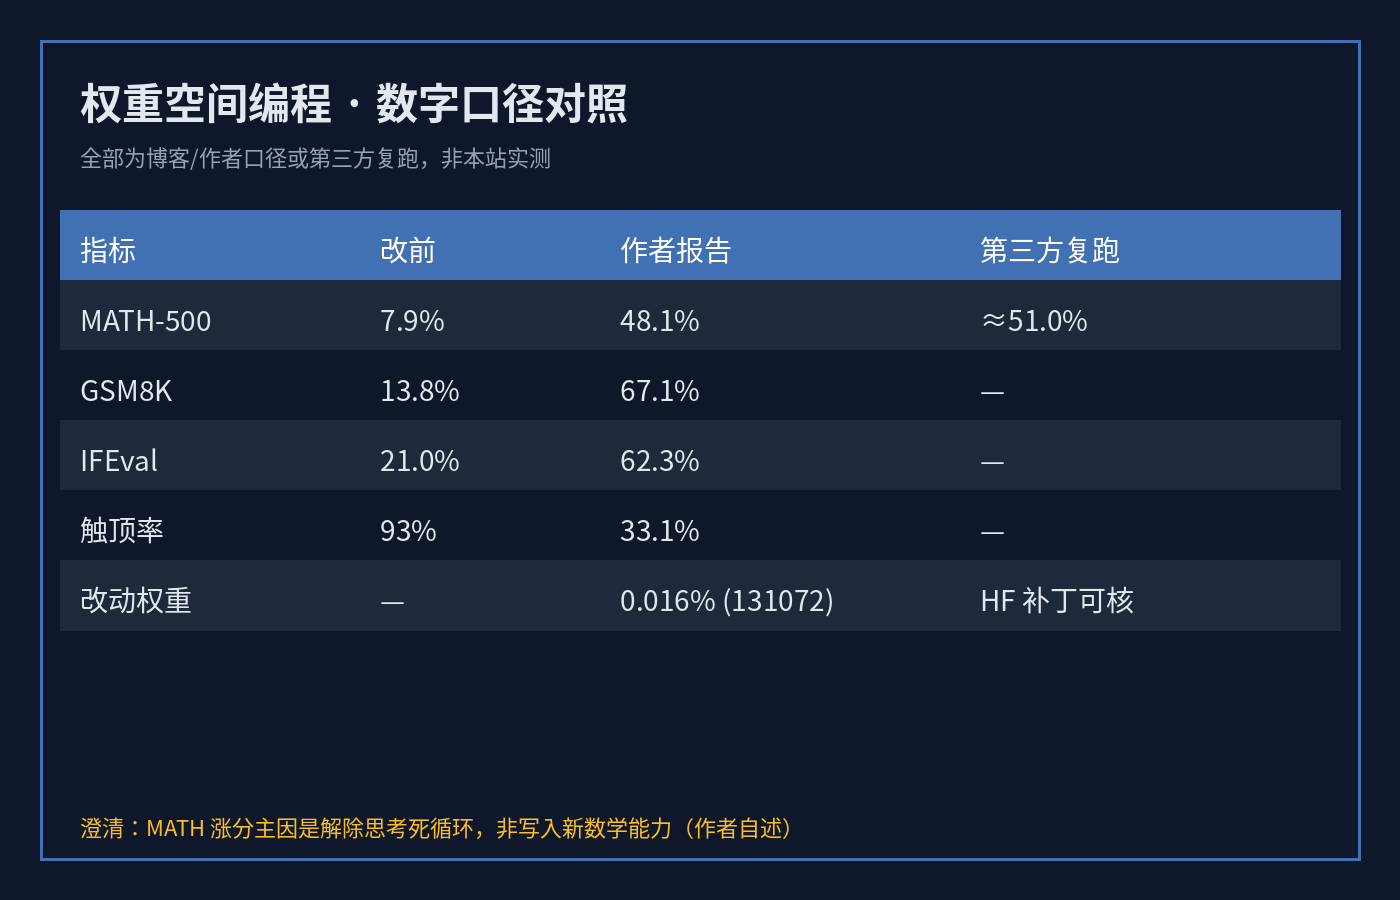
著者による測定基準および同一のサンプリング設定の下で:MATH-500 7.9%→48.1%、GSM8K 13.8%→67.1%、IFEval 21.0%→62.3%、ピーク到達率 93%→33.1%。Hugging Face には、重みと SHA-256 を適用したパッチリポジトリがすでに公開されている。サードパーティによる MATH-500 の再実行結果は、約 51.0% であった。これらはすべて、ブログ/著者/再実行の基準に基づくものであり、当サイトによる実測結果ではありません.
同じ記事には対照的なデータも掲載されている。ループをほとんど行わないGemma 3 270Mに対し、同等の予算ではMATHはほとんど動かない。著者の言葉をそのまま引用した結論はこうだ――編集者は既存の能力を妨げる障害を取り除くことはできるが、モデルに本来備わっていない能力を「書き込む」ことは難しい。この一文は、タイトルカードに表示された緑の棒グラフよりも重要だ。
Honnibal はなぜ「誤解を招く」と言ったのか
spaCyの開発者であるMatthew Honnibal氏は、要約が「原始重みのみを参照する」というニュアンスと、その後に続くPython、フォワード伝播、演習問題に依存するQwenの実験を混同して記述しているため、読者は1万7000パラメータから8億パラメータに至る幅広い範囲を、同一の手法で網羅したかのように誤解しやすいと批判した。彼の比較表では、各実験において「生の重みを読み取るか」「重みを書き込むか」「ネットワークを実行するか」が明確に示されている。真に「生の浮動小数点数をコンテキストに組み込む」手法は、主に数万から十数万パラメータ規模の小さなネットワークにとどまっている。
これは全面的な否定を意味するわけではない。harness 内でループの方向を特定し、再現可能なパッチを提供できること自体は、依然として技術的な成果である。しかし、マーケティング文言を「大規模モデルが重み空間を透視し、少し手を加えるだけでオリンピックレベルの数学問題を解ける」といった風に書くなら、それは行き過ぎだ。著者側も、MATHのスコア向上の主な要因が無限ループの解消であることを認め、検証可能な重み付けファイルも追加した。これにより、論争の焦点は「そのような事実があるかどうか」から、「見出しが異なる技術スタックをあたかも同じ『魔法』であるかのように表現しているかどうか」へと移った。
仕組みの詳細をもう一つ補足し、緑の柱だけ覚えてしまわないようにしましょう。著者によると、ループは「特定の方向」がMLPによって残留流に繰り返し書き込まれることに相当します。編集操作は、アテンションを再学習したりトークナイザーを変更したりするのではなく、特定の出力列からその方向を差し引くことに近似しています。トップアウト率が93%から33.1%に低下して初めて、モデルはすでに正しく計算された中間ステップを完了する機会を得た――スコアが上昇したのは、その大部分が「ようやく解答を提出できた」ためであり、突然新しい定理を習得したからではない。
ログと重み付けが公開されました:完全な対話内容、コード、評価結果は GitHub のログリポジトリにあります。HF リポジトリでは、修正後の重み付けとチェックサムが提供されており、サードパーティによる再実行が容易になっています。学校やチームの研究室にとって、検証の最短手順は次の通りです:温度と top-p を固定し、まずピーク到達率を測定し、次に MATH-500 を測定することです。単なる比較棒グラフを転載するだけでは不十分です。
「モデルに数学をより得意にさせる」というメインのプロンプト自体は極めて短く、その後、Claude Code などのツールによって補足説明が追加された――これも論争点の一つである。このタイトルからは、Astraが単独で「8億の重みを理解した」と誤解されがちだが、実際にはツールや演習問題の予算を伴うエンジニアリングセッションである。これを「プロンプトエンジニアリング+重み編集」と表現する方が、「霊能力」と書くよりも正確だ。
One More Thing:Astraのクローズドベータテストに関するニュースとは別記事として掲載
サイト内には、Codexの使用量に関する記述がちらりと見受けられる gpt-6.2-astra のグレーテスト追跡。それが「製品可用性レーダー」です。本記事における「Astra」は、研究ブログ内で言及されている対象であり、重みの読み書きを実演するために使用されています。両者とも現実のものですが、読者が果たすべき役割は全く異なります。一方は「モデルIDを変更するかどうか」を決定し、もう一方は「重みを0.016%変更すれば数学を習得できる」という主張を信じるかどうかを決定するものです。
自分で確認したい場合は、まず著者のブログにある実験設定表を確認し、次にSHA-256用のHFパッチを適用し、最後に同じサンプリングでMATH-500/ピーク到達率を再実行してください。スクリーンショットを「6倍」転載するよりも、はるかに役立ちます。
当社の判断:「6倍の急騰」という表現を、「ループの障害が解消された後の本来のレベルへの回復+独自に検証可能な重み付けパッチ」へと修正する。Weight-Space Programmingは研究分野として注目に値するが、「小規模ネットワークの重みをそのまま読み取る」ことと「ツールを用いて大規模モデルを修正する」ことは、別々の項目として区別して記述すること。また、Codex 6.2 Astraのクローズドベータテストに関するニュースとは完全に切り離し、1つの記事内で2つの事柄が互いに正当化されることを避けること。
参考リンク
- Rikiya Takehi ほか:Weight-Spaceプログラミングの火花
- HF:Qwen3.5-0.8B ウェイトスペースプログラミング パッチ
- マシュー・ホニバル:Astraの読み書きに関する記事が「誤解を招く」と指摘される
- QuantumBit トピックレーダー(詳細は著者のブログを参照)


评论列表 (0条):
加载更多评论 読み込み中...