


複数回の対話、RAG、およびエージェントのプレフィックスが高度に重複する場合、独自に構築した推論スタックで最も浪費されがちなのは KVキャッシュの重複計算.LMCache KVをエンジン外(CPU/ディスク/リモート)に配置し、vLLMやSGLangなどが共通のプレフィックス上で再利用できるようにする。本稿は 2026年11月5日 ドキュメント検証版 スタートガイド:環境、インストール、daemon+engine の起動に関する要点、ライセンスと制限。本機では GPU パスが正常に動作しなかったため、本文ではスループットの比較数値については記載しない。
読み終えたら、判断できるでしょう
- LMCacheを導入すべきか(プレフィックスが本当に重複しているか、マルチプロセス運用に対応しているか)
- vLLM と SGLang の各公式が推奨する接続方法
- できないこと(モデルの代替にはならない、バージョン間のKV互換性は保証されない、README ≠ 正常動作の証拠)
何が解決され、何が解決されないのか
- できること:リクエスト間/インスタンス間でKVを再利用;アクセス頻度の高いプレフィックスをCPUまたはリモートストレージに配置;vLLMやSGLangなどとの公式コネクタによる連携(ドキュメントによると、KV中心のスケジューリングと組み合わせることでTTFTを短縮し、スループットを向上させることができる)。
- 「~としてはいけない」:モデルリポジトリ、重みダウンロードツール、自動評価ツール。また、GitHubのスターやソーシャルプレビューを「自分のマシンで動作した」とみなしてはいけません。
- ライセンス:リポジトリのライセンスは Apache-2.0 です。商用利用の前に、NOTICE および依存するライセンスを必ずご自身で確認してください。
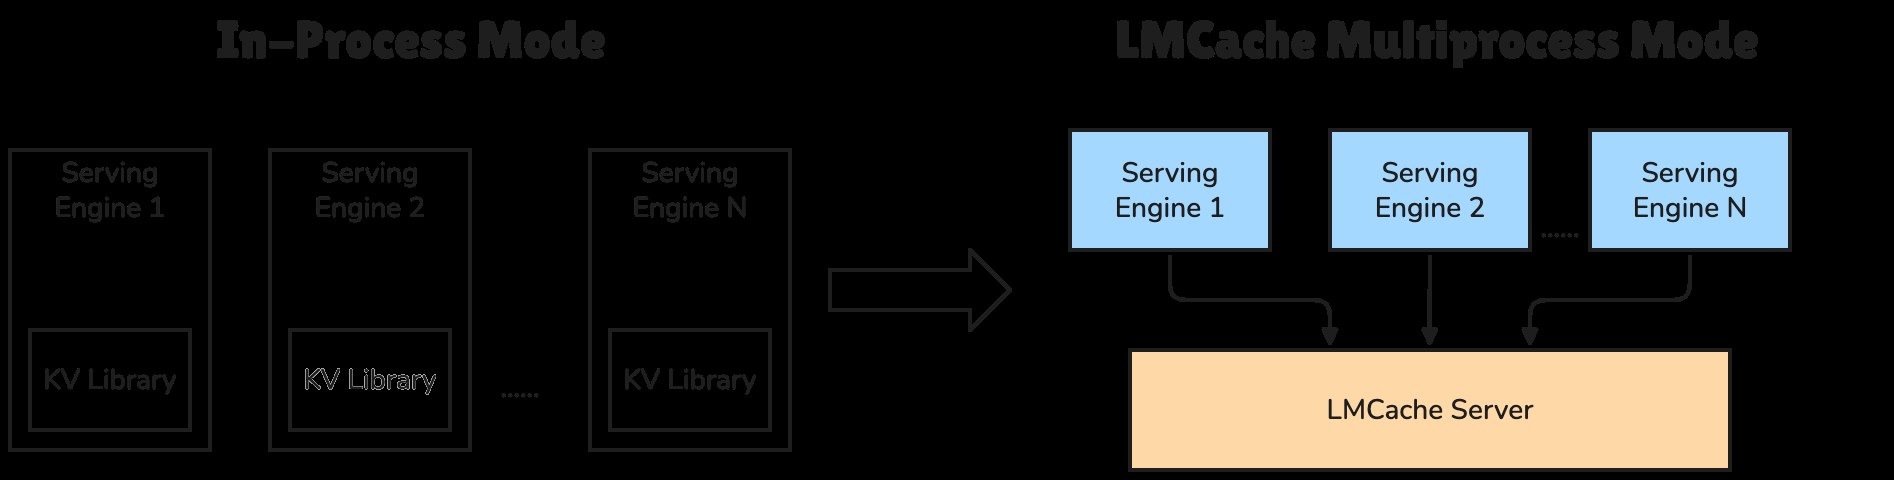
2つのデプロイ方法:Multi-processを優先
公式の「Getting Started」では、デプロイを2つのカテゴリに分類しています:
| モード | どうやって走るの? | 文書の立場 |
|---|---|---|
| マルチプロセス(MP) | 独立 lmcache サーバー デーモン/コントローラー + エンジン側のコネクタ |
おすすめ:障害の特定が容易、複数のエンジンで共有可能、運用・保守の境界が明確 |
| 処理中 | LMCache はエンジンプロセス内に組み込まれている | 軽量だが、エンジンのライフサイクルと密接に連動している。SGLangのドキュメントには、MPのみをサポートすると明記されている。 |
「複数のワーカー/複数のエンジンが同一のKVプールを共有する」というシナリオでは、ドキュメントに従ってMPを実行します:まず起動し、 lmcache サーバー daemon、エンジンを再起動し、daemon のアドレスを指定する(YAML 内で mp_host/mp_port).
環境とインストール(ドキュメントのパス)
確認ページ:インストール。一般的な手順は、Python パッケージのインストール(バージョンは当日の PyPI およびドキュメントを基準とし、執筆時点ではドキュメントの例が 0.5.x シリーズを指しています)であり、対象のエンジンバージョンに対応するコネクタであることを確認してください――バージョンマトリックスについては、LMCache およびエンジンの各ドキュメントを基準としてください。古いコネクタ名を混在させて使用しないでください。.
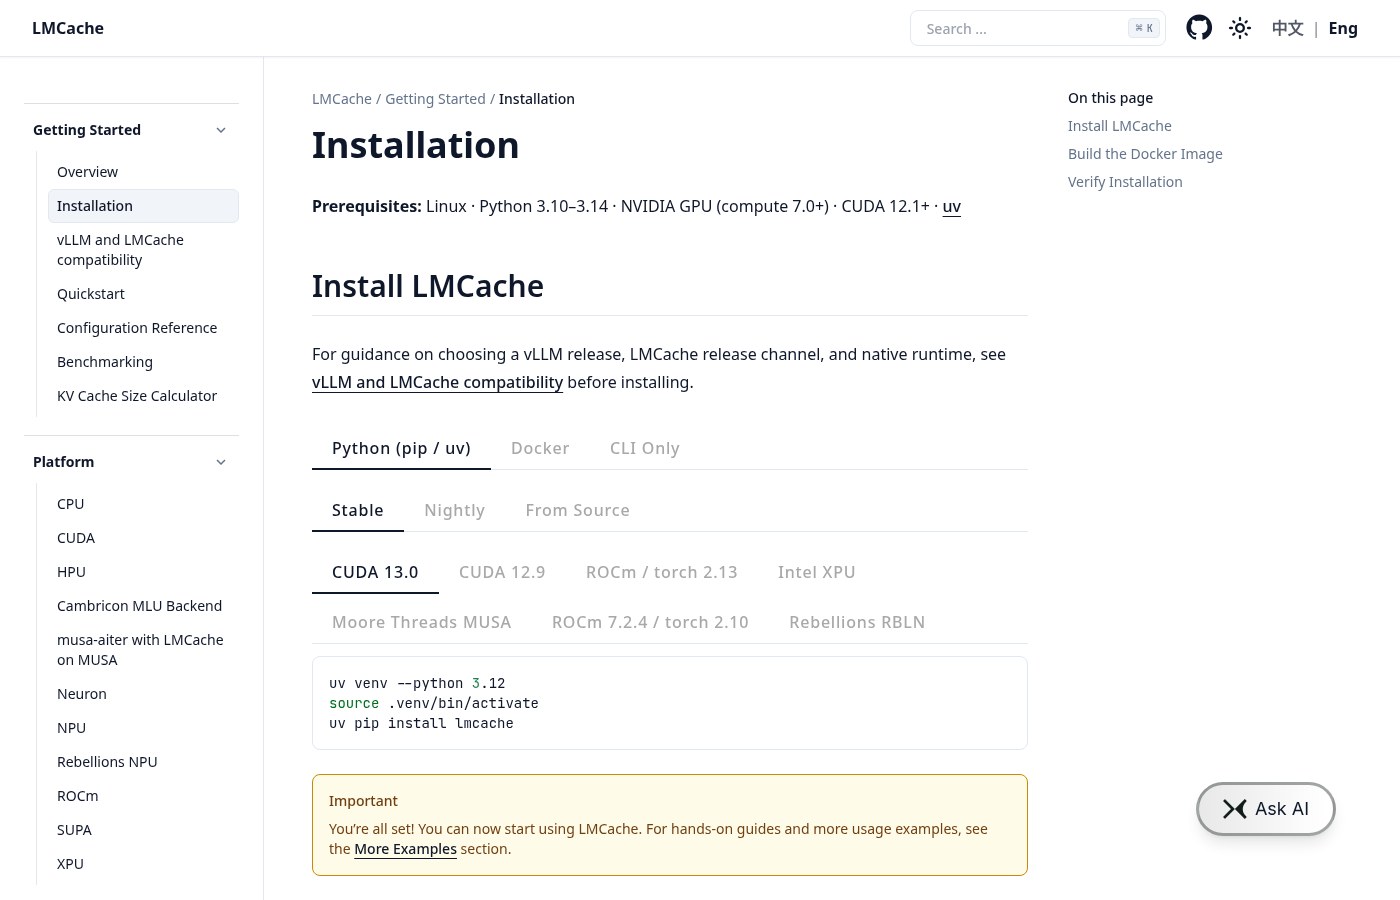
# ドキュメントの例(docs.lmcache.aiの「Installation」セクションに記載されている当日のコマンドを基準とする)
pip install lmcache
# または、ドキュメントに従って、追加のストレージバックエンド/エンジン「extra」を含むインストール方法を選択する
インストールが完了したら、まずCLIやモジュールがインポートできることを確認してから、クイックスタートに進んでください。
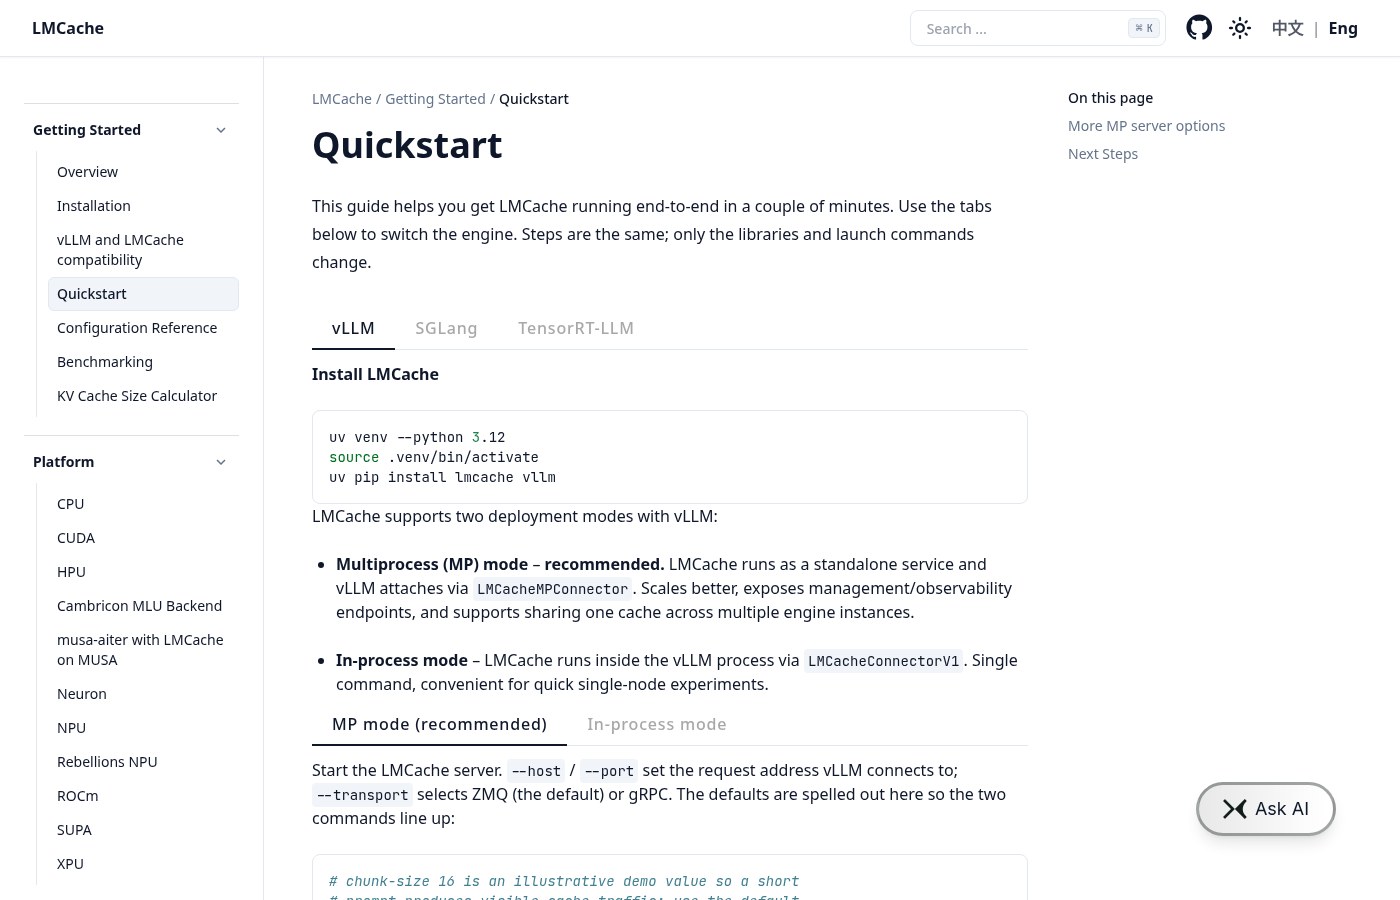
vLLM:コネクタの要点
公式の統合ページでは、2種類の一般的な接続方法が説明されています(名称はバージョンの更新に伴い変更される場合がありますので、接続前にご利用のvLLMのバージョンを確認してください):
- LMCacheMPConnector / マルチプロセス・コネクタ:エンジンは、設定により起動済みの LMCache デーモンを指すように構成されます。複数のインスタンスで共有する本番環境に適しています。
- LMCacheConnectorV1 などのエンジン内のオプション:vLLMの「当ページ」フラグ/プラグインに関するドキュメントに従って有効化してください。チャンクサイズやストレージバックエンド(CPU/ディスク/リモート)と一致していることに注意してください。
# 手順の概要(ローカル以外での検証用コマンド)
# 1) LMCache デーモンを起動する(ポート/保存パスは lmcache.yaml に従う)
lmcache server --host 127.0.0.1 --port 5556 --l1-size-gb 4 --eviction-policy LRU
# 2) vLLM を起動し、ドキュメントに記載されている LMCache コネクタの設定項目を有効にする
#    (具体的な CLI / 環境変数名は、vLLM × LMCache 統合ページを参照)
vLLM サイドチェックリスト
- エンジンバージョンとコネクタ名が互換性一覧表に記載されているか
- daemon のアドレス、シリアライズプロトコル、チャンクサイズがエンジンと一致しているか
- 安定したプレフィックス(system / RAGの固定セグメント)のみをキャッシュし、変動の激しいトークンがCPUプールを埋め尽くすのを防ぐべきか
- TTFT/キャッシュヒット指標を確認する。ヒットがない場合は、ハッシュのアラインメントとトークナイザーの一致性をまず確認する。
SGLangからの連絡:マルチプロセスのみ
SGLang 公式の README(python/sglang/srt/mem_cache/storage/lmcache/README.md)と LMCache examples/sgl_integration 「連携して進む」と明記する MP(エンジンコードのデフォルト設定 LMCacheMode.MP),まず独立したデーモンを起動し、その後エンジンに追加する必要があります --enable-lmcache とともに --lmcache-config-file(YAML 提供 mp_host/mp_port)。「in-process」や「設定のみ」と仮定してはいけません。 LMCACHE_CONFIG_FILE 環境変数を設定するだけで済みます。
# 参考(本機での検証ではありません。SGLang LMCacheのREADMEおよびexamples/sgl_integrationの当日の内容を基準としています)
# ターミナル 1
lmcache server --host 127.0.0.1 --port 5556 --l1-size-gb 4 --eviction-policy LRU
# ターミナル 2
# python -m sglang.launch_server ... --enable-lmcache --lmcache-config-file lmcache_config.yaml
- まず LMCache デーモンの正常動作を個別に確認してから、SGLang を起動してください。
- YAML の
mp_host/mp_portdaemon のリスニング設定と一致している必要があります。 - SGLang または LMCache のいずれかをアップグレードした後は、互換性に関する説明を再確認してください。旧バージョンのクイックスタートに記載されているインプロセス方式は、すでに時代遅れになっている可能性があります。
設定と制限(公開前に必ずお読みください)
- ストレージ階層:CPU DRAM → ローカルディスク → リモート;距離が遠くなるほどレイテンシが高くなるため、アクセス頻度の低いKVに適している。
- 接頭辞の安定性:tokenize / ツール一覧 / 固定されたRAGブロックのみが共有する価値がある。ラウンドごとに大きく変化するユーザーメッセージについては、セッションをまたいでヒットすることを期待すべきではない。
- 正しさ:KVの再利用は、トークナイザーとモデルのバージョンが一致していることを前提としています。モデルを変更したり、特殊なトークンを変更したりする場合は、キャッシュプールをクリアするか、隔離する必要があります。
- 運用・保守:daemon がダウンしても、エンジンが直ちにクラッシュするわけではありませんが、hit はゼロに戻ります。監視と再起動の対策が必要です。
- 安全性:リモート KV にはヒント情報が含まれている可能性があり、機密データポリシーに従って暗号化およびアクセス制御が行われます。
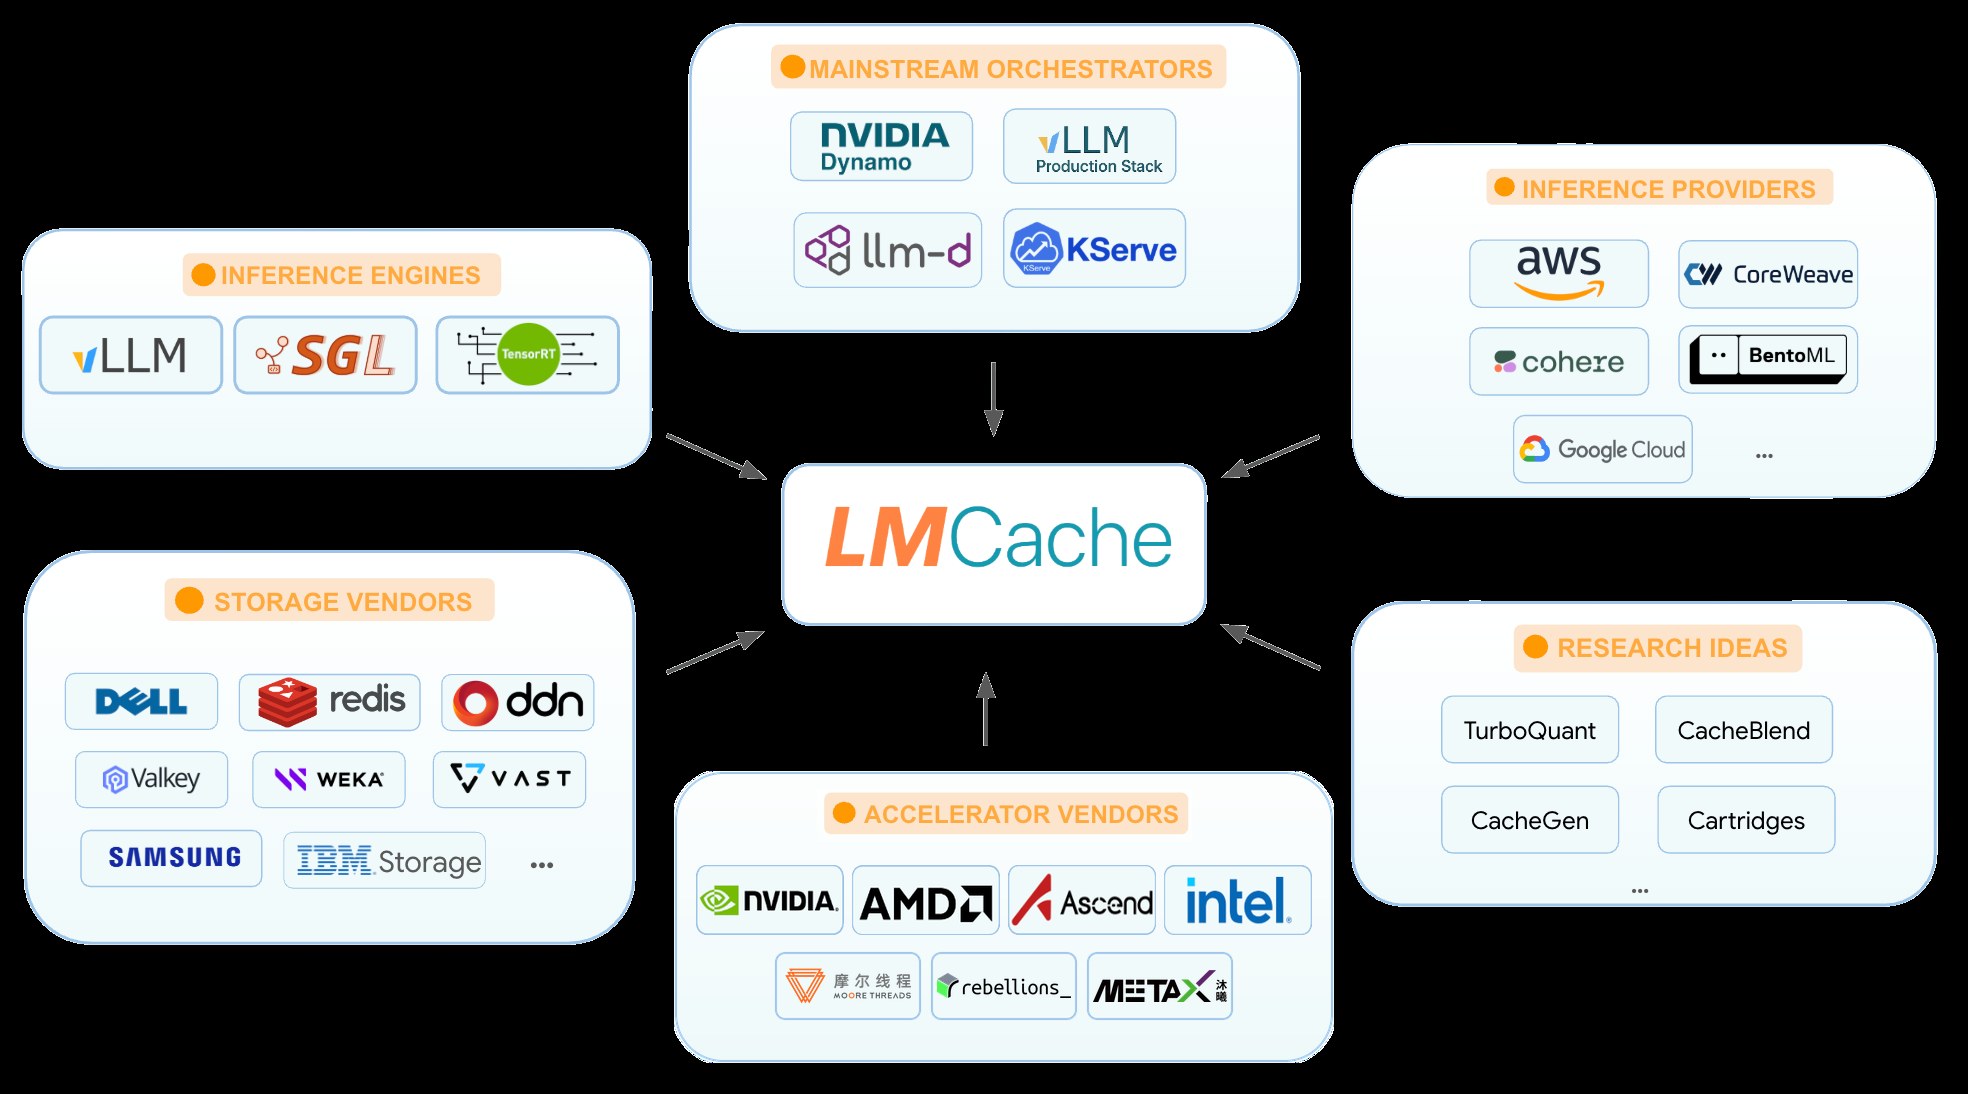
証拠の説明:「手順と能力の限界」より抜粋 docs.lmcache.ai(インストール/クイックスタート/デプロイメントモード/エコシステム)および GitHub LMCache/LMCacheそしてexamples/sgl_integrationそしてSGLang LMCache README(2026年11月5日 確認済み。元のドキュメントパス production/integrations/sglang は404エラーとなっている)。この環境には対応するGPU推論スタックがないため、スループットの比較や「正常に動作した」ことを示すスクリーンショットは提供しない。コマンドブロックは、ドキュメントパスの例を示すためのもののみである。
参考リンク
- LMCache ドキュメント
- インストール · クイックスタート
- GitHub · LMCache/LMCache
- vLLM ドキュメント(LMCacheコネクタは、統合ページに記載された日付を基準とします)
- SGLang · LMCache README
- LMCache · examples/sgl_integration


评论列表 (0条):
加载更多评论 読み込み中...