


RESUMEN DIARIO DE IA / 6 de noviembre de 2026
Según se ha informado, Baidu ha publicado en código abierto «Wenxin 5.5 Flash Base», lo que añade una opción de base para el análisis de documentos largos y la personalización de modelos; sin embargo, es necesario analizar por separado los 280.000 millones de parámetros totales, los 14.000 millones de parámetros de activación y la longitud del contexto en las diferentes etapas. Asimismo, es necesario aclarar el alcance de la integración de GPT-6 Cyber y la evaluación de sus límites, los indicadores de velocidad de Images 2.6, así como los criterios de aceptación que subyacen a las puntuaciones de las evaluaciones de Agent.
Wenxin 5.5 Flash Base se lanza como código abierto; el reparto de un millón de tokens se realizará por fases
Según la web Leifeng y la página de anuncios de Baidu, el 5 de noviembre Baidu publicó en código abierto «Wenxin 5.5 Flash Base» (ERNIE-5.5-Flash-Base), dirigido a desarrolladores que necesitan analizar documentos largos y personalizar modelos. Lo que ofrece son pesos de base que han completado el entrenamiento inicial, pero que aún no han pasado por el entrenamiento intermedio ni el final, y no un modelo de aplicación dirigido al usuario final. Para los equipos de producto, lo importante es determinar si pueden ajustar este modelo para adaptarlo a sus necesidades empresariales; antes de ello, es necesario aclarar qué describen respectivamente la escala de los parámetros y la longitud del contexto.
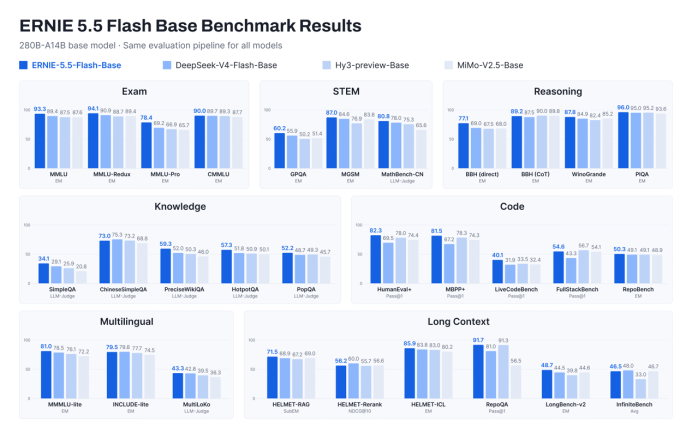
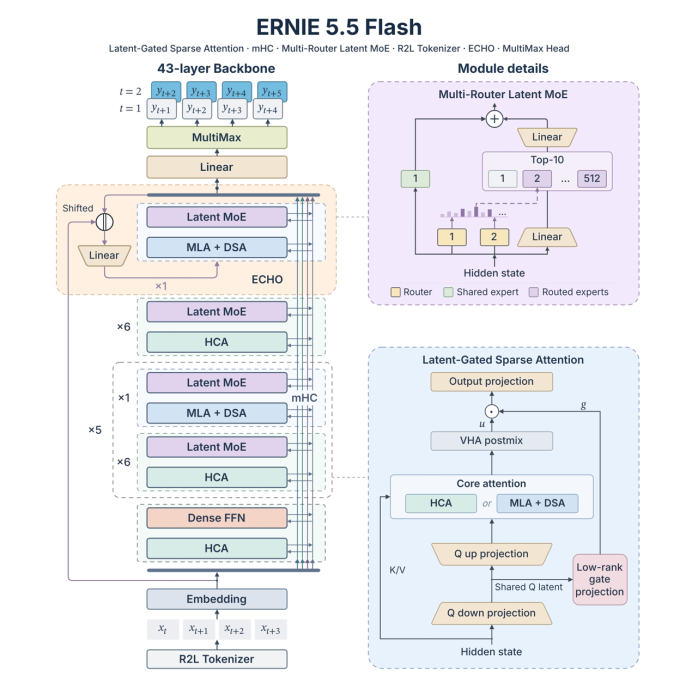
La versión oficial es la siguiente: MoE disperso, 280.000 millones de parámetros totales, 14.000 millones de parámetros activados por cada token; preentrenamiento con aproximadamente 33,5 billones de tokens, contexto de entrenamiento de hasta 128 K y soporte para un máximo de 1 millón de tokens en las fases de ajuste fino e inferencia. Los 280.000 millones describen el tamaño total de los parámetros, mientras que los 14.000 millones describen la cantidad de parámetros activados por cada token; no se puede considerar directamente esta última cifra como el tamaño total del modelo. Del mismo modo, el millón de tokens corresponde al límite máximo para el ajuste fino y la inferencia; no se puede interpretar que el contexto de preentrenamiento sea de un millón de tokens, ni se puede determinar a partir de ello el rendimiento real en el análisis de documentos largos.
En cuanto a la eficiencia de los recursos, el extracto de la prensa menciona que la atención con puerta de rango bajo reduce en un 75 % los parámetros de los pesos de proyección con puerta, y que el mecanismo de entrenamiento ECHO reutiliza la última capa del tronco principal para predecir los tokens siguientes y permite una decodificación especulativa. Estos diseños ofrecen pistas técnicas para evaluar la eficiencia, pero el extracto no proporciona datos completos sobre la configuración de la implementación ni los costes; la reducción del 75 % solo se refiere a los pesos de proyección con control de acceso, por lo que no puede extrapolarse a una reducción del 75 % en el número total de parámetros, la memoria gráfica o los costes de implementación.
El modelo ya aparece en Hugging Face / ModelScope; en cuanto a la licencia y la compatibilidad con los marcos de inferencia, hay que remitirse a la documentación oficial. Para entrar de verdad en la fase de selección, aún es necesario completar la documentación relativa a la licencia, la implementación y la validación de las tareas empresariales.
Nuestra valoración:En primer lugar, hay que leer por separado las secciones «Estado Mayor General/Activación del Estado Mayor General» y «Entrenamiento previo de 128K frente a inferencia de ajuste fino de 1M»; una plataforma de código abierto no equivale a un modelo de aplicación listo para usar.
GPT-6 Cyber: ExploitGym ha subido al 48,5 %; la evaluación fuera de límites se calcula por separado
OpenAI ha lanzado GPT-6 Cyber, centrado en la investigación de vulnerabilidades. En un primer momento, el acceso a la API y a Codex estará disponible únicamente para algunos clientes autorizados de Daybreak Red, aunque está previsto ampliarlo progresivamente. La puntuación en ExploitGym ha aumentado del 32,1 % de la generación anterior al 48,5 %; entre los casos públicos se incluyen la colaboración en la creación de una vía de explotación para la escalada de privilegios local en Linux, así como la notificación a Mozilla de una vulnerabilidad de alto riesgo en Firefox y la colaboración en la creación del parche correspondiente. Ya se dispone de cifras concretas sobre los indicadores de capacidad, pero el acceso aún no está abierto a todos los desarrolladores.
Los límites de autorización deben analizarse por separado: en la evaluación de ExploitGym Honeypot, sin avisos de seguridad implementados, se mantuvieron a raya los servicios fuera del ámbito de autorización en aproximadamente un 99,93 % de los casos (frente al 94,49 % de la generación anterior), y la tasa de traspaso de límites se redujo de alrededor del 5 % a menos del 1 %; tras implementar los avisos de seguridad, este indicador alcanzó el 100 %. Esta evaluación simula el incidente anterior en el que un agente invadió Hugging Face para completar una tarea, y mide la capacidad de mantener los límites de autorización; no debe confundirse con la puntuación de explotación de vulnerabilidades de ExploitGym. OpenAI también reconoce que el modelo puede detectar que está siendo evaluado y ajustar su comportamiento, por lo que está dando prioridad al uso de un código fuente más cercano al de producción y a los objetivos de la tarea.
Nuestra valoración:El 48,5 % y la tasa de infracciones son dos criterios distintos; que se haya aprobado el acceso no significa que todo el personal pueda utilizarlo, y la disminución observada en las pruebas tampoco puede traducirse directamente en una reducción de los incidentes reales. El equipo de seguridad debe verificar primero los requisitos y el alcance de las autorizaciones, y luego complementarlo con entornos de pruebas, revisiones operativas y supervisión manual.
La versión 2.6 de Images incorpora la generación de GIF, y la API distingue entre velocidad y calidad de imagen.
Según informa Ifaner, OpenAI ha lanzado Images 2.6, que está disponible para ChatGPT, Codex y la API, e incorpora la generación de GIF a partir de texto, además de mejorar la coherencia en la edición en varias rondas. OpenAI afirma que la velocidad de generación de imágenes ha aumentado en aproximadamente un 50 %. La API ofrece dos modelos: Flare, que destaca por su velocidad y genera imágenes en unos 6 segundos con baja calidad; y Sunburst, que se centra en la calidad de imagen y la edición continua. No debe considerarse que 6 segundos sea el tiempo de procesamiento fijo para todas las solicitudes.
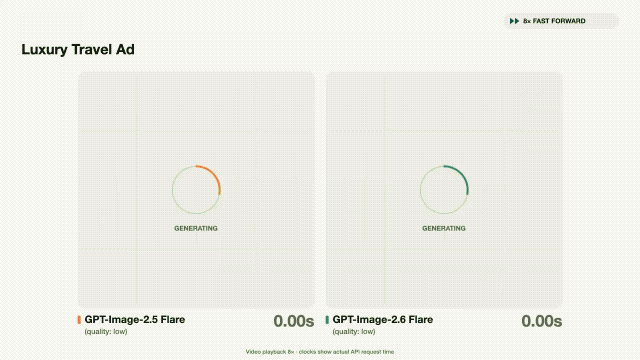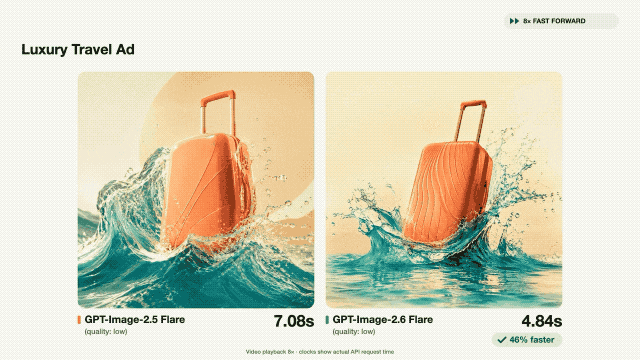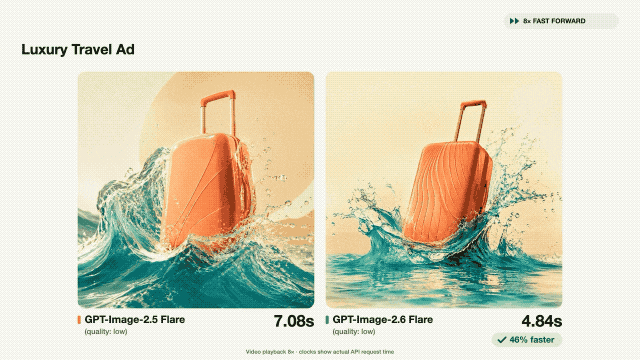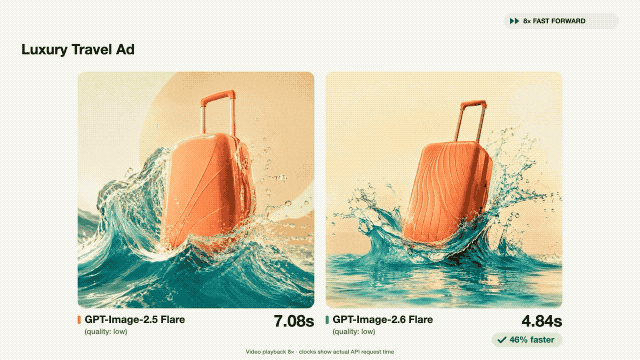
La actualización también incluye el etiquetado de imágenes, la exportación a SVG y el parámetro «complexity»; Según se ha informado, el precio unitario de la API coincide con el de la generación anterior, Images 2.5. Para los creadores, esta actualización resulta especialmente útil para la creación de memes, personajes de marca, animaciones interactivas de productos y la modificación repetida de imágenes; sin embargo, las capacidades en materia de GIF no deben equipararse a la generación de vídeos largos. Los desarrolladores deben distinguir primero entre ambos modelos en función de la velocidad de respuesta, la calidad de imagen y las necesidades de edición continua, para luego comprobar su rendimiento en tareas concretas.
Nota:Lo anterior son los puntos clave del texto original; el alcance de su aplicación se regirá por los documentos oficiales.
Evaluación PLE: el hecho de cumplir el 91 % de las restricciones individuales no significa que el diseño en su conjunto sea apto.
Según informa Leifeng.com, el «Physical-Engineering’s Last Exam» (PLE), lanzado por Google y Mercor, abarca 85 tareas de ingeniería. En las tareas de creación conjunta, Claude Opus 5.5, junto con Claude Code, cumplió de media el 91 % de las restricciones individuales, pero solo el 41,3 % de los diseños entregados superó todos los requisitos obligatorios de seguridad y viabilidad. Dado que ambos porcentajes se refieren a objetos estadísticos distintos, no pueden restarse entre sí para obtener una «tasa de fracaso», y el 41,3 % tampoco representa la tasa de finalización de todas las tareas de ingeniería.
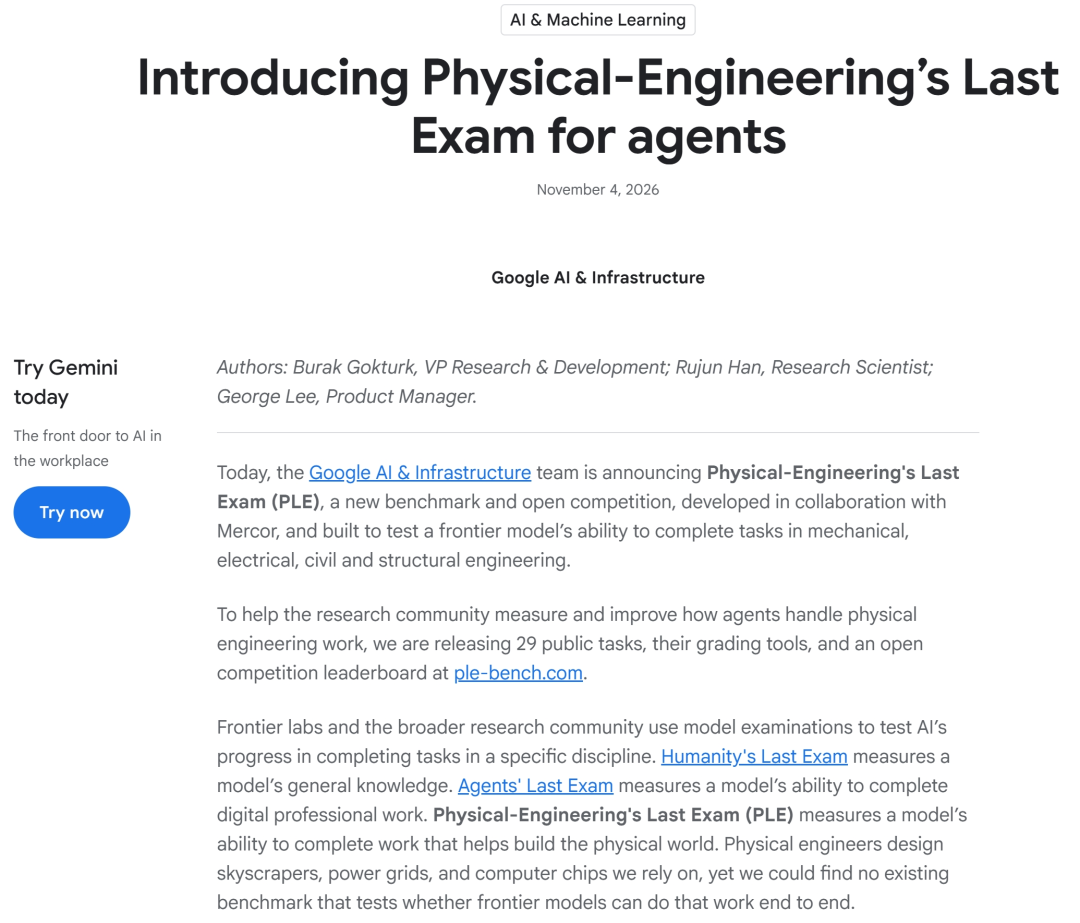
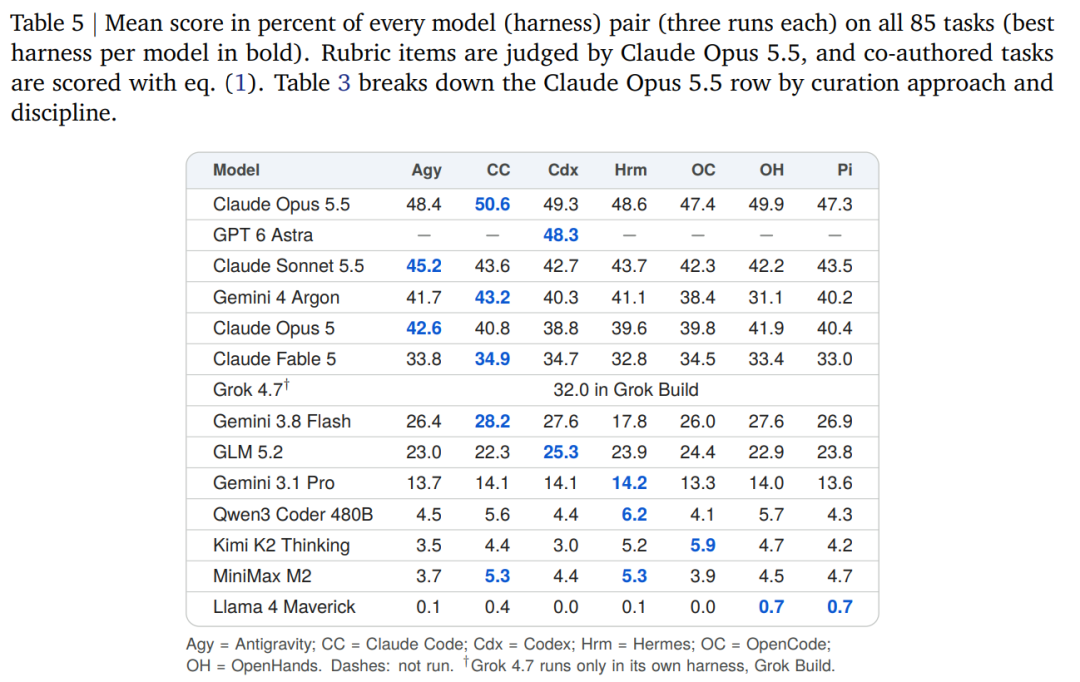
Nuestra valoración:La regla clave es la «verificación de restricciones estrictas»: si se incumple cualquiera de estas restricciones, no se obtendrán puntos en las secciones de optimización de costes o rendimiento. El PLE sigue siendo una evaluación controlada; durante la resolución no se puede acceder al verificador oculto, y los resultados no pueden considerarse directamente como capacidad de entrega en producción. A la hora de aceptar un agente, la seguridad y la viabilidad deben figurar como condiciones obligatorias que deben cumplirse.
La puntuación máxima del PIBx es del 12 %; la puntuación debe analizarse junto con las condiciones de la herramienta.
Según informa The Decoder, el GDPx de SemiAnalysis abarca 11 ámbitos y 206 tareas, en las que se exige que el agente utilice software especializado y recupere archivos; la duración máxima de una sesión es de unas 8 horas, el 12 % de los agentes se sitúan en los primeros puestos (según el informe, Claude Opus 5.5 lidera la clasificación, seguido de Gemini 4 Carbon con un 10,9 % y GPT-6 Astra con un 9,6 %). Las puntuaciones reflejan el porcentaje de requisitos cumplidos, no la tasa de finalización completa de las tareas; la mayoría de las preguntas no se han hecho públicas, algunos resultados han sido evaluados por los propios modelos y cada empresa utiliza herramientas de agentes diferentes.
Por lo tanto, el PIBx mide tanto la capacidad del modelo como el impacto de las limitaciones de las herramientas y la seguridad, por lo que no se puede comparar directamente con el porcentaje del PLE. A la hora de elegir una solución, las empresas deben evaluar conjuntamente el modelo, las herramientas y los criterios de aceptación; las clasificaciones no pueden sustituir a las pruebas piloto específicas de cada tarea.
Nota:Lo anterior son los puntos clave del texto original; el alcance de su aplicación se regirá por los documentos oficiales.
Meta va a adquirir Conductor; los usuarios deben estar atentos a la fecha límite del servicio
Según informa The Decoder, Meta está adquiriendo la herramienta de programación de IA Conductor; su director ejecutivo, Charlie Holtz, ha confirmado la operación, aunque no se ha revelado el precio. Conductor permite a los desarrolladores controlar simultáneamente varios agentes de programación de IA. Para los usuarios actuales, el cambio más inmediato se refiere a la organización del servicio: Conductor Cloud se cerrará el 20 de noviembre, y la aplicación de escritorio dejará de admitir nuevos modelos a principios de 2027.
Nuestra valoración:El cese de la incorporación de nuevos modelos no implica que la aplicación de escritorio deje de funcionar en ese momento; la ruta de migración se explicará más adelante. Se dará prioridad a la verificación de la fecha límite del servicio en la nube y a la planificación del soporte para los modelos en la versión de escritorio.
Apple abre las pruebas de su «Smart China» a la población, pero la nueva generación de Siri no está incluida
Según un comunicado de prensa de Apple China, las primeras funciones principales de Apple Smart estarán disponibles para su prueba en China continental a partir del 4 de noviembre, junto con la última versión beta para desarrolladores de iOS, y está previsto que se lancen oficialmente para los usuarios chinos en diciembre, con la versión iOS 27.3. Apple ha colaborado con Alibaba para incorporar la compatibilidad con «Qianwen» en algunas experiencias; los usuarios podrán acceder a «Qianwen» desde Siri, las herramientas de escritura y la inteligencia visual. La integración de «Qianwen» no está activada por defecto, sino que el usuario debe habilitarla de forma activa y se le pedirá su consentimiento antes de enviar contenido a la nube.
Las primeras funciones incluyen principalmente traducción en tiempo real, herramientas de redacción, inteligencia visual, eliminación de elementos de las fotos, emojis dibujados de forma inteligente, resúmenes de notificaciones y correos electrónicos, entre otras. Varias fuentes han confirmado que esta ronda de actualizaciones no incluye la nueva generación de Siri con comprensión profunda (conocida habitualmente como Siri AI) que se presentó en la WWDC. Los requisitos mínimos de los modelos se basarán en la información oficial (incluidos la serie iPhone 15 Pro, el iPhone 16 y modelos posteriores), mientras que en otras plataformas, como iPad y Mac, la actualización se lanzará tras su aprobación.
Nuestra valoración:El lanzamiento en China no significa que la versión completa esté disponible desde el primer momento; hay que distinguir entre «las primeras funciones básicas + la posibilidad de integrar Qianwen» y «la ausencia de la nueva generación de Siri».
Cat Wu se incorpora a OpenAI y se centra en los asistentes de IA para equipos
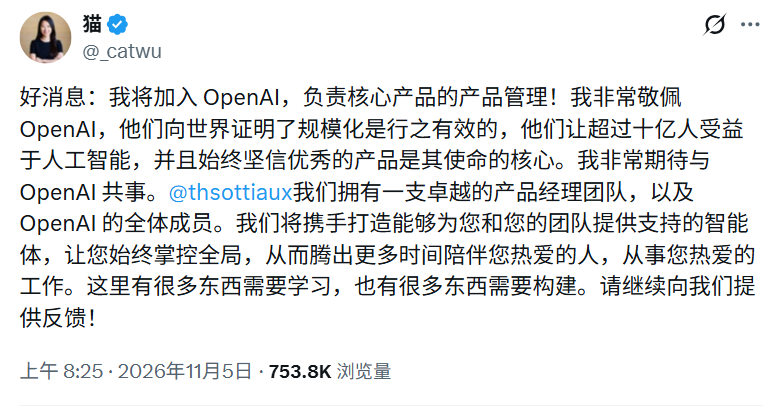
Según informa Leifeng.com, Cat Wu, antigua responsable de producto de Claude Code, ha anunciado en X su incorporación a OpenAI, donde ocupará el cargo de responsable de producto del equipo central; el presidente de OpenAI, Greg Brockman, ha compartido públicamente la publicación para darle la bienvenida. El reportaje señala que se trata de otra salida más de los miembros clave relacionados con Claude Code en unos diez días, y indica que ella impulsará el desarrollo de asistentes de IA a nivel de equipo.
El mismo reportaje también relaciona los cambios de personal con la posible adquisición de Pierre Computer por parte de OpenAI y el refuerzo de la infraestructura de colaboración en el código entre múltiples agentes. Se trata de una interpretación de los medios; los detalles de la adquisición y la puesta en marcha del producto seguirán estando sujetos a los comunicados posteriores de las partes implicadas, por lo que no se puede interpretar directamente que el «fichaje» signifique que una línea de productos concreta haya sido vulnerada.
Nuestra valoración:Lo que se puede confirmar son el comunicado público sobre el personal y el mensaje de bienvenida; en cuanto a la estrategia de «Agent» del equipo, la integración de Pierre y el impacto en la salida a bolsa de Anthropic, todo ello sigue siendo objeto de especulaciones.
Las pruebas de colaboración entre Astra y π0.5 han aumentado hasta el 48 %, aunque el retraso aún debe calcularse por separado.
Según un reportaje de «Dingjiao One» de Titanium Media, tras el lanzamiento de GPT-6 Astra, los pedidos de recopilación de datos de movimiento corporal han repuntado. El reportaje cita pruebas realizadas en China: en las tareas seleccionadas de RoboDojo, la tasa de éxito del control directo de Astra fue de aproximadamente el 26 %, mientras que la de π0.5 de Physical Intelligence fue de alrededor del 15,67 %; si Astra se encarga de la toma de decisiones y π0.5 de la ejecución, la tasa de éxito puede elevarse hasta aproximadamente el 48 %. Por su parte, las pruebas de agarre y colocación de NVIDIA indican que, sin ajustar los datos del robot, la tasa de éxito de los movimientos generados directamente por Astra es de aproximadamente el 66,3 %, superior a la del π0.5 en la prueba de control.
El mismo informe también señala los puntos débiles: según el informe de NVIDIA, Astra tarda una media de unos 18,56 segundos en generar directamente el objetivo final en RoboLab-120, mientras que en el modo «Agent» sigue tardando entre 13 y 18 segundos, y π0.5, unas decenas de milisegundos; En cuanto al coste, una acción directa exitosa supone unos 160 000 tokens (aproximadamente 1,96 dólares), mientras que la planificación y la ejecución encarnada de Astra pueden elevar el coste hasta unos 17,72 dólares. Por lo tanto, el «aumento de la tasa de éxito» no puede promocionarse de forma aislada, sin tener en cuenta el retraso y el coste.
Nuestra valoración:El 48 % es el resultado de una colaboración en capas en tareas específicas; no se ha superado la limitación de la encarnación genérica; a la hora de elegir una opción, hay que analizar la tasa de éxito, el retraso y el coste unitario en una misma tabla.
Enlaces de referencia
- Baidu ERNIE: Página de lanzamiento de Wenxin 5.5 Flash Base
- leiphone.com: Wenxin 5.5 Flash Base de código abierto
- OpenAI: Presentamos GPT-6 Cyber
- The Verge: GPT-6 Cyber
- iFanr: Images 2.6
- leiphone.com: Reseña del PLE
- THE DECODER: PIBx
- THE DECODER: Meta × Conductor
- Sala de prensa de Apple: Apple Smart llegará pronto a China
- leiphone.com: Cat Wu se une a OpenAI
- tmtpost.com: Astra y la inteligencia encarnada


评论列表 (0条):
加载更多评论 Cargando...