


AI DAILY BRIEF / 06.11.2026
Segundo notícias, a Baidu disponibilizou em código aberto o Wenxin 5.5 Flash Base, acrescentando uma opção de base para a análise de documentos longos e a personalização de modelos; no entanto, os 280 mil milhões de parâmetros totais, os 14 mil milhões de parâmetros ativos e o comprimento do contexto nas diferentes fases devem ser analisados separadamente. Outros aspetos que também requerem uma interpretação clara incluem o âmbito de aplicação do GPT-6 Cyber e a avaliação de ultrapassagens de limites, os indicadores de velocidade do Images 2.6, bem como os critérios de aceitação subjacentes às pontuações das avaliações do Agent.
O Wenxin 5.5 Flash Base foi disponibilizado como código aberto; a distribuição de 1 milhão de tokens será feita em fases
De acordo com o site Leifeng e a página de lançamento da Baidu, a Baidu disponibilizou em código aberto, a 5 de novembro, o Wenxin 5.5 Flash Base (ERNIE-5.5-Flash-Base), destinado a programadores que necessitem de análise de documentos longos e personalização de modelos. O que é fornecido são pesos de base cujo pré-treino já foi concluído, mas que ainda não passaram por treino intermédio ou pós-treino, e não um modelo de aplicação destinado ao utilizador final. Para as equipas de produto, o que importa é saber se é possível, com base nisso, ajustar o modelo de forma a adequá-lo aos seus negócios; antes disso, é necessário esclarecer o que a «escala dos parâmetros» e o «comprimento do contexto» descrevem, respetivamente.
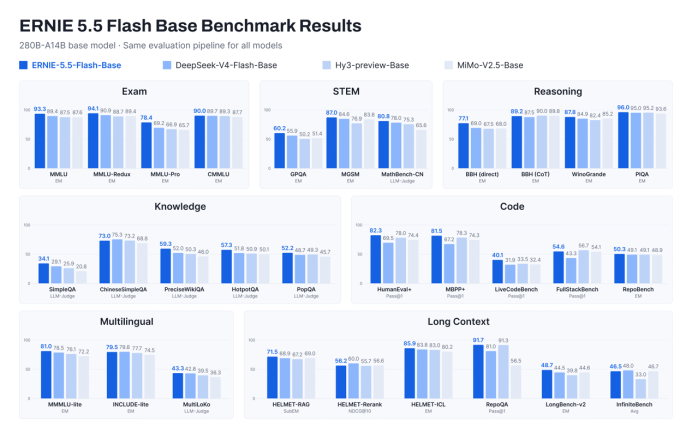
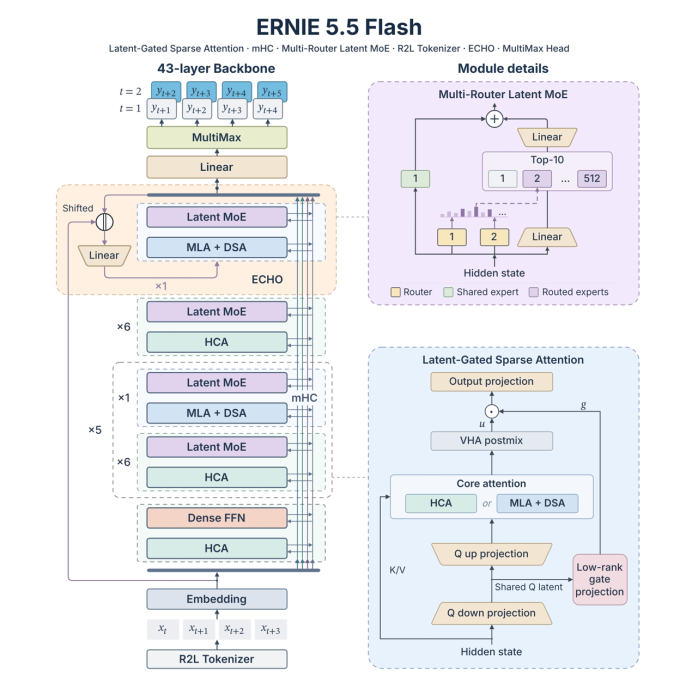
A versão oficial é a seguinte: MoE esparso, 280 mil milhões de parâmetros no total, 14 mil milhões de parâmetros ativados por cada token; pré-treino com cerca de 33,5 biliões de tokens, contexto de treino máximo de 128 K, e suporte para um máximo de 1 milhão de tokens nas fases de afinação e inferência. Os 280 mil milhões referem-se à escala total de parâmetros, enquanto os 14 mil milhões descrevem a quantidade de parâmetros ativados por cada token; não se pode considerar este último valor como o tamanho total do modelo. Da mesma forma, o limite de 1 milhão de tokens corresponde ao limite máximo para as fases de afinação e inferência; não se pode interpretar que o contexto de pré-treino seja de 1 milhão de tokens, nem se pode, com base nisso, determinar a eficácia real na análise de documentos longos.
No que diz respeito à eficiência de recursos, os excertos da imprensa referem que a atenção com porta de baixo grau reduz os parâmetros de ponderação da projeção com porta em 75%, e que o mecanismo de treino ECHO reutiliza a previsão da última camada do backbone para os tokens subsequentes, podendo ainda servir para a descodificação especulativa. Estes designs fornecem pistas técnicas sobre a eficiência da avaliação, mas o excerto não apresenta dados completos sobre a configuração de implementação nem sobre os custos; a redução de 75% diz respeito apenas aos pesos de projeção com porta de ativação, não podendo ser extrapolada para uma redução de 75% no total de parâmetros, na memória de vídeo ou nos custos de implementação.
Os pesos já estão disponíveis no Hugging Face / ModelScope; no que diz respeito à licença e à compatibilidade com as estruturas de inferência, deve-se continuar a consultar a documentação oficial. Para entrar efetivamente na fase de seleção, ainda é necessário reunir provas relativas à licença, à implementação e à validação das tarefas operacionais.
A nossa opinião:Comece por analisar separadamente os conceitos de «Estado Geral/Estado Ativo» e «Pré-treino de 128K vs. Inferência de Ajustamento Fino de 1M»; uma plataforma de código aberto não é sinónimo de um modelo de aplicação pronto a utilizar.
GPT-6 Cyber: O ExploitGym subiu para 48,5%, sem contar a avaliação fora dos limites
A OpenAI lançou o GPT-6 Cyber, dedicado à investigação de vulnerabilidades. Inicialmente, o acesso à API e ao Codex estará disponível apenas para alguns clientes aprovados do Daybreak Red, estando prevista uma expansão gradual. A pontuação no ExploitGym subiu de 32,1% na geração anterior para 48,5%; entre os casos divulgados contam-se a colaboração na criação de uma via de exploração para elevação de privilégios local no Linux, bem como a divulgação à Mozilla de uma falha de segurança de alto risco no Firefox e a colaboração na criação de um patch. Já existem números concretos relativos aos indicadores de desempenho, mas o acesso ainda não está aberto a todos os programadores.
Os limites de autorização devem ser analisados separadamente: na avaliação do ExploitGym Honeypot, sem a implementação de avisos de segurança, os serviços fora do âmbito foram protegidos em cerca de 99,93% dos casos (contra cerca de 94,49% na geração anterior), com a taxa de ultrapassagem dos limites a diminuir de cerca de 5% para menos de 1%; com a implementação dos avisos de segurança, este valor atingiu os 100%. Esta avaliação simula o incidente anterior em que um agente invadiu o Hugging Face para completar uma tarefa, testando a capacidade de manter os limites de autorização; não deve ser confundida com a pontuação de exploração de vulnerabilidades do ExploitGym. A OpenAI também reconhece que o modelo pode identificar que está a ser testado e ajustar o seu comportamento, pelo que está a dar prioridade à utilização de um conjunto de código real mais próximo do ambiente de produção e dos objetivos da tarefa.
A nossa opinião:48,5 % e a taxa de violação são dois critérios distintos; a aprovação do acesso não significa que esteja disponível para todos, e a diminuição observada nos testes não pode ser diretamente interpretada como uma redução real do número de incidentes. A equipa de segurança deve, em primeiro lugar, verificar as qualificações e o âmbito das autorizações, e depois complementar essa verificação com o uso de ambientes de teste, revisão de operações e supervisão manual.
A versão 2.6 do Images inclui a criação de GIFs, com a API a distinguir entre velocidade e qualidade de imagem
Segundo uma reportagem do Ifaner, a OpenAI lançou o Images 2.6, disponibilizando-o para o ChatGPT, o Codex e a API, com a nova funcionalidade de geração de GIFs a partir de texto e melhorias na consistência da edição em várias etapas. A OpenAI afirma que a velocidade de geração de imagens aumentou cerca de 50%. A API disponibiliza dois modelos: o Flare, que privilegia a velocidade, gerando imagens em cerca de 6 segundos na qualidade mais baixa; e o Sunburst, que se concentra na qualidade da imagem e na edição contínua. Os 6 segundos não devem ser considerados como o tempo de processamento fixo para todas as solicitações.
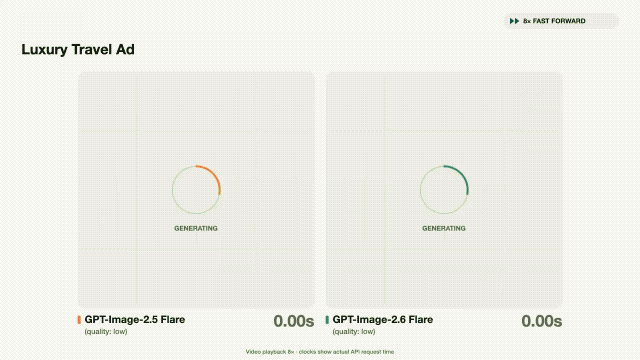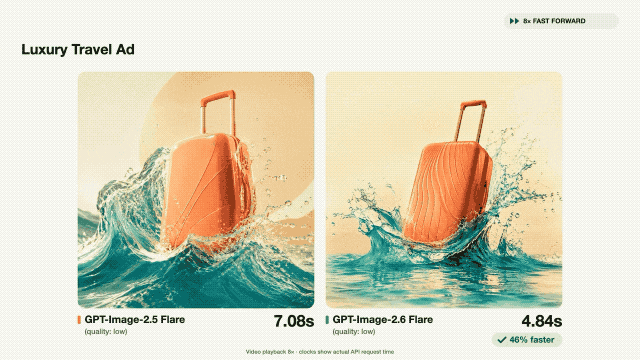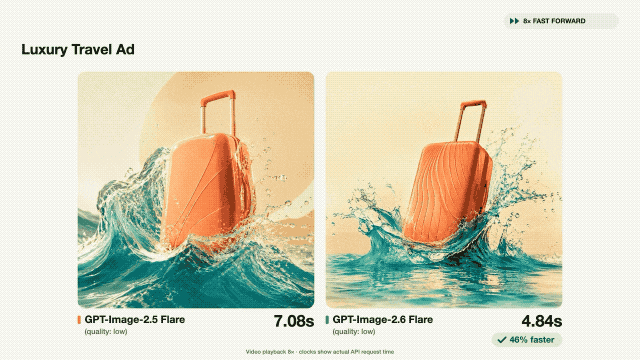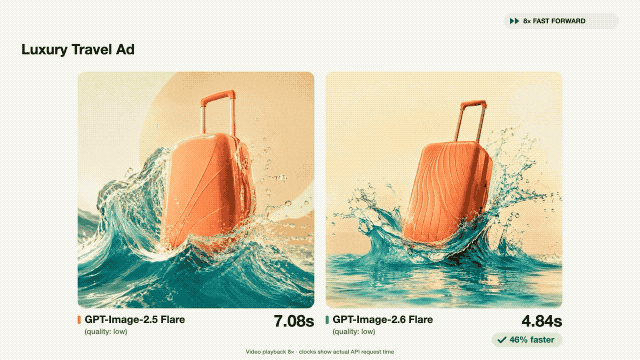
A atualização inclui também a marcação de imagens, a exportação para SVG e o parâmetro de complexidade; Segundo relatos, o preço unitário da API é idêntico ao da geração anterior, Images 2.5. Para os criadores, esta atualização serve mais diretamente a memes, personagens de marcas, animações interativas de produtos e edições repetidas de imagens; a capacidade de criar GIFs não deve ser equiparada à geração de vídeos longos. Os programadores devem, em primeiro lugar, distinguir os dois modelos com base na velocidade de resposta, na qualidade de imagem e nas necessidades de edição contínua, e só depois verificar o desempenho em tarefas específicas.
Nota:O que precede são os pontos-chave divulgados no texto original; o âmbito de aplicação deve ser considerado com base nos documentos oficiais.
Avaliação PLE: o facto de 91% das restrições individuais serem cumpridas não significa que o projeto na sua totalidade seja considerado aprovado
Segundo uma reportagem do site Leifeng, o «Physical-Engineering’s Last Exam» (PLE), lançado pela Google e pela Mercor, abrange 85 tarefas de engenharia. Nas tarefas de criação colaborativa, o Claude Opus 5.5, em combinação com o Claude Code, cumpriu, em média, 91% das restrições individuais, mas apenas 41,3% dos projetos entregues satisfizeram todos os requisitos obrigatórios de segurança e viabilidade. Uma vez que os dois índices se referem a objetos estatísticos diferentes, não podem ser subtraídos entre si para se obter uma «taxa de insucesso», e 41,3% não corresponde à taxa de conclusão de todas as tarefas de engenharia.
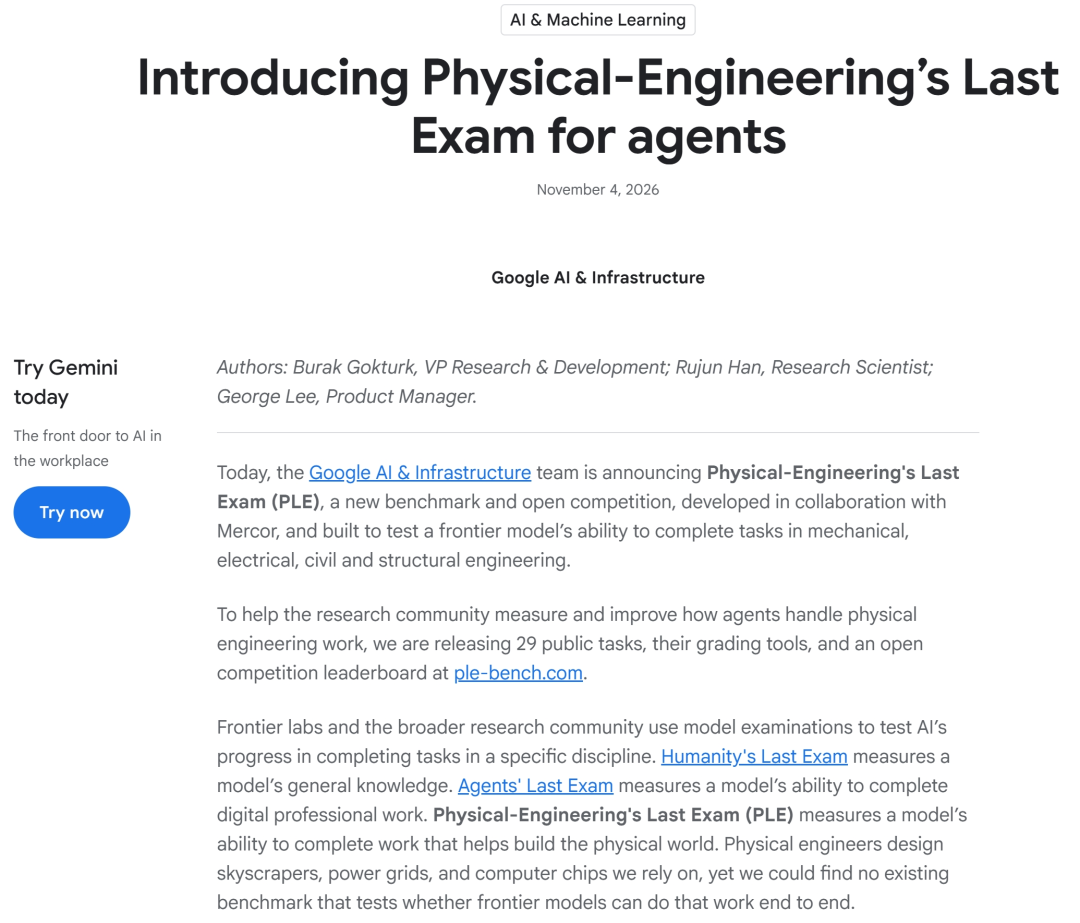
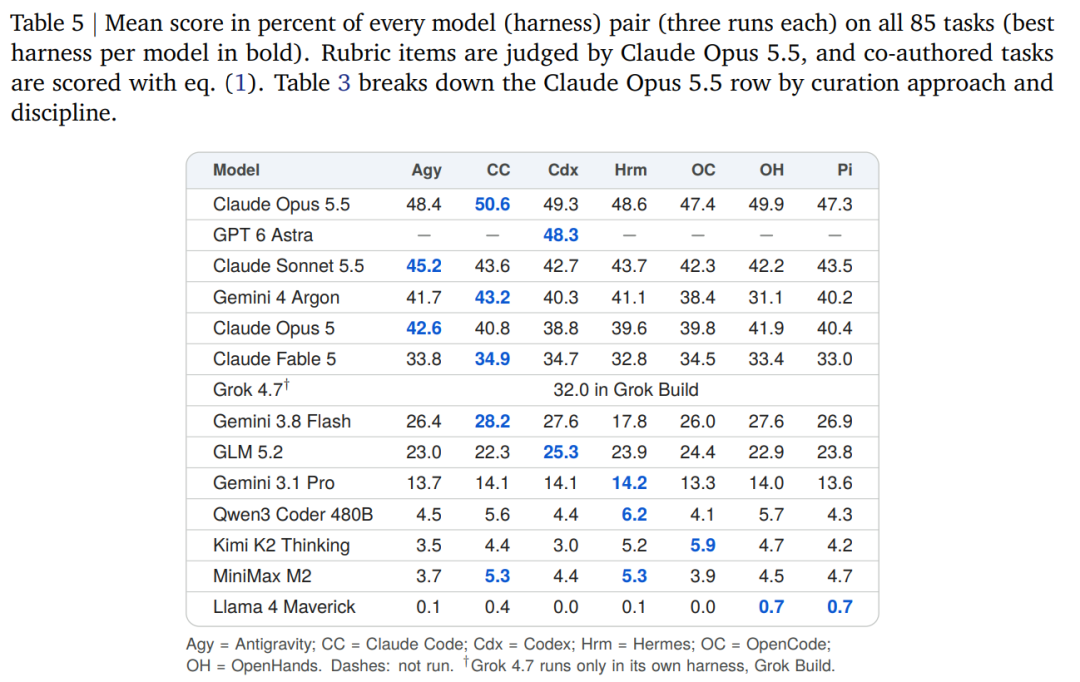
A nossa opinião:A regra fundamental é a «verificação de restrições rígidas»: a violação de qualquer uma dessas restrições implica a perda da pontuação na parte relativa à otimização de custos ou desempenho. O PLE continua a ser uma avaliação controlada; não é possível aceder ao verificador oculto durante a resolução, pelo que os resultados não podem ser considerados diretamente como capacidade de entrega em produção. Na aceitação do Agente, a segurança e a viabilidade devem ser consideradas condições obrigatórias a cumprir.
A pontuação máxima do GDPx é de 12%; a pontuação deve ser analisada em conjunto com as condições da ferramenta
De acordo com uma reportagem do The Decoder, o GDPx da SemiAnalysis abrange 11 áreas e 206 tarefas, exigindo que o agente utilize software especializado e recupere ficheiros, com uma duração máxima de execução de cerca de 8 horas por sessão, os primeiros classificados atingem cerca de 12% (segundo a reportagem, o Claude Opus 5.5 lidera, seguido pelo Gemini 4 Carbon com cerca de 10,9% e pelo GPT-6 Astra com cerca de 9,6%). As pontuações refletem a proporção de requisitos cumpridos e não a taxa de conclusão total das tarefas; a maioria das questões não foi divulgada, alguns resultados foram avaliados pelos próprios modelos e as ferramentas de agentes utilizadas por cada empresa também diferem.
Por conseguinte, o PIBx mede não só a capacidade do modelo, mas também inclui o impacto das limitações das ferramentas e de segurança, pelo que não pode ser comparado diretamente com a percentagem do PLE. Na escolha de uma solução, as empresas devem avaliar em conjunto o modelo, as ferramentas e as condições de aceitação; as listas de classificação não podem substituir os testes-piloto específicos para as suas próprias tarefas.
Nota:O que precede são os pontos-chave divulgados no texto original; o âmbito de aplicação deve ser considerado com base nos documentos oficiais.
A Meta está a adquirir a Conductor; os utilizadores devem estar atentos à data limite do serviço
De acordo com uma reportagem do The Decoder, a Meta está a adquirir a Conductor, uma ferramenta de programação de IA, tendo o CEO Charlie Holtz confirmado a transação, cujo valor não foi divulgado. O Conductor permite aos programadores controlar simultaneamente vários agentes de programação de IA. Para os utilizadores atuais, a mudança mais imediata diz respeito à organização do serviço: o Conductor Cloud será encerrado a 20 de novembro e a aplicação para computador deixará de aceitar novos modelos no início de 2027.
A nossa opinião:A suspensão da integração de novos modelos não significa que a aplicação para computador será desativada nessa altura; o plano de migração será explicado posteriormente. Verifique, em primeiro lugar, a data de término do serviço na nuvem e os planos de suporte aos modelos na versão para computador.
A Apple abre testes ao público para o seu dispositivo inteligente na China, mas a nova geração da Siri não está incluída
De acordo com um comunicado de imprensa da Apple China, as primeiras funcionalidades principais do Apple Smart estarão disponíveis para testes na China continental a partir de 4 de novembro, juntamente com a mais recente versão beta do iOS para programadores, estando previsto o seu lançamento oficial para os utilizadores chineses em dezembro, com o iOS 27.3. A Apple colaborou com a Alibaba para integrar o suporte ao «Qianwen» em algumas funcionalidades, permitindo que os utilizadores acedam ao «Qianwen» através da Siri, das ferramentas de escrita e da inteligência visual; a integração do «Qianwen» não está ativada por predefinição, sendo necessário que o utilizador a ative ativamente e que seja solicitado o seu consentimento antes de qualquer conteúdo ser enviado para a nuvem.
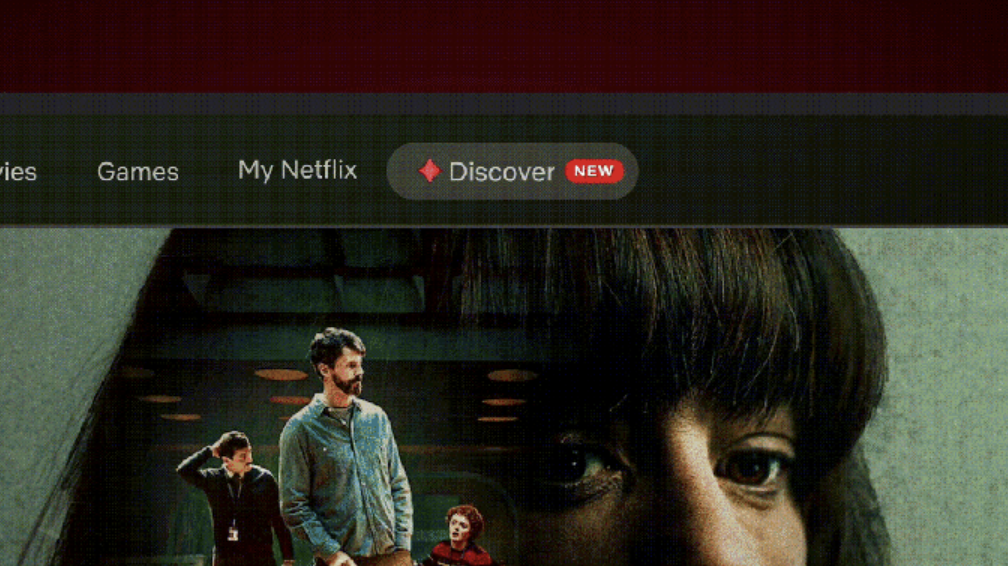
As primeiras funcionalidades incluem, principalmente, tradução em tempo real, ferramentas de escrita, inteligência visual, remoção de objetos das fotografias, emojis criados por IA, resumos de notificações e e-mails, entre outras. Várias reportagens confirmam que esta atualização não inclui a nova geração da Siri com compreensão profunda (comumente conhecida como Siri AI), apresentada na WWDC. Os requisitos mínimos dos modelos devem seguir as especificações oficiais (incluindo a série iPhone 15 Pro, o iPhone 16 e modelos posteriores), enquanto a disponibilização para outras plataformas, como iPad e Mac, está sujeita a aprovação.
A nossa opinião:O lançamento na China não significa que a versão completa esteja disponível de imediato; é importante distinguir entre «o conjunto inicial de funcionalidades básicas + integração opcional com o "Qianwen"» e «a ausência da nova geração do Siri».
Cat Wu junta-se à OpenAI e passa a dedicar-se aos assistentes de IA para equipas
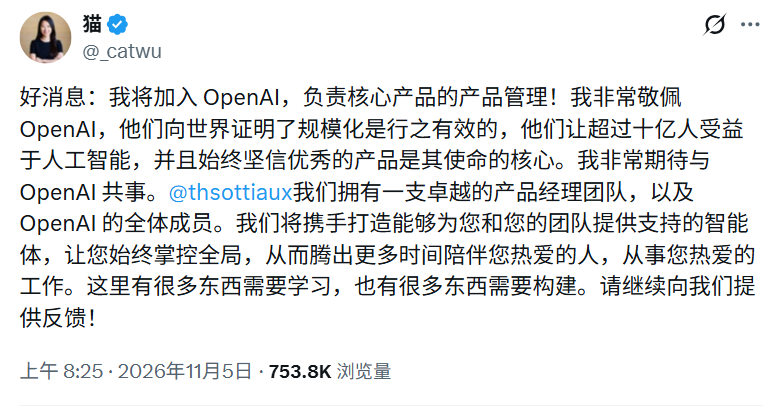
De acordo com uma notícia publicada no site Leifeng, Cat Wu, antiga responsável de produto da Claude Code, anunciou no X que se juntou à OpenAI, assumindo o cargo de responsável de produto da equipa de produtos principais; o presidente da OpenAI, Greg Brockman, partilhou publicamente a publicação para lhe dar as boas-vindas. A notícia refere que este é mais um caso de saída consecutiva de membros-chave relacionados com a Claude Code num período de cerca de dez dias, e indica que ela irá impulsionar a direção dos assistentes de IA ao nível da equipa.
A mesma reportagem também associou as mudanças de pessoal à intenção da OpenAI de adquirir a Pierre Computer e de reforçar a infraestrutura de colaboração de código entre múltiplos agentes. Trata-se de uma interpretação da comunicação social; os detalhes da aquisição e o lançamento do produto continuam a depender dos comunicados posteriores das partes envolvidas, não sendo possível interpretar a «contratação de pessoal» como se uma determinada linha de produtos já tivesse sido comprometida.
A nossa opinião:O que se pode confirmar são o comunicado público sobre recursos humanos e a publicação de boas-vindas; quanto à estratégia da equipa «Agent», à integração do Pierre e ao impacto no IPO da Anthropic, tudo isso ainda se encontra no domínio das especulações.
Os testes de colaboração entre o Astra e o π0.5 atingiram os 48%, sendo que a latência ainda tem de ser calculada separadamente
De acordo com uma reportagem do «Dingjiao One» da Titanium Media, após o lançamento do GPT-6 Astra, as encomendas de recolha de dados corporais voltaram a aumentar. A reportagem cita testes realizados na China: nas tarefas selecionadas do RoboDojo, a taxa de sucesso do controlo direto do Astra foi de cerca de 26%, enquanto a do π0.5 da Physical Intelligence foi de cerca de 15,67%; Se a decisão for tomada pelo Astra e a execução pelo π0.5, a taxa de sucesso pode subir para cerca de 48%. Os testes de preensão e colocação da NVIDIA indicam que, sem o ajuste fino com dados de robôs, a taxa de sucesso do Astra na execução direta de movimentos é de cerca de 66,3%, superior à do π0.5 no teste de comparação.
A mesma reportagem também enumera os pontos fracos: no relatório da NVIDIA, o Astra demora, em média, cerca de 18,56 segundos a gerar diretamente o objetivo final no RoboLab-120, enquanto no modo Agent demora ainda cerca de 13 a 18 segundos, e o π0.5 demora apenas algumas dezenas de milissegundos; em termos de custos, uma ação bem-sucedida com saída direta custa cerca de 160 000 tokens (cerca de 1,96 dólares), podendo o custo do Astra, incluindo planeamento e execução incorporada, ascender a cerca de 17,72 dólares. Por conseguinte, o «aumento da taxa de sucesso» não pode ser promovido isoladamente, sem ter em conta o atraso e os custos.
A nossa opinião:48% é o resultado de uma colaboração em camadas em tarefas específicas; a abordagem de encarnação genérica já foi refutada; na escolha da solução, é necessário analisar a taxa de sucesso, o atraso e o custo unitário numa única tabela.
Links de referência
- Baidu ERNIE: Página de lançamento do Wenxin 5.5 Flash Base
- leiphone.com: Wenxin 5.5 Flash Base de código aberto
- OpenAI: Apresentamos o GPT-6 Cyber
- The Verge: GPT-6 Cyber
- iFanr: Images 2.6
- leiphone.com: Análise do PLE
- THE DECODER: PIBx
- THE DECODER: Meta × Conductor
- Apple Newsroom: A Apple Smart está prestes a chegar à China
- leiphone.com: Cat Wu junta-se à OpenAI
- tmtpost.com: Astra e a inteligência incorporada


评论列表 (0条):
加载更多评论 Carregando...