


Lição 6: Regressão de uma Skill utilizando um conjunto de avaliação
Objetivo desta aula: irás criar um registo para o Skill que já se encontra no armazémColeção de avaliações de regressão——Tanto os acionamentos errados como os acionamentos omitidos passam a ser exemplos com ID; alterar SKILL.md Quando o CI é executado; o sinal vermelho aparece antes de «Acho que a descrição ficou mais fluida». Não se trata de escrever mais uma reflexão sobre «a importância da qualidade», mas sim de conseguir enviar o código esta noite. evals/ Com um script de saída diferente de zero. Na aula anterior, já ligaste o Skill ao diretório partilhado do CI / da equipa:https://school.myshirtai.com/?p=3948; Esta lição acrescenta o regresso do «comportamento desencadeador» àquela barreira de acesso.
Introdução
Por favor, conclua primeiro a Lição 5, «Integrar o Skill num repositório real de CI / diretório partilhado pela equipa»:https://school.myshirtai.com/?p=3948. Deve ter, pelo menos: uma Skill carregável no armazém e uma que funcione corretamente validate_skill.py(ou verificação equivalente), modelo das três perguntas do PR, resumo dos erros da Lição 4. Se ainda lhe faltar alguma base anterior, por favor, recupere-a: Lição 1 https://school.myshirtai.com/archives/3378; Lição 2 https://school.myshirtai.com/archives/3462; Lição 3 https://school.myshirtai.com/archives/3521; Lição 4 https://school.myshirtai.com/archives/3661.
Lista de materiais: permissão para escrever ou poder enviar PR; CI já a funcionar com Python; pelo menos 10 diálogos reais (incluindo acionamentos errados e omissões); consentimento da equipa quanto ao caminho do conjunto de avaliação (exemplo skills//evals/). Se não houver frases que representem verdadeiros fracassos, não invente 50 — isso é dar a si próprio um falso sinal verde.
Conceito: A revisão avalia o cumprimento do acordo, não a qualidade da escrita
Na 4.ª aula, substituir «description» por «failures»; na 5.ª aula, garantir que o formato do ficheiro está válido antes da fusão. Na 6.ª aula, corrigir o seguinte:Os documentos legais podem ainda assim ativar o erro «Skill». A série de testes responde a três perguntas: esta frase deve ou não ser acionada? Qual deve ser acionada? Quando não deve ser acionada, o sistema retira-se silenciosamente?
- Os exemplos são dados:Cada registo contém o ID, a mensagem original do utilizador, o valor booleano de ativação pretendido e o nome da skill pretendida (pode ficar em branco).
- As verificações devem ser, na medida do possível, automatizáveis:Na primeira semana, utilize registos ou ganchos de teste do tipo «carregar/não carregar» ou «selecionar/não selecionar uma determinada skill»; não se baseie apenas na impressão pessoal.
- Alterar a descrição – é obrigatório:A par do script de verificação da Lição 5, ambos são indispensáveis — mesmo que a forma seja verde e o comportamento vermelho, o acesso é igualmente bloqueado.
A documentação oficial do Agent Skills salienta que a descrição é responsável pelo acionamento; nesta lição, definimos isso como um critério de regressão: se o acionador não tiver exemplos que o abranjam, não se deve proceder à fusão com a sensação de que está tudo bem. O conceito fica por aqui; a seguir, passamos diretamente à criação da tabela.
Em comparação com «Conversar mais um pouco sobre o código manual», a diferença na coleção de avaliações reside no facto de que, em caso de falha, é possível referir-se especificamente ao ID. Durante a avaliação, a discussão sobre «se esta frase deveria ou não ser acionada» não tem fim; já a discussão sobre «E-12: esperado false, real true» tem um ponto final. A contagem de falhas da Lição 4 é a motivação para a reescrita; nesta lição, essa contagem é fixada como uma linha no repositório. Depois de fixada, por mais elegante que seja a descrição, ela tem de passar pelo mesmo comando.
Há ainda um aspeto que é preciso esclarecer: as avaliações coletivas medemAcionamento e encaminhamento, e não verificar se os conhecimentos da enciclopédia do modelo estão corretos. A verificação da exatidão dos conhecimentos deve ser deixada para as avaliações de negócio ou para o conjunto de perguntas e respostas de referência; a regressão da Skill deve limitar-se a determinar «se deve ou não ser acionada». Se forem misturados num único ficheiro, os erros tornam-se inexplicáveis — afinal, será que a descrição está errada ou é a base de conhecimentos que está errada?
O que se pode fazer esta noite:Copie da lição 4, «Falhas», 5 exemplos de ativação indevida e 5 de ativação omitida, tal como aparecem no texto original. Não se preocupe com o formato por enquanto; cole-os num ficheiro temporário e, só depois de confirmar que tem «material suficiente», avance com a criação do esquema.
Guia prático passo a passo: tabela de avaliação, exemplos de erros/omissões, regressão de CI
- Índice:Criar na pasta «Skill»
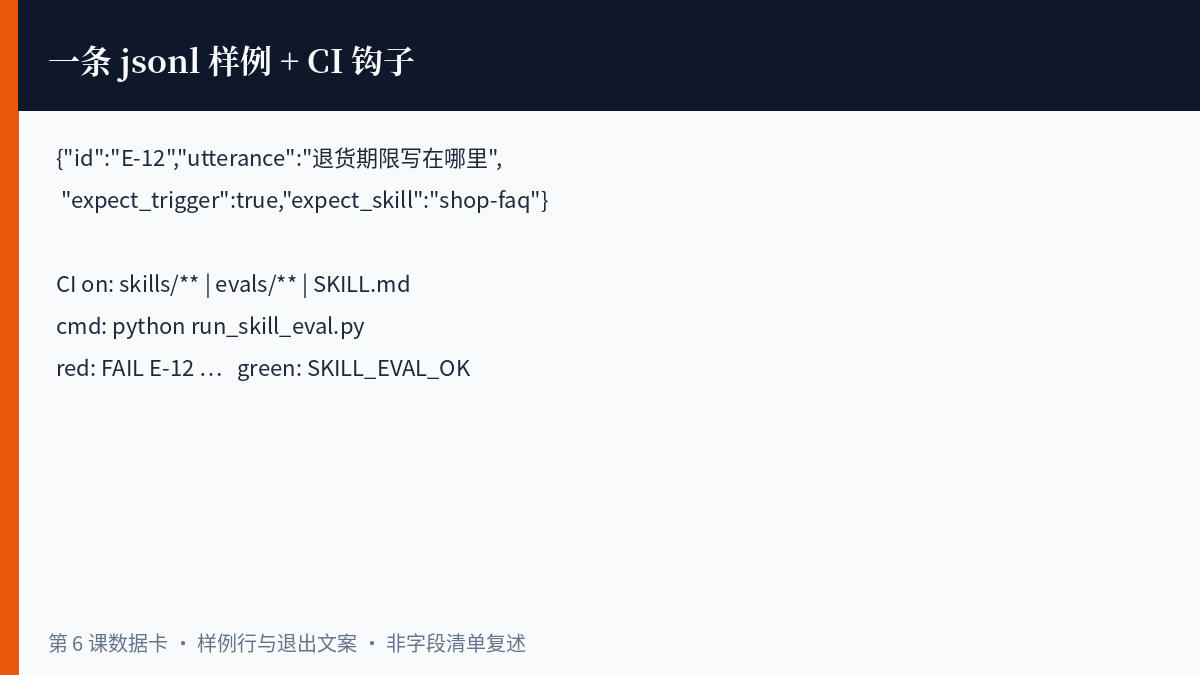
evals/cases.jsonl(ou YAML). Em comparação comSKILL.mdTal como na gestão de conjuntos de alterações, é proibido guardar a «avaliação final» apenas no armazenamento online pessoal. - Campos de preenchimento:Incluir, no mínimo,
ideenunciadoeexpect_trigger(verdadeiro/falso),expect_skill(nome da habilidade ou em branco),notas. Acionamento acidental:expect_trigger=false; falha de ativação:expect_trigger=true且expect_skillAponta para esta Skill. - Preencher os primeiros 20 itens:Dá prioridade a 10 erros + 10 omissões; os exemplos corretos podem ser acrescentados posteriormente. Indique a fonte em cada nota (número da 4.ª aula ou link da ordem de trabalho).
- 写
scripts/run_skill_eval.py::Leia os casos; utilize os vossos «execução em ambiente real/ganchos de registo/testes unitários duplos» existentes para obter os resultados reais da ativação; caso não haja correspondência, imprima o ID de falha esaída 1; impressão totalmente a verdeSKILL_EVAL_OK. - Adicionar CI:Adicionar um passo ao lado da lição 5 «job»:
competências/**或evals/**eSKILL.mdExecutar testes sempre que houver alterações. São permitidos pequenos tempos de espera; é proibido que o CI provoque efeitos secundários reais nos utilizadores em produção.
# evals/cases.jsonl 示意
{"id":"E-01","utterance":"帮我订明天去上海的机票","expect_trigger":false,"expect_skill":"","notes":"误触发:非本 FAQ skill"}
{"id":"E-12","utterance":"退货期限写在哪里","expect_trigger":true,"expect_skill":"shop-faq","notes":"漏触发修复对照"}

# run_skill_eval.py 思路示意(非完整生产代码)
import json, sys
from pathlib import Path

def actual_trigger(utterance: str) -> tuple[bool, str]:
    # 换成你们的干跑/日志解析;此处仅示意
    return False, ""

failed = []
for line in Path("evals/cases.jsonl").read_text(encoding="utf-8").splitlines():
    if not line.strip():
        continue
    c = json.loads(line)
    got_t, got_s = actual_trigger(c["utterance"])
    if got_t != c["expect_trigger"] or (c["expect_trigger"] and got_s != c["expect_skill"]):
        failed.append(f"FAIL {c['id']} expect_trigger={c['expect_trigger']} got={got_t} skill={got_s}")
if failed:
    print("\n".join(failed)); sys.exit(1)
print("SKILL_EVAL_OK")
Adicione mais uma pergunta às três perguntas do modelo de PR: está anexado o diff da avaliação (ID do caso adicionado/corrigido)? Não é permitido solicitar a fusão se este campo estiver em branco. Os comandos locais devem corresponder aos comandos de CI; indique o caminho num comentário no início do script.
Regras específicas para a redação de exemplos (a incluir em evals/README.md):
- utterance: manter as palavras exatas do utilizador, sem «retificá-las para um chinês mais padrão» — a retificação faria com que os resultados se desviassem da distribuição real;
- Cada exemplo deve testar apenas uma condição esperada, sem agrupar «a condição de que seja acionado e que a resposta sobre o prazo de devolução esteja correta»;
- Indique claramente nas notas: se se trata de um acionamento indevido ou de um acionamento em falta, a que ponto da lição 4 corresponde e se já ocorreu em produção;
- É proibido incluir chaves secretas ou números de telemóvel reais nas expressões; caso seja necessária uma estrutura, utilize placeholders
{{phone}}.
A forma de resolver o problema do «gancho» depende do vosso ambiente de execução. Existem três abordagens comuns: ① Injetar um «seletor de competências» falso nos testes unitários e verificar diretamente o nome da competência devolvida; ② Ler os registos de depuração do Claude Code / Agent e utilizar expressões regulares para identificar a skill carregada; ③ Iniciar uma configuração de avaliação só de leitura, desativar todas as ferramentas de escrita e executar o diálogo em lote. Escolha a opção que consiga reproduzir de forma estável na CI, e não aquela que «funciona no meu portátil».
# Exemplo de .github/workflows/skill-eval.yml
# on: pull_request: paths: ['**/.claude/skills/**', '**/evals/**', '**/SKILL.md']
# jobs:
#   eval:
#     runs-on: ubuntu-latest
#     steps:
# - uses: actions/checkout@v4
# - run: python3 scripts/validate_skill.py
# - run: python3 scripts/run_skill_eval.py
# Só é considerado aprovado se ambas as linhas estiverem a verde; a ordem é primeiro a forma e depois o comportamento; se a forma estiver incorreta, não é necessário desperdiçar tempo com a avaliação
O que se pode fazer esta noite:Primeiro, fazer com que o script apresente um sinal vermelho quando o «expect» estiver deliberadamente errado; depois, corrigir para o valor esperado e ver se aparece um sinal verde — para confirmar que o sistema de controlo de acessos realmente emite um sinal sonoro — e, só então, integrar na CI.
Pontos-chave da configuração: limiares, amostragem aleatória e coexistência com o sistema de controlo de acessos da Lição 5
- Definido no código:Na primeira semana, o número de falhas exigido é 0; caso seja introduzido um sistema de pontuação posteriormente, as «falhas graves» (erros que desencadeiam situações de perigo na produção) devem ser listadas separadamente e não podem ser toleradas.
- Regras de crescimento dos exemplos:Sempre que ocorrer um erro ou omissão na produção, deve ser adicionado, pelo menos, um caso e, em seguida, alterada a descrição; a ordem não pode ser invertida.
- Estabilidade na atribuição de nomes:
expect_skillTem de ser igual a frontmatternome; Alterar o nome seguindo o processo de desativação em duas etapas da lição 5 e alterar as avaliações em massa. - Ambiente de execução:Não é permitido utilizar chaves de produção nas avaliações; utilize um stub para as chamadas às ferramentas. A avaliação destina-se a testar o acionamento, não a verificar se realmente envia e-mails.
- Divisão de tarefas com o `validate_skill`:O «validate» controla o formato do ficheiro; o «eval» controla a ação de ativação. Só é permitido a execução se ambos os tarefas estiverem a verde.
- Amostragem aleatória:24 horas após a fusão, analisar manualmente três novas conversas reais; só declarar a tarefa concluída se a orientação estiver em consonância com as expectativas da avaliação.
Os nomes dos campos e a API dos hooks devem seguir a documentação do Claude Code / Agent Skills da versão que tiver instalado; o código de exemplo deve ser corrigido de acordo com a documentação. A documentação está sujeita a alterações, mas a regra «ao alterar a descrição, é obrigatório executar a avaliação» raramente muda.
Na prática, explique o conceito de «regressão» de uma forma que a equipa compreenda: dedicar mais dois minutos a executar o script antes da fusão poupa à equipa inteira duas horas a explicar por que razão houve mais um falso alarme. O conjunto de testes não é um projeto para a equipa da plataforma se exibir, mas sim o «cinto de segurança» diário do responsável pela Skill. Quem alterar a descrição tem de ser capaz de apontar para o ID da falha e explicar quais os exemplos que esta alteração afetou e por que razão continua tudo a verde.
Se gerir várias Skills, cada uma delas tem o seu próprio diretório «evals»; não partilhe um único ficheiro JSONL de grandes dimensões — a partilha de ficheiros pode tornar difusos os limites de responsabilidade entre os CODEOWNERS. Para exemplos de «exclusão mútua» entre Skills, pode criar um diretório separado. evals/shared-mutex.jsonl, executado por um job separado; isso é um tópico avançado; nesta aula, concentre-se primeiro em executar bem as suas 20 linhas.
O que se pode fazer esta noite:existir CONTRIBUTING-skills.md Adicionar três linhas: percurso de avaliação, comandos locais e acionamento acidental em produção; é necessário adicionar primeiro um «case».
Erros e falhas (pelo menos três)
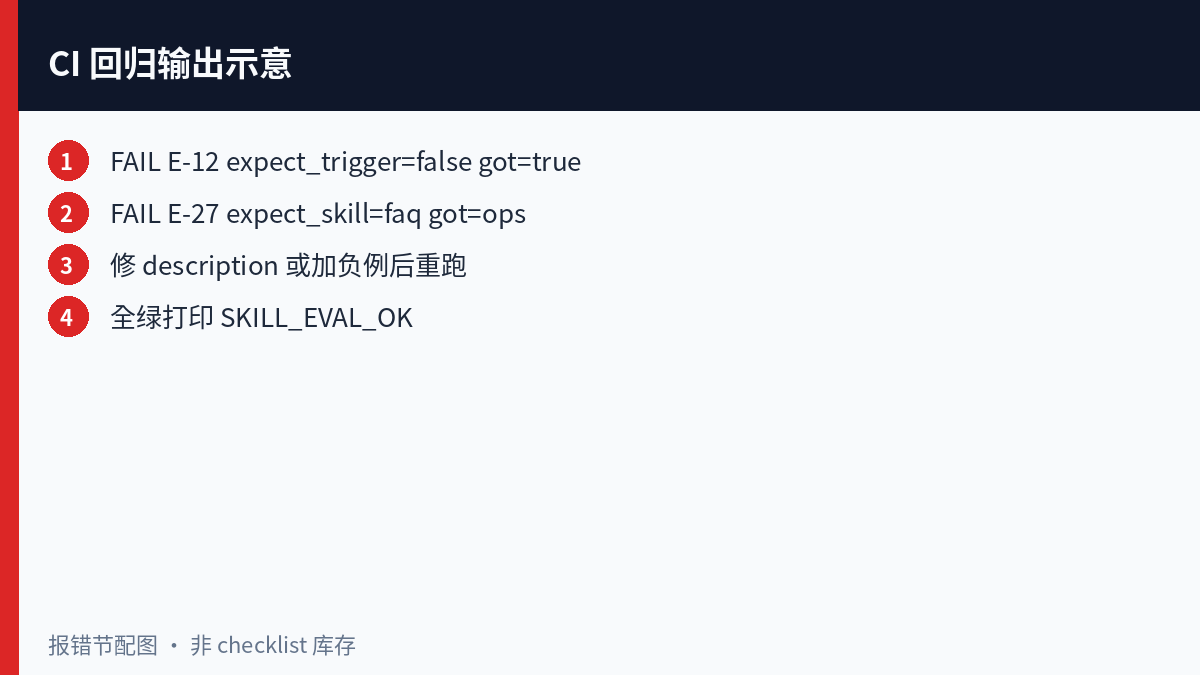
- O CI executa apenas o `validate_skill`, não o `eval`:Resultado: a descrição, mesmo que esteja incorreta, também é válida. Solução: filtragem de percursos, juntamente com
evals/**juntamente comSKILL.md, se faltar o passo «eval», a operação falha. - O `actual_trigger` devolve sempre `false`:O gancho não ficou preso e o disparamento falhou, resultando em «verde falso» generalizado. Solução: utilizar um exemplo positivo que se saiba que dispara com certeza como «fumo»; se esse exemplo falhar, todo o turno é considerado falhado.
- Os casos são todos positivos:Alarme falso com cobertura zero. Procedimento: verificar o limite mínimo de alarmes falsos no sistema de controlo de acessos (por exemplo, ≥10); se não for atingido, o indicador fica vermelho.
- A avaliação utilizou ferramentas reais para enviar e-mails e gravar dados num disco:Falha na isolação do ambiente. Medidas a tomar: forçar o uso de um stub; a CI não deve utilizar chaves de produção; caso sejam detetados efeitos secundários, suspender imediatamente a tarefa e proceder a uma análise retrospetiva.
- Conflito quando várias pessoas editam o mesmo ficheiro JSONL:Segmentar ou dividir por id
mis.jsonl/miss.jsonl; Proibir diffs sem sentido do tipo «reorganização completa do documento».
O que se pode fazer esta noite:Apagar deliberadamente o passo «eval» do CI (no ramo) e enviar um PR para ver se ainda é aprovado — se for aprovado, isso significa que a narrativa sobre o controlo de acesso é falsa; primeiro corrigir o pipeline e depois discutir a qualidade dos exemplos.
Aqui ficam mais dois exemplos de falhanços autênticos, para que possas comparar:
- Fingir que a avaliação foi acionada com a opção «Incluir palavras-chave»:Se a descrição (description) contiver as palavras «devolução», e o exemplo de utilização também incluir «devolução», o script considera que a condição foi satisfeita — mas, na realidade, a Skill nem sequer foi carregada durante a execução. Solução: a verificação deve basear-se nos valores devolvidos pelos ganchos de execução ou pelos seletores; não se deve recorrer a comparações de cadeias de caracteres na descrição (description) que apenas servem para enganar a si próprio.
- Tratar a coleção de avaliações como um brinquedo de palavras-chave:Há quem, para obter o sinal verde, altere o «expect» de forma a corresponder a um comportamento incorreto. Procedimento: qualquer alteração ao «expect» deve incluir a menção «alteração de comportamento» na descrição do PR e ser submetida à revisão de duas pessoas; por predefinição, só são permitidas alterações à descrição ou a adição de casos, não sendo permitido alterar silenciosamente o «expect».
O que dizer fora do âmbito dos exercícios: a instrução que deve dar aos recém-chegados deve ser «clone e execute estes dois comandos», e não «vem primeiro ter comigo para ligar a VPN e veres o meu histórico de conversas». Se não conseguir cumprir a primeira frase, esta aula ainda não está concluída.
Exercício
- Escolha uma Skill que já se encontre no diretório partilhado e crie
evals/cases.jsonl, com pelo menos 10 erros de escrita + 10 omissões. - Criar ou colar
run_skill_eval.py, localmente, após uma execução que falhou propositadamente e outra após a correçãoSKILL_EVAL_OK. - Alterar o modelo do PR e a identidade corporativa, de modo a
SKILL.mdAs alterações têm de ser submetidas a avaliação; coloque as capturas de ecrã ou os registos nas notas de exercícios (pode ser na rede interna). - A partir da tabela de correspondência entre «failures» da lição 4 e os «case id», indique, pelo menos, 5 linhas.
Critério de conclusão: os colegas executam apenas um comando, seguindo o teu README, e conseguem ver o ID da falha e a mensagem final «OK», sem precisarem de te perguntar «onde está o gancho».
Lista de verificação de entrega (marcar por conta própria):
- cases.jsonl contém pelo menos 20 registos e apresenta, pelo menos, 10 erros e 10 omissões;
- É possível reproduzir a falha intencional local;
- O CI deve executar o eval sempre que houver alterações no ficheiro SKILL.md;
- Já foram escritas as comandos de avaliação no ficheiro CONTRIBUTING-skills.md;
- O ficheiro school-course-series.json não foi alterado (será processado pelo fluxo de trabalho de publicação antes da publicação bem-sucedida).
Antevisão da próxima aula
Antevisão da Lição 7: Integrar o conjunto de testes com os registos de produção e o feedback — como gerar automaticamente casos candidatos a partir de um disparo acidental em produção e como definir um «período de observação» antes de os elevar ao estatuto de «padrão de excelência». Nesta lição, começaremos por estabilizar a execução dos testes de regressão offline; sem sinais de alerta offline, o ciclo fechado em produção apenas irá gerar ruído.
Enquadrando esta lição no ritmo da série: a 1.ª lição permite acionar, as lições 2 e 3 permitem referenciar e executar scripts com segurança, a 4.ª lição permite alterar a descrição com base em erros, a 5.ª lição permite fazer o commit no repositório e a 6.ª lição trata de «ousar alterar mesmo depois de ter feito o commit». Os diretórios partilhados que não se ousa alterar vão deteriorar-se gradualmente; os diretórios partilhados que se ousa alterar, mas sem testes de regressão, provocam acionamentos indevidos em toda a equipa. O conjunto de testes é o cinto de segurança que lhe permite ousar fazer alterações.
Se só houver tempo para fazer uma coisa esta noite: comece por registar os 10 falsos alarmes no jsonl e execute uma simulação de falha. Os exemplos positivos podem ser acrescentados amanhã; a CI pode ser executada depois de amanhã; mas quanto mais cedo se registarem os «disparos falsos», melhor — se todos se habituarem a discutir o assunto apenas verbalmente, será mais difícil implementar o controlo de acesso posteriormente.
Índice desta série
- Lição 1: Criar, em 30 minutos, a primeira «Claude Agent Skill» que se ativa automaticamente — https://school.myshirtai.com/archives/3378
- Lição 2: Adicionar uma referência ao Skill / O ciclo de verificação «escrever primeiro o documento de planeamento e depois executar» — https://school.myshirtai.com/archives/3462
- Lição 3: Skills com scripts e auditorias de segurança — https://school.myshirtai.com/archives/3521
- Lição 4: Descrição da iteração com casos reais de falha — https://school.myshirtai.com/archives/3661
- Lição 5: Integrar o Skill num repositório real de CI / diretório partilhado pela equipa — https://school.myshirtai.com/?p=3948
- Lição 6: Regressão de uma «Skill» utilizando um conjunto de avaliação (este artigo)


评论列表 (0条):
加载更多评论 Carregando...