


Leçon n° 6 : Réalisation d'une régression pour « Skill » à l'aide d'un ensemble d'évaluation
Objectif de cette leçon : vous saurez créer un fichier pour les compétences déjà enregistrées dans l'entrepôtRecueil d'évaluations réversibles——Les déclenchements intempestifs et les déclenchements manqués deviennent tous des exemples identifiés par un identifiant ; modification SKILL.md Le CI doit toujours s'exécuter ; le feu rouge s'allume avant que je ne me dise « Je trouve que la description est plus fluide ». Il ne s'agit pas d'écrire un énième article sur « l'importance de la qualité », mais de pouvoir valider le code ce soir. evals/ Avec un script de sortie non nul. Dans la leçon précédente, vous avez déjà connecté Skill au répertoire partagé CI / équipe :https://school.myshirtai.com/?p=3948; Dans cette leçon, on ajoute le retour du « comportement déclencheur » à ce contrôle d'accès.
Introduction
Veuillez d'abord terminer la leçon n° 5 intitulée « Intégrer Skill dans un dépôt CI réel / un répertoire partagé par l'équipe » :https://school.myshirtai.com/?p=3948. Vous devez disposer au minimum : d'une compétence chargeable depuis l'inventaire, d'un parcours praticable validate_skill.py(ou vérification équivalente), le modèle des trois questions sur le PR, le résumé des échecs de la leçon 4. Si vous n'avez pas encore acquis les bases précédentes, veuillez revenir sur : la leçon 1 https://school.myshirtai.com/archives/3378; Leçon n° 2 https://school.myshirtai.com/archives/3462; Leçon n° 3 https://school.myshirtai.com/archives/3521; Leçon n° 4 https://school.myshirtai.com/archives/3661.
Liste des éléments requis : droits d'écriture ou possibilité de soumettre une PR ; CI capable d'exécuter du Python ; au moins 10 exemples de dialogues réels (y compris les déclenchements erronés et les omissions) ; accord de l'équipe concernant le chemin d'accès au jeu de données d'évaluation (exemple skills//evals/). S'il n'y a pas de véritables phrases erronées, ne vous inventez pas 50 exemples : ce serait vous donner un faux feu vert.
Concept : le test de retour porte sur le déclenchement du contrat, et non sur le style d'écriture.
Leçon n° 4 : remplacer « description » par « failures » ; leçon n° 5 : s'assurer que le format du fichier est valide avant la fusion. La leçon n° 6 apporte la correction suivante :Un document valide peut tout de même déclencher une erreur « Skill ».. La série de tests répond à trois questions : cette phrase doit-elle déclencher une réaction ? Laquelle doit-elle déclencher ? Et lorsqu'elle ne doit pas déclencher de réaction, le système s'efface-t-il discrètement ?
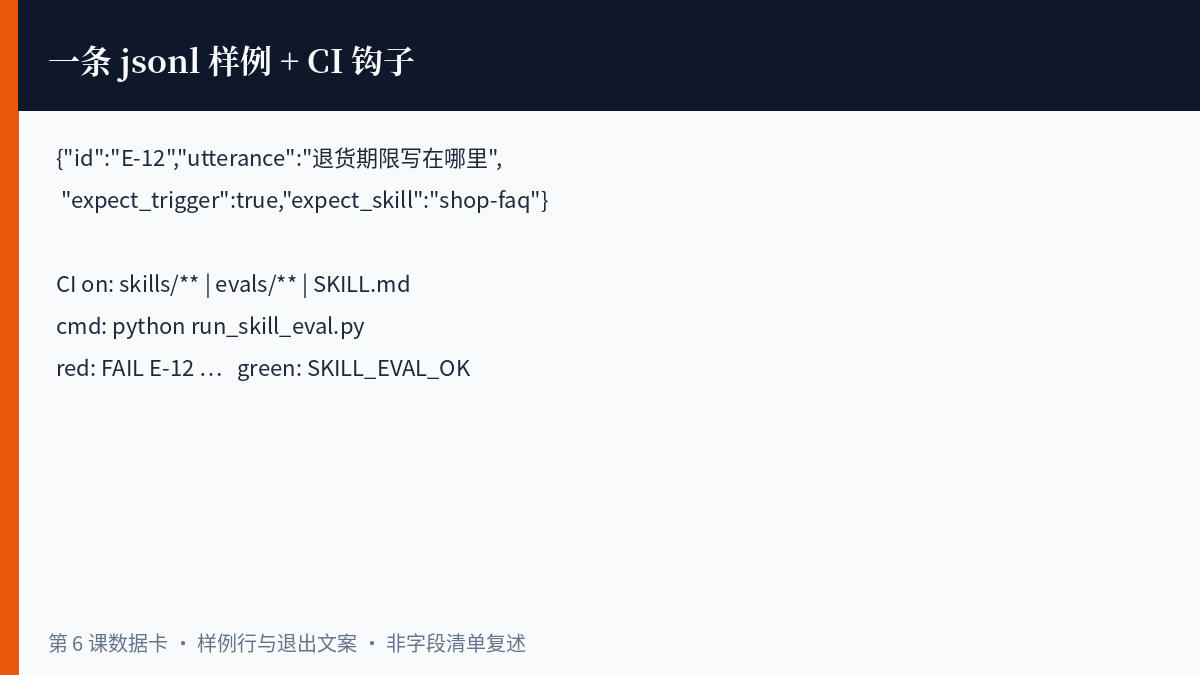
- Voici un exemple de données :Chaque ligne contient un identifiant, la citation originale de l'utilisateur, la valeur booléenne de déclenchement souhaitée et le nom de la compétence souhaitée (facultatif).
- Les décisions doivent être automatisables autant que possible :La première semaine, utilisez des journaux ou des hooks de test pour vérifier « si une compétence est chargée / si elle est sélectionnée » ; ne vous fiez pas uniquement à votre intuition.
- Modification de la description : à faire absolument :En parallèle du script de vérification de la leçon 5, les deux sont indispensables : même si la forme est « verte » et le comportement « rouge », le blocage s'effectue quand même.
La documentation officielle sur les compétences des agents souligne que c'est la description qui est chargée de déclencher l'action ; dans ce cours, nous considérons cela comme un cas de régression : si le déclencheur n'est pas couvert par un exemple, il ne faut pas se contenter de le fusionner sans autre forme de procès. Le concept s'arrête là ; passons maintenant directement à la création de la table.
Par rapport à « Discuter encore trois phrases à la main », la différence avec le recueil de tests réside dans le fait que les échecs peuvent être identifiés par leur ID. Lors de la révision, la discussion sur la question de savoir si « cette phrase devrait ou non déclencher le test » n’a pas de fin ; en revanche, celle portant sur le fait que « E-12 s’attend à false mais donne en réalité true » a une fin. Le comptage des « failures » de la leçon 4 est une source de motivation pour la réécriture ; dans cette leçon, ce comptage est figé sous forme de lignes dans le dépôt. Une fois figé, quelle que soit la qualité rédactionnelle de la description, elle doit passer par la même commande.
Il convient également de préciser un autre point : les tests comparatifs portent surDéclenchement et routage, et non pas de vérifier l'exactitude des connaissances encyclopédiques du modèle. La vérification de l'exactitude des connaissances relève des évaluations métier ou des ensembles de questions-réponses de référence ; le rétest des compétences se limite à déterminer « s'il faut ou non l'activer ». Si ces éléments sont mélangés dans un même fichier, les signaux d'alerte deviennent inexplicables : est-ce la description qui est erronée, ou la base de connaissances ?
Activités possibles ce soir :Copiez les 5 exemples de déclenchements intempestifs et les 5 exemples de déclenchements manqués figurant dans la leçon 4 « failures ». Ne vous souciez pas pour l'instant de la mise en forme ; collez-les dans un fichier temporaire et assurez-vous que vous disposez bien de suffisamment d'informations avant de poursuivre la création du schéma.
Guide pratique étape par étape : grille d'évaluation, exemples d'erreurs et d'omissions, régression CI
- Table des matières :Créer dans le répertoire « Skill »
evals/cases.jsonl(ou YAML). AvecSKILL.mdTout comme pour la gestion des ensembles de modifications, il est interdit de conserver les « évaluations finales » uniquement sur un espace de stockage personnel en ligne. - Champs à remplir :Comprend au moins
ideténoncéetexpect_trigger(vrai/faux),compétence attendue(nom de la compétence ou vide),notes. Déclenchement intempestif :expect_trigger=false;漏触发:expect_trigger=true且compétence attendue指向本 Skill。 - 填第一批 20 条:10 误 + 10 漏优先,正例可后补。每条 notes 写来源(第 4 课编号或工单链接)。
- 写
scripts/run_skill_eval.py: :读入 cases;用你们现有的「干跑/日志钩子/单元测试双倍」拿到实际触发结果;不匹配则打印失败 id 并exit 1;全绿打印SKILL_EVAL_OK. - 挂 CI:在第 5 课 job 旁加一步:
skills/**或evals/**etSKILL.md变更时跑评测。允许短超时;禁止 CI 里对线上用户发真实副作用。
# evals/cases.jsonl 示意
{"id":"E-01","utterance":"帮我订明天去上海的机票","expect_trigger":false,"expect_skill":"","notes":"误触发:非本 FAQ skill"}
{"id":"E-12","utterance":"退货期限写在哪里","expect_trigger":true,"expect_skill":"shop-faq","notes":"漏触发修复对照"}

# run_skill_eval.py 思路示意(非完整生产代码)
import json, sys
from pathlib import Path

def actual_trigger(utterance: str) -> tuple[bool, str]:
    # 换成你们的干跑/日志解析;此处仅示意
    return False, ""

failed = []
for line in Path("evals/cases.jsonl").read_text(encoding="utf-8").splitlines():
    if not line.strip():
        continue
    c = json.loads(line)
    got_t, got_s = actual_trigger(c["utterance"])
    if got_t != c["expect_trigger"] or (c["expect_trigger"] and got_s != c["expect_skill"]):
        failed.append(f"FAIL {c['id']} expect_trigger={c['expect_trigger']} got={got_t} skill={got_s}")
if failed:
    print("\n".join(failed)); sys.exit(1)
print("SKILL_EVAL_OK")
把 PR 模板三问再加一问:是否附评测 diff(新增/修复的 case id)?空着不允许求合并。本地命令与 CI 命令保持一致,路径写进脚本顶部注释。
样例书写的具体规矩(写进 evals/README.md):
- utterance 保持用户原话,不「润色成更标准的中文」——润色会让回归脱离真实分布;
- 一条样例只测一个期望,不把「既要触发又要答对退货天数」捆在一起;
- notes 里写清楚:这是误触发还是漏触发、对应第 4 课哪条、是否已在生产出现;
- 禁止把密钥、真实手机号写进 utterance;需要结构时用占位符
{{phone}}.
干跑钩子怎么接,取决于你们的运行时。常见三条路:① 单元测试里注入假的「技能选择器」,直接断言返回的 skill 名;② 读 Claude Code / Agent 的调试日志,用正则抓加载的 skill;③ 起一个只读的评估配置,关掉所有写工具,跑批处理对话。选你能在 CI 里稳定复现的那条,不选「我笔记本上能看」的那条。
# .github/workflows/skill-eval.yml 示意
# on: pull_request: paths: ['**/.claude/skills/**', '**/evals/**', '**/SKILL.md']
# jobs:
#   eval:
#     runs-on: ubuntu-latest
#     steps:
#       - uses: actions/checkout@v4
#       - run: python3 scripts/validate_skill.py
#       - run: python3 scripts/run_skill_eval.py
# 两条都绿才算过;顺序先形态后行为,形态都坏了不必浪费评测时间
Activités possibles ce soir :先让脚本在「故意写错 expect」时红灯,再改回正确期望看绿灯——确认门禁真的会响,再挂 CI。
Points clés de la configuration : seuil, échantillonnage, coexistence avec le système de contrôle d'accès de la leçon 5
- 通过线写死:第一周要求失败条数为 0;以后若引入打分制,也要单列「硬失败」(错误触发生产危险 skill)不可妥协。
- 样例增长规则:每出现一次生产误/漏触发,至少加 1 条 case 再改 description,顺序不许颠倒。
- 命名稳定:
compétence attendue必须等于 frontmatternom;改名走第 5 课的两步禁用流程,并批量改评测。 - 干跑环境:评测禁止带生产密钥;工具调用用 stub。评测是测触发,不是测你真的发邮件。
- 与 validate_skill 分工:validate 管文件形态;eval 管触发行为。两个 job 都绿才许合。
- 抽检:合并后 24 小时用 3 条真实新对话人工看一眼,方向与评测预期一致再宣布完成。
字段名、钩子 API 以你安装版本的 Claude Code / Agent Skills 文档为准;示意代码按文档校正。文档会变,「改 description 必跑评测」这条不怎么变。
实操时把「回归」说成团队能听懂的话:合并前多花两分钟跑脚本,换的是全组少花两小时解释为什么又误触发。评测集不是平台组的炫技项目,是 Skill 负责人的日常安全带。谁改 description,谁就要能指着失败 id 说明这次改动碰了哪些样例、为什么仍然全绿。
若你维护多个 Skill,每个 Skill 自带 evals 目录,不要共用一个巨型 jsonl——共用文件会让 CODEOWNERS 与责任边界糊掉。跨 Skill 的「互斥」样例可以另建 evals/shared-mutex.jsonl,由单独 job 跑;那是进阶项,本课先把自己的 20 条跑稳。
Activités possibles ce soir :existent CONTRIBUTING-skills.md 加三行:评测路径、本地命令、生产误触发必须先加 case。
Erreurs et ratés (au moins trois)
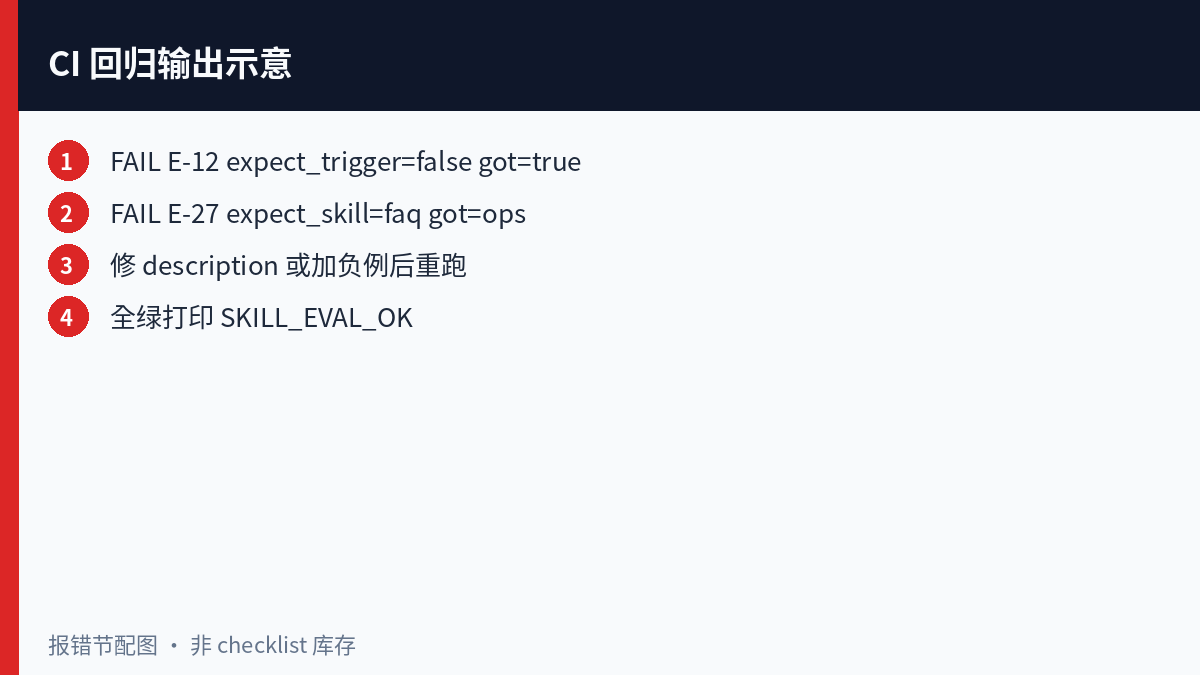
- CI 只跑 validate_skill,不跑 eval:结果 description 改坏也能合。处理:路径过滤加上
evals/**avecSKILL.md,缺 eval 步骤即失败。 - actual_trigger 永远返回 false:干跑钩子没接上,漏触发全假绿。处理:用一条已知必触发的正例做烟雾;该正例失败则整岗失败。
- cases 全是正例:误触发零覆盖。处理:门禁检查误触发条数下限(例如 ≥10),不足则红。
- 评测调用真实工具发了邮件/写了盘:环境隔离失败。处理:强制 stub;CI 无生产密钥;发现副作用即停用 job 并复盘。
- 多人改同一 jsonl 冲突:按 id 分段或拆
mis.jsonl/miss.jsonl;禁止「整文件重排」无意义 diff。
Activités possibles ce soir :故意删掉 CI 里的 eval 一步(在分支上),提 PR 看是否还能绿——若还能绿,说明门禁叙事是假的,先修流水线再谈样例质量。
补充两条真实味道的翻车,方便你对照:
- 用「包含关键词」假装触发判定:description 里有「退货」两字,用例也有「退货」,脚本就判触发成功——但运行时根本没加载该 Skill。处理:判定必须来自运行时钩子或选择器返回值,不要对 description 文本做自欺欺人的字符串匹配。
- 把评测集当成提示词玩具:有人为了绿灯,把 expect 改成和坏掉的行为一致。处理:改 expect 必须在 PR 说明里写「行为变更」并两人评审;默认只允许改 description / 加 case,不允许默默改期望。
练习之外的验收话术:你给新人的指令应是「clone 后跑这两条命令」,而不是「先来找我开 VPN 看我的聊天记录」。做不到前一句,本课就还没交付完。
Exercices
- 选一个已进共享目录的 Skill,建
evals/cases.jsonl,写入至少 10 误 + 10 漏。 - 实现或粘贴
run_skill_eval.py,本地跑到一次故意失败、一次修复后SKILL_EVAL_OK. - 改 PR 模板与 CI,使
SKILL.md变更必跑评测;截图或日志贴到练习笔记(可内网)。 - 从第 4 课 failures 映射到 case id 对照表,至少 5 行。
完成标准:同事按你的 README 只跑一条命令,能看到失败 id 与最终 OK,无需问你「钩子在哪」。
交付检查清单(自己打勾):
- cases.jsonl ≥20 条且误/漏各≥10;
- 本地故意失败可复现;
- CI 在 SKILL.md 变更时必跑 eval;
- CONTRIBUTING-skills.md 已写评测命令;
- 未改 school-course-series.json(发布成功前由发布流程推进)。
Aperçu de la prochaine leçon
第 7 课预告:把评测集与生产 trace/反馈打通——如何从线上误触发一键生成候选 case、如何设「观察期」再升格为金标。本课先把离线回归跑稳;没有离线红灯,线上闭环只会制造噪声。
把本课放回系列节奏里看:第 1 课能触发,第 2–3 课能引用与安全地跑脚本,第 4 课能用失败改 description,第 5 课能进仓库,第 6 课则是「进仓库之后仍敢改」。不敢改的共享目录会慢慢腐烂;敢改但没回归的共享目录会制造全组误触发。评测集是让你敢改的安全带。
若时间只够今晚做一件事:先把 10 条误触发写进 jsonl 并跑红一次。正例可以明天补;CI 可以后天挂;但「误触发被写成数据」这件事,越早越好——等大家习惯了口头争论,再推门禁会更难。
Sommaire de cette série
- Leçon n° 1 : Créer en 30 minutes votre première compétence Claude Agent à déclenchement automatique — https://school.myshirtai.com/archives/3378
- Leçon n° 2 : Ajouter une référence à Skill / Boucle de vérification « rédiger le document de planification avant l'exécution » — https://school.myshirtai.com/archives/3462
- Leçon n° 3 : Skills avec script et audit de sécurité — https://school.myshirtai.com/archives/3521
- Leçon n° 4 : itération à partir de cas réels d'échec description — https://school.myshirtai.com/archives/3661
- Leçon n° 5 : Intégrer Skill au dépôt CI réel / au répertoire partagé de l'équipe — https://school.myshirtai.com/?p=3948
- 第 6 课:用评测集给 Skill 做回归(本文)


评论列表 (0条):
加载更多评论 Chargement...