


本文是对比:同一批问答任务下,「塞满窗口」与「精筛片段」两条路怎么打。不是模型参数百科。读完应能今晚砍一版检索片段,并留下可复测的门槛。
核心判断:窗口变大不等于该塞更多
上下文窗口从 8k 涨到 128k、再到百万级,团队第一反应常是「终于能全塞了」。我测下来相反:塞满往往把答案拖进噪声泥潭。模型会「看见」更多无关句,却更难把关键句排到决策位。精筛不是省 token 的小气,是提高命中的纪律。
为什么塞多了反而更差?两个机制叠在一起。一是长上下文里中段信息容易被忽视,关键句被 20 段邻居挤到中间,模型对它的注意力就被摊薄了。二是最伤人的噪声不是完全无关的段落,而是「长得很像」的邻近条款:同一份制度里的总则、例外和附则,用词高度重合,结论却相反。窗口越大,这类近似干扰装进去的越多,模型越容易把它们缝成一个看似完整的答案。
可观察信号:同一问题,塞满版回答更长、引用更多、正确率不升反降;精筛版更短、引用更少、关键句命中更高。你要用命中与可复核引用说话,不要用「感觉更全面」。
我用过的可观察门槛(写进配置,不要只写在聊天里):
max_ctx_chunks:进模型片段上限,默认从 6 起测,不要从 30 往下砍才「觉得科学」。min_rerank_score:重排分低于阈值的片段直接丢,不许用「说不定有用」留下。must_contain_entities:问句里的关键实体(合同编号、制度名)至少命中一个,否则该片段不出列。
对照实验最小集:同一检索器、同一模型、同一 10 条问句;只改进模策略。记录四列——问句、A 答案要点、B 答案要点、带偏标记。没有这张表,开会时谁嗓门大谁说了算,窗口越大越难拉回来。
纵向:我们怎么走到「猛塞」的
早期 RAG 怕漏,召回 top-k 一路加。评测只看「有没有答到」,不问「是不是被噪声带偏」。业务方说「再多塞点稳一点」,工程就加 chunk。窗口升级后,这个惯性被放大:能塞就塞,像把仓库货架全推进收银台。
三处拐点:① 评测只奖召回不罚噪声;② 产品把「引用条数」当可信度;③ 没有「砍片段」的周节奏。结果是索引越大,答案越像拼贴。
猛塞惯性还有两个常被忽略的推手。一是「引用条数」被产品做成信任徽章:引用越多越像权威,于是工程被迫多塞。二是日志里只存最终答案,不存进模片段列表——出了错无法复盘是噪声还是模型胡写。补丁很土:每次回答落盘 ctx_chunk_ids;评审看带偏案例时必须打开片段列表,而不是只看答案文案。
如果你正在从「怕漏」迁到「精筛」,第一周不要同时改分块大小、嵌入模型和进模上限。一次只动进模上限,复测过了再动别的。否则你分不清是哪一刀起了作用。
横向对比:塞满 vs 精筛
同一批 20 条内部问答(制度/合同/工单),同一检索器,只改「进模型的片段策略」。
| dimensão (matemática) | 塞满 | 精筛 |
|---|---|---|
| 进模片段数 | top-20~30 全进 | 先召回 20,再压到 5~8 |
| 正确率(人工) | 常被邻近条款带偏 | 相关句更稳 |
| 幻觉形态 | 「缝合」多段无关 | 拒答或少引用更常见 |
| 可复核 | 引用长、难核 | 引用短、好核 |
| 何时用 | 探索性调研、不怕冗长 | 客服/合规/合同问答默认 |
精筛不是玄学:用重排、规则门(标题/章节匹配)、或「必须含实体」过滤器。先让噪声出列,再让模型写答案。
精筛三条可执行路径(按团队能力选一条做默认):
- 重排刀:召回 20 → cross-encoder / 轻量重排 → 取 top 6。适合已有向量检索、愿意加一跳延迟。
- 规则门:标题/章节路径包含问句关键词才进模;制度问答特别有效。适合语料有清晰目录的 PDF/Markdown 树。
- 实体门:问句抽实体,片段必须命中;命中数为 0 则该条出列。适合合同编号、工单号、人名工号密集的场景。
三条可以叠,但上线前用同一张 10 问表分别打分。我见过「三重门全开」把召回杀到正确率暴跌——那时应放松规则门,而不是重新把 top-30 全塞回去。
成本账也站在精筛这边。按每段五百个词元算,20 段进模单问就是一万词元上下,6 段只有三千左右;首字延迟和账单大致跟着降到三分之一。重排多出的那一跳,通常比少读七千词元省下的时间更短。换句话说,精筛不是用质量换成本,两头都赚,前提是你有那张十问表证明质量没掉。
何时允许临时塞满:探索性调研、一次性分析、用户明确说「把相关材料都摊开」。生产客服/合规默认精筛。把「探索模式」做成显式开关,禁止静默提高上限。
今晚怎么砍一版检索片段
目标只有一个:用同一批问句证明「进模 6 条」不比「进模 20 条」差,然后把这个上限写进配置。召回、嵌入、分块今晚一概不动。
安装:只补一个重排器
已有向量检索的话,唯一要装的是重排模型。用 sentence-transformers 的 CrossEncoder 最省事,中文语料选 bge 系列重排器;没有 GPU 也能跑 20 条候选,单问多出几百毫秒,今晚做实验足够。
pip install -U sentence-transformers
python - <<'PY'
from sentence_transformers import CrossEncoder
ce = CrossEncoder("BAAI/bge-reranker-base")
print(ce.predict([("试用期解除要提前几天通知", "第十二条 试用期内解除劳动合同应提前三日通知")]))
PY
能打出一个分数就算装好。不想引入模型,也可以先只上规则门和实体门,但今晚的 A/B 要写清 B 用的是哪一刀。
跑通:A/B 两轮同题对照
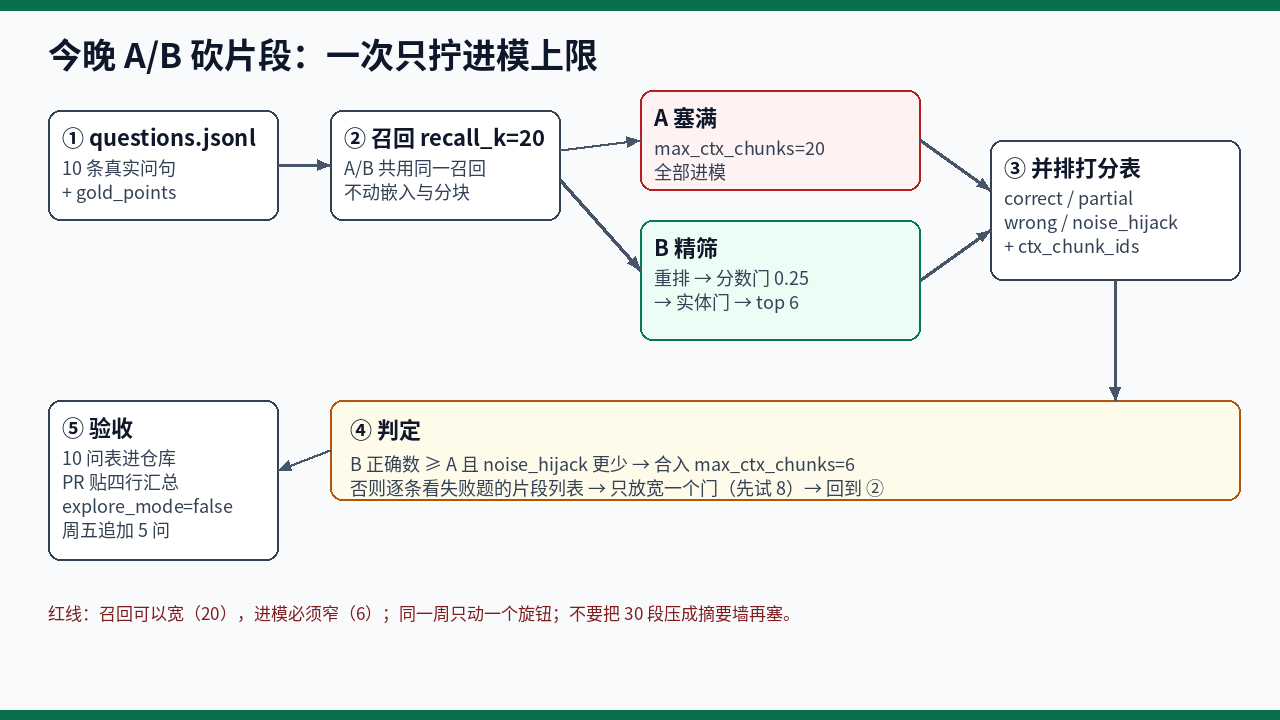
- 先把现有配置备份成
configs/rag.yaml.bak。准备questions.jsonl,每行写{id, question, gold_points[]},放 10 条线上真问句,不要用自己编的。 - 跑 A:召回 20 条,全部进模。每题都落盘答案和
ctx_chunk_ids. - 跑 B:同一召回,经过重排、分数门、实体门,取 top 6 进模,同样落盘。
- 人工并排打分,每题标 correct / partial / wrong,另标是否 noise_hijack(被无关片段带偏)。
- 判定:B 正确数不少于 A,且带偏更少,就合入;否则看失败题的片段列表,只放宽一个门,例如上限试 8,再回第 2 步。
四行汇总不必手算。打分结果存成 scores.csv(列:id, arm, verdict, noise_hijack),一段脚本出数:
python - <<'PY'
import csv, collections
c = collections.Counter()
for r in csv.DictReader(open("scores.csv")):
    c[(r["arm"], "correct")] += r["verdict"] == "correct"
    c[(r["arm"], "hijack")] += r["noise_hijack"] == "1"
for arm in "AB":
    print(arm, "正确", c[(arm, "correct")], "带偏", c[(arm, "hijack")])
PY
如果 A、B 两轮十题全对,不是精筛赢了,是题出得太软。把问句换成线上真正答错过的那几类:带编号的合同条款、有例外条件的制度、同名不同版本的工单。好的十问表里,A 至少要错两三题,对照才有意义。挑题时也别全挑难题,留两三道常规题,用来确认精筛没把简单问题砍坏。
打分时必须打开片段列表看。光看答案文案,你分不清错误来自噪声还是模型自己编的。
配置:上限写进仓库,不留在聊天里
# configs/rag.yaml
retrieval:
  recall_k: 20
generation:
  max_ctx_chunks: 6          # 进模上限:默认精筛
  min_rerank_score: 0.25     # 低于此分直接丢
  must_contain_entities: true
  explore_mode: false        # 探索模式显式开关,禁止静默抬上限
阈值 0.25 只是起点,不同重排器的分数分布差很多。先看 A 轮 20 条候选的分数直方图,把阈值放在「明显相关」和「沾边」两堆之间。同一周只拧一个旋钮:要么动上限,要么动阈值,要么动实体门。多跳智能体每一跳各自精筛,分别落盘 ctx_chunk_ids_hopN,不许把上一跳的 20 条残留拼进下一跳。
翻车:四个最常见的坑
- 把精筛当成少召回:召回仍是 20,砍的是进模。召回一砍,漏答会立刻反弹,团队就又回去猛塞。
- 摘要墙:用摘要模型把 30 段压成一大段再塞。片段数看着少了,噪声还在,可复核的引用却没了。宁可保留 6 段短原文。
- 三重门全开:重排、规则、实体同时收紧,召回被杀到正确率暴跌。这时应该放松规则门,不是把 top-30 塞回去。
- 条款缝合看不出来:问试用期解除要提前几天通知,塞满版把解除总则、竞业限制、培训服务期拼成一套听上去完整、其实张冠李戴的流程;精筛版只剩试用期专章,答案短,但能对着原文核。评审要学会认出这种缝合,这比盯正确率百分比管用。
还有一个慢性坑:嵌入模型升级后正确率涨了,带偏也涨了,说明新召回更「热闹」,更该精筛,而不是趁机把上限调回 30。
验收:合入前四条硬门槛
- 10 问表和 A/B 打分结果进仓库。
- 配置项有默认值和注释,
explore_mode默认关闭。 - PR 描述贴四行汇总:A 正确数、B 正确数、A 带偏数、B 带偏数,缺一行打回。
- 业务方要「再多塞点」,必须附复测表,否则评审拒收。标准回复钉在评审频道置顶:「可以开 explore_mode,但生产默认 max_ctx_chunks=6,要改上限请附 10 问复测表。」
之后每周五追加 5 条新问复测,防止语料漂移后又退回猛塞。窗口还会继续涨,到时候你多半又想把上限调回 30。把复测表钉在评审会上,比任何口号管用。


评论列表 (0条):
加载更多评论 Carregando...