


本稿は比較:同一のQ&Aタスクにおいて、「ウィンドウを埋め尽くす」と「断片を厳選する」という2つのアプローチをどのように進めるか。モデルパラメータの百科事典ではない。読み終えた後、今夜中に検索断片のバージョンを1つ絞り込み、再検証可能な基準を残せるようにすべきである。
重要な判断:窓が大きくなったからといって、もっと詰め込めばいいというわけではない
コンテキストウィンドウが8kから128k、さらには100万レベルへと拡大すると、チームの最初の反応は往々にして「やっと全部詰め込める」というものです。しかし、私のテスト結果では逆でした。詰め込みすぎると、答えがノイズの泥沼に引きずり込まれてしまうことがよくあります。モデルはより多くの無関係な文を「認識」するようになる一方で、重要な文を意思決定の要所に配置することがより難しくなります。厳密な選別は、トークンを節約するためのケチさではなく、的中率を高めるための規律なのです。
なぜ情報を詰め込みすぎるとかえって精度が低下するのでしょうか?これには2つのメカニズムが重なっています。1つ目は、長い文脈の中では中盤の情報が見過ごされやすく、重要な文が周囲の20段落に挟まれて真ん中に位置してしまうため、モデルがその文に注ぐ注意力が分散されてしまうことです。第二に、最も有害なノイズは、全く無関係な段落ではなく、「非常によく似ている」近隣の条項です。同じ制度における総則、例外、附則などは、用語が高度に重複しているにもかかわらず、結論が正反対であることがあります。ウィンドウが大きければ大きいほど、この種の類似した干渉要素が多く取り込まれることになり、モデルはそれらを縫い合わせて、一見完全な答えのように見せてしまう可能性が高くなります。
確認できる傾向:同じ問題について、「詰め込み版」の回答はより長く、引用も多く、正答率は上がるどころか低下する。一方、「厳選版」はより短く、引用も少なく、重要な文の的中率が高い。「より網羅的だ」という感覚ではなく、的中率と検証可能な引用に基づいて論じるべきだ。
私がこれまで使用してきた監視のしきい値(設定ファイルに記述してください。チャットにだけ書くのは避けてください):
max_ctx_chunks:モデルに読み込むスニペットの上限について、デフォルトでは6から測定を開始します。30から下げていくことが「科学的だ」と感じる必要はありません。min_rerank_score:再配置スコアが閾値を下回るセグメントは即座に破棄し、「もしかしたら役に立つかもしれない」という理由で残してはならない。must_contain_entities:質問文に含まれる重要なエンティティ(契約番号、制度名)のうち、少なくとも1つが一致する場合に限り、その断片が表示される。一致しない場合は表示されない。
対照実験の最小セット:同一の検索エンジン、同一のモデル、同一の10件の質問。モデル戦略のみを改善する。4つの列を記録する――質問、Aの回答要点、Bの回答要点、バイアスフラグ。この表がなければ、会議では声が大きい人の意見が通ってしまい、一度広がってしまった認識のギャップを修正するのが難しくなる。
縦軸:「メンセ」に至るまでの道のり
初期のRAGは情報漏れを恐れて、トップkの再現率をひたすら増やしていった。評価では「答えが出ているか」のみが重視され、「ノイズに流されていないか」は問われなかった。業務部門から「もっと詰め込めば安定する」と言われると、エンジニアはチャンク数を増やした。ウィンドウがアップグレードされた後、この慣性がさらに増幅された。詰め込めるだけ詰め込む、まるで倉庫の棚をすべてレジに押し込むかのようだった。
3つの転換点:① 評価ではリコールのみを評価対象とし、ノイズには罰則を課さない;② 製品が「引用数」を信頼性の指標としている;③ 「断片の削除」を行う週次サイクルがない。その結果、インデックスが大きくなるほど、回答はコラージュのようになっていく。
Menseの慣性には、見過ごされがちな2つの要因がある。1つ目は、「引用数」が製品側によって信頼の証として扱われていることだ。引用が多ければ多いほど権威的に見えるため、エンジニアは無理やり引用を詰め込まざるを得なくなる。2つ目は、ログに最終的な答えのみが保存され、モデルの一連の処理ステップが記録されないことだ。これにより、エラーが発生した際に、それがノイズによるものか、それともモデルが誤った出力を生成したのかを追跡することができなくなる。パッチの方法はかなり原始的だ:回答がディスクに書き込まれるたびに ctx_chunk_ids;審査員は偏った事例を審査する際、解答文だけを見るのではなく、必ず動画のクリップ一覧を開かなければならない。
もし「漏れを恐れる」段階から「精選」段階へと移行している最中なら、最初の1週間は、バッチサイズ、モデルの組み込み、および投入上限を同時に変更しないでください。一度に投入上限のみを変更し、再テストを経てから他の項目を変更してください。そうしないと、どの変更が効果をもたらしたのか判別できなくなります。
横並び比較:詰め込み型 vs 厳選型
同じバッチの20件の内部Q&A(制度/契約/作業指示書)について、同じ検索エンジンを使用し、「モデルへの入力スニペット戦略」のみを変更した。
| 次元 | 詰め込む | 精密ふるい分け |
|---|---|---|
| 金型への挿入回数 | トップ20~30位は全員合格 | まず20まで呼び戻し、その後5~8まで押し下げる |
| 正答率(手動) | 近隣の条項に惑わされがちである | 関連する文の方がより安定している |
| 幻覚形態 | 「縫合」は複数の無関係なセグメント | 回答を拒否したり、引用を控えたりするケースの方がより一般的である |
| 確認可能 | 引用が長く、確認が困難 | 引用が短く、要点が明確 |
| いつ使うか | 探索的な調査、長くなっても構わない | カスタマーサービス/コンプライアンス/契約に関するQ&A(デフォルト) |
精選は神秘的なものではない:再並べ替え、ルールゲート(タイトル/章の照合)、あるいは「エンティティを含むこと」というフィルターを活用する。まずノイズを除去し、それからモデルに答えを書かせる。
3つの実行可能な経路を精査し(チームの能力に応じて1つを選択し、デフォルトとする):
- 再配置ナイフ:20件を検索 → クロスエンコーダー / 軽量な再並べ替え → 上位6件を選択。既存のベクトル検索が利用可能で、1ステップの遅延を許容できる場合に適している。
- ルールゲート:タイトルやセクションのパスに質問のキーワードが含まれている場合のみモデルに入力される。制度に関するQ&Aが特に効果的である。明確な目次を持つPDFやMarkdownツリー形式のデータに適している。
- 実体ドア:質問文からエンティティを抽出する際、該当する断片が必ずヒットしなければならない。ヒット数が0の場合、その項目は除外される。契約番号、作業指示書番号、氏名や社員番号が密集している場面に適している。
3つのフィルターを重ねて適用することは可能ですが、リリース前には同じ10項目の評価シートを用いてそれぞれ採点してください。「三重のフィルターをすべて開放」した結果、リコール率が低下し、正答率が急落した事例を目にしたことがあります。その際は、ルールのフィルターを緩和すべきであり、トップ30をすべて再び詰め込むべきではありませんでした。
コスト面でも「精篩」の方が有利です。1セグメントあたり500語素と仮定すると、20セグメントをモデルに投入した場合、1クエリあたり約1万語素になりますが、6セグメントでは約3,000語素にとどまります。これにより、先頭文字の遅延やコストも概ね3分の1に減少します。再配列によって生じる余分な処理時間は、通常、7,000語素を読み飛ばすことで節約できる時間よりも短い。言い換えれば、精選は品質とコストをトレードオフするものではなく、両方のメリットを享受できる。ただし、品質が低下していないことを証明する10問のチェックリストがあることが前提となる。
一時的なデータ詰め込みを許可するタイミング:探索的な調査、単発の分析、ユーザーが「関連資料をすべて並べてほしい」と明確に指示した場合。カスタマーサポート/コンプライアンス部門では、デフォルトで厳格なフィルタリングを行う。「探索モード」を明示的なオン/オフスイッチとし、上限の黙認的な引き上げを禁止する。
今夜はどうやって検索スニペットを1ページ分切り出すか
目標はただ一つ。「6件のモデルへの投入」が「20件のモデルへの投入」に劣らないことを、同じ一連の質問を用いて証明し、その上限値を構成に明記することだ。リコール、埋め込み、ブロック分けについては、今夜は一切手を加えない。
取り付け:リセッターを1つ取り付けるだけ
ベクトル検索の環境が整っているなら、インストールする必要があるのは再配置モデルだけです。sentence-transformersのCrossEncoderを使うのが最も手間がかかりません。中国語のコーパスにはbgeシリーズの再配置モデルを選択してください。GPUがなくても20件の候補を処理でき、1クエリあたり数百ミリ秒ほど時間がかかりますが、今夜の実験には十分です。
pip install -U sentence-transformers
python - <<'PY'
from sentence_transformers import CrossEncoder
ce = CrossEncoder("BAAI/bge-reranker-base")
print(ce.predict([("試用期間の解除は、何日前に通知する必要があるか", "第12条 試用期間中の労働契約の解除は、3日前に通知しなければならない")]))
PY
スコアが出れば、実装は完了と見なせる。モデルを導入したくない場合は、まずはルールゲートとエンティティゲートだけを実装しても構わないが、今夜のA/Bでは、Bがどの処理を使用しているかを明確に記述すること。
検証完了:A/Bの2ラウンドにおける同一問題の比較
- まず、現在の設定をバックアップして
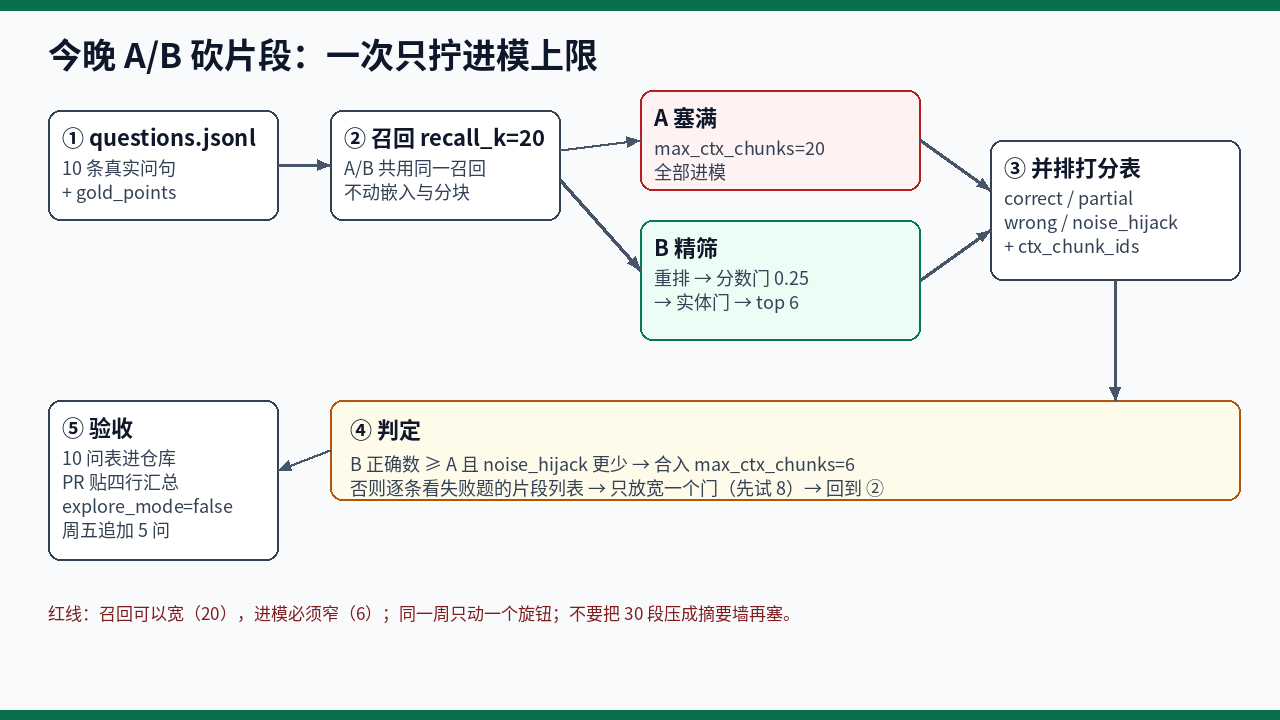
configs/rag.yaml.bak。準備questions.jsonl、各行に次のように記入する{id, question, gold_points[]}、10個の実際の質問をスレッドに投稿してください。自分で考えたものは使わないでください。 - 問題A:20問を回収し、すべてモデルに投入した。各問題について、正解と
ctx_chunk_ids. - ランB:同じリコールにおいて、再並べ替え、スコアゲート、エンティティゲートを経て、上位6つをモデルに採用し、同様にディスクに書き出した。
- 手動で並列評価を行い、各問題に「correct」「partial」「wrong」のラベルを付け、さらに「noise_hijack」(無関係な断片によって評価が歪められたか)の有無も別途ラベル付けする。
- 判定:B。正解数がA以上で、かつ誤答数が少ない場合は、Bに統合する。そうでない場合は、不正解問題の断片リストを確認し、基準を1つだけ緩和する(例えば、上限を8に設定し、ステップ2に戻る)。
4行の合計は手計算する必要はありません。採点結果を保存して scores.csv(列:id、arm、verdict、noise_hijack)、スクリプトによる出力結果:
python - <<'PY'
import csv, collections
c = collections.Counter()
for r in csv.DictReader(open("scores.csv")):
    c[(r["arm"], "correct")] += r["verdict"] == "correct"
    c[(r["arm"], "hijack")] += r["noise_hijack"] == "1"
for arm in "AB":
    print(arm, "正解", c[(arm, "correct")], "バイアスあり", c[(arm, "hijack")])
PY
もしA、Bの2ラウンドで10問すべて正解したとしたら、それは「精選」が成功したのではなく、問題の難易度が低すぎたということだ。質問を、オンライン試験で実際に間違えたタイプ――番号付きの契約条項、例外条件のある制度、同じ名称だが異なるバージョンの作業指示書――に置き換えてみる。良質な10問のテスト問題集では、Aは少なくとも2~3問は間違えるべきであり、そうして初めて比較に意味がある。問題を選ぶ際も、難問ばかりを選ばず、2~3問は標準的な問題を残し、精選プロセスによって簡単な問題が台無しになっていないかを確認するために使う。
採点する際は、必ずクリップリストを開いて確認する必要があります。解答文だけを見ていても、誤りがノイズによるものなのか、それともモデルが独自に生成したものなのかを区別できません。
設定:上限値をリポジトリに保存し、チャットには残さない
# configs/rag.yaml
retrieval:
  recall_k: 20
generation:
  max_ctx_chunks: 6 # モデルへの投入上限:デフォルトは精密フィルタリング
  min_rerank_score: 0.25     # このスコアを下回るものは即座に除外
  must_contain_entities: true
  explore_mode: false # 探索モードの明示的なオン/オフ設定。上限のサイレント引き上げを禁止
閾値 0.25 はあくまで出発点に過ぎず、再配置アルゴリズムによってスコアの分布は大きく異なります。まず、ラウンド A の 20 件の候補のスコアヒストグラムを見てみましょう。閾値は「明らかな相関」と「境界線上」の 2 つのグループの間に設定します。1週間につき、1つのパラメータのみを調整します。上限値、閾値、またはエンティティゲートのいずれかを変更します。マルチジャンプエージェントは、各ジャンプで個別に精選を行い、それぞれボード上に配置します。 ctx_chunk_ids_hopN、前のジャンプの20件の残りを次のジャンプに組み込んではならない。
失敗:最もよくある4つの落とし穴
- 「精篩」を「低リコール」と見なす:リコール数は依然として20のままで、削減されたのは「型入れ」だ。リコール数が削減されると、未回答数がすぐに跳ね上がり、チームはまた必死に回答を詰め込むことになる。
- サマリーウォール:要約モデルを使って30の段落を1つの大きな段落にまとめ、それを挿入した。段落数は少なくなったように見えるが、ノイズは残っており、確認可能な引用もなくなってしまった。いっそ、6つの短い原文の段落を残しておいたほうがよかった。
- 三重の扉がすべて開いている:再配置、ルール、エンティティの条件を同時に厳格化した結果、リコールの精度が急落した。この状況では、ルールの基準を緩和すべきであり、トップ30を無理やり戻すべきではない。
- 縫合箇所は目立たない:試用期間の解除には何日前に通知する必要があるかという質問に対し、「完全版」では、解除に関する総則、競業避止義務、研修・サービス期間を組み合わせて、一見完全に見えるが実際には内容がごちゃ混ぜになった手順を提示している。「厳選版」では試用期間に関する章のみが残されており、回答は短いものの、原文と照らし合わせて確認することができる。採点者は、このような継ぎ接ぎを見抜くことを学ぶべきであり、これは正答率のパーセンテージにこだわるよりも効果的です。
もう一つ、長年の課題があります。埋め込みモデルのアップグレード後、正答率は上昇しましたが、バイアスも増加しました。これは、新しいリコールがより「賑やか」になっていることを示しており、より厳密な選別が必要であることを意味します。この機会を利用して上限を30に戻すべきではありません。
検収:統合前の4つの必須条件を満たすこと
- 10. アンケートとA/Bテストの評価結果をリポジトリに追加する。
- 設定項目にはデフォルト値とコメントがあり、
explore_modeデフォルトではオフになっています。 - PRの説明文4行のまとめ:Aの正解数、Bの正解数、Aの偏り数、Bの偏り数。1行でも欠けている場合はやり直し。
- 業務担当者が「もう少し追加したい」場合は、再テスト表を添付しなければなりません。添付がない場合、審査では受理されません。標準的な返信は審査チャンネルのトップに固定されています:「explore_mode を有効にすることは可能ですが、本番環境ではデフォルトで max_ctx_chunks=6 となっています。上限を変更する場合は、10項目の再テスト表を添付してください。」
その後、毎週金曜日に5件の新しい再テストを追加し、データドリフトが発生して再び「ムンセ」に戻ってしまうのを防ぎます。窓口は今後も増え続けるでしょうから、その頃にはおそらく上限を30に戻したくなるはずです。再テスト表を審査会の壁に貼り出すことこそが、どんなスローガンよりも効果的です。


评论列表 (0条):
加载更多评论 読み込み中...