


BLOG / 5 novembre 2026
Le 4 novembre, OpenAI a publié un article de blog qui ressemblait à la fois à un avis de sécurité et à une facture : le cyber-modèle, dont le lancement est imminent, a analysé le noyau Linux dans un environnement de recherche isolé, laissant derrière lui 948 vulnérabilités permettant une élévation de privilèges locale (LPE) reproductibles Au total, la facture de l'API pour l'ensemble de l'exécution s'élève à 1 213 430 dollars américains——Soit environ 1 279 dollars par LPE.
Ne comprenez pas cette phrase comme signifiant que « le réseau public a été complètement mis à mal ». La machine ciblée est une machine virtuelle à des fins de recherche ; les résultats doivent être vérifiés manuellement, puis les correctifs sont transmis en amont conformément aux recommandations de la communauté. Ce qui devrait vraiment nous inquiéter, c’est le rythme des correctifs et la surface d’attaque locale, et non pas la réinstallation de toute la suite logicielle en une nuit.
948 correspond au nombre de LPE distincts après « environnement isolé + reproduction dynamique + vérification manuelle » ; il ne s'agit pas d'un stock de 0-day déjà diffusés sans distinction sur le réseau public.
À quoi ressemble un entonnoir ?
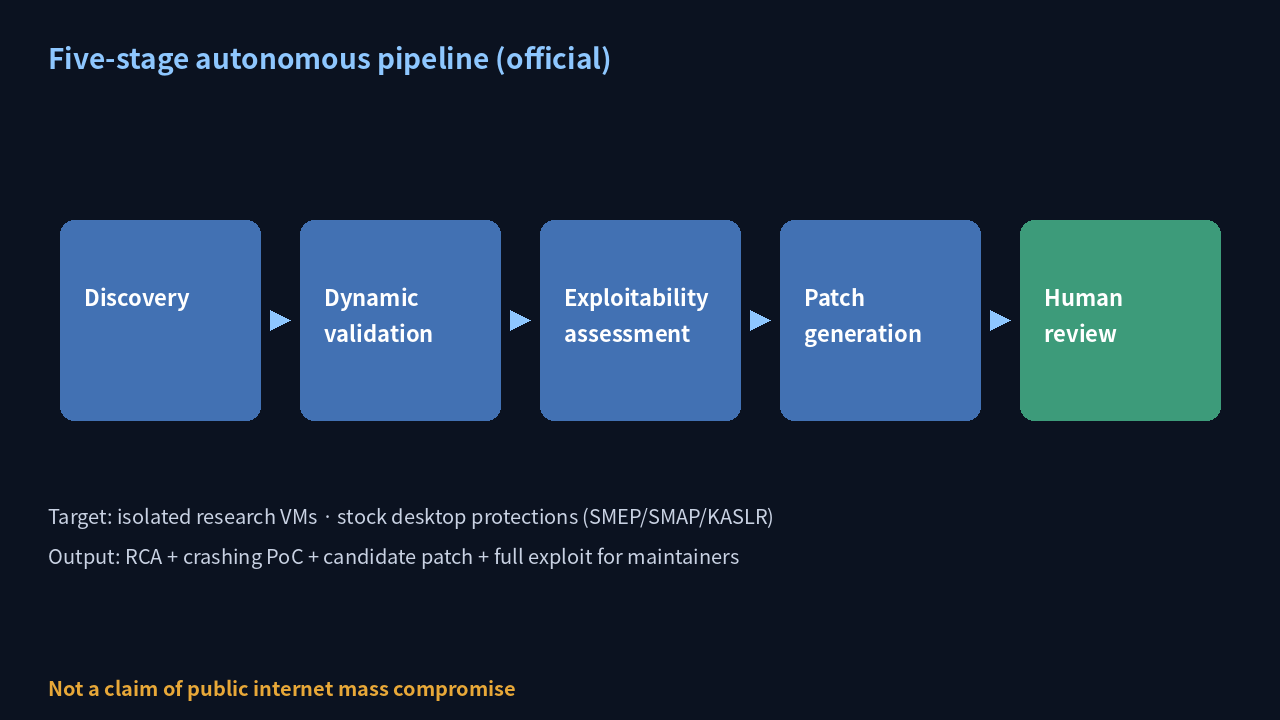
Les responsables ont divisé le processus en cinq étapes : découverte → vérification dynamique → évaluation de l'exploitabilité → génération de correctifs → révision manuelle. Les chiffres intermédiaires sont très clairs : 2 308 candidatures ont d’abord été identifiées, 1 724 failles ont été reproduites de manière dynamique, puis 291 PoC de fuite d’informations ont été générés, ainsi que 948 LPE indépendants permettant d’obtenir les privilèges root.
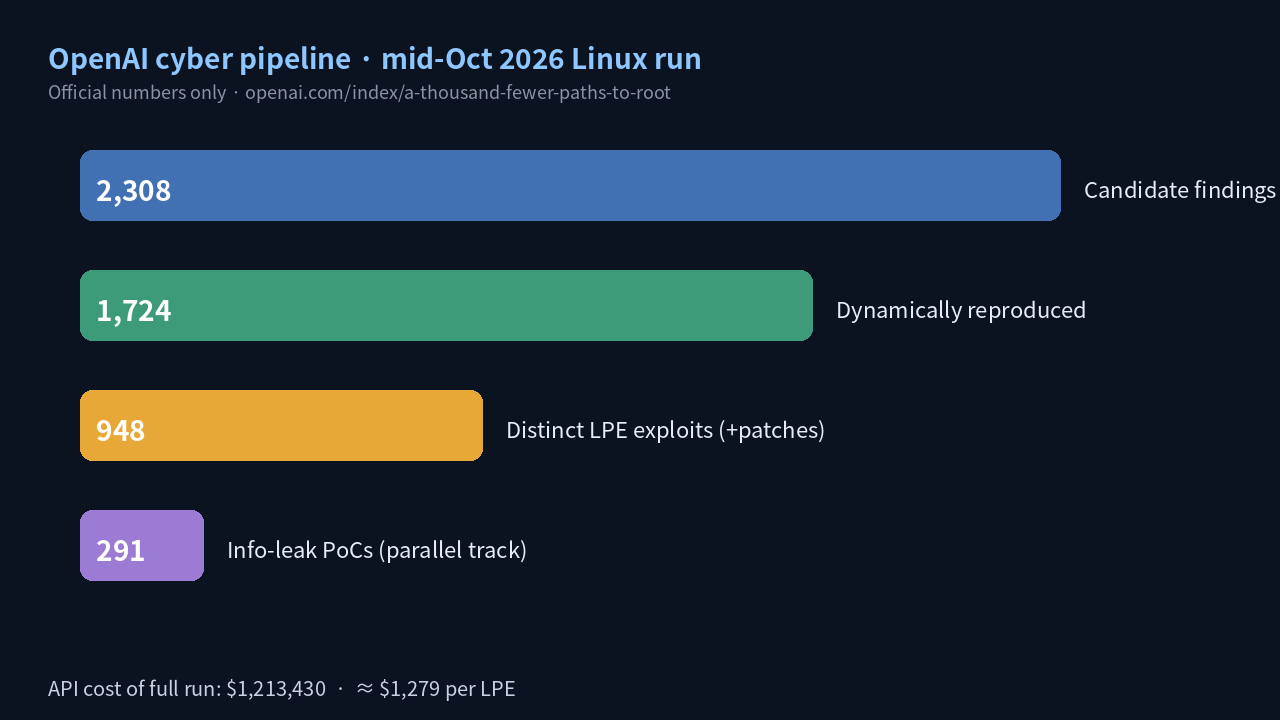
Le point de référence temporel correspond au scan effectué à la mi-octobre 2026, dont la cible était la dernière version de la branche « master » de Linux, exécutée avec une configuration de sécurité de niveau « distribution de bureau courante » : SMEP, SMAP, KASLR et HARDENED_USERCOPY étaient tous activés ; il ne s’agissait pas de désactiver délibérément ces mesures de protection pour améliorer les scores.
Scout ne transmet à Analyst qu'environ 7 % du code du noyau (environ 2,8 millions de lignes, 5 034 cibles d'audit) ; le nombre de candidats purement statiques a atteint 2 308 en 12 heures. Au cours de la phase de validation, des PoC ont été testés dans la machine virtuelle KASAN, permettant de reproduire 74,7 % des vulnérabilités en environ 30 heures. Les responsables précisent que seuls 3,1 % constituent des faux positifs dont les conditions d’analyse du modèle ne peuvent être remplies — le défi ne réside pas dans la « capacité à détecter », mais dans le choix des « vulnérabilités à corriger en priorité ».
Pourquoi choisir Linux ? Les raisons avancées par les responsables officiels sont très pragmatiques : Android, les infrastructures cloud et le calcul intensif reposent tous sur ce noyau, dont les plus de 40 millions de lignes de code exposent la surface d’attaque à travers les appels système, le réseau, le système de fichiers et les pilotes. Une fois que les détections atteignent une certaine échelle, ce qui bloque véritablement les équipes de sécurité, c’est le tri et la validation, et non pas le fait de « trouver une nouvelle alerte ».
Où l'argent a-t-il été dépensé, et quelle est la différence par rapport à juillet ?
Le coût total de l'API s'élève à 1 213 430 dollars. La répartition par phase est approximativement la suivante : pour la phase de découverte, environ 3 426 dollars pour Scout et environ 316 549 dollars pour Analyst ; environ 73 330 dollars pour la phase de validation ; pour la présélection, environ 44 194 ; pour le développement d’exploits, environ 775 929 (fuites d’informations : environ 85 000 ; LPE : environ 691 000). Les responsables soulignent qu’il s’agit là d’une « mesure des capacités » maximale, et non d’un devis technique déjà poussé à ses limites.
Si l’on suit le même fil conducteur : dans le cadre de l’initiative « Patch the Planet » de juin, GPT-5.5 Cyber a identifié et signalé 24 LPE ; fin juillet, GPT-5.6 Sol a détecté 166 LPE distincts de bout en bout, pour un coût d’environ 513 690 dollars. La mise à jour du modèle cyber de mi-octobre a porté le nombre de LPE distincts à 948 — selon les propres termes des responsables, « le nombre de LPE inédits a été multiplié par plus de cinq », bien que le noyau ait continué à être renforcé au cours des trois mois intermédiaires.
Ils ont également adapté un environnement de type kernelCTF : 25 PoC de fuite d'informations, 21 LPE, pour une API d'environ 32 936 dollars. Les montants des primes historiques de Pwn2Own / TyphoonPWN mentionnés dans l’article constituent une « estimation hypothétique » à des fins de comparaison narrative ; cela ne signifie pas qu’OpenAI ait réellement perçu cette somme. Une remarque plus utile pour les défenseurs est la suivante : compte tenu du niveau actuel des primes publiques, ce type de pipeline est « rentable sur le papier » au moment de la recherche — par conséquent, attendre que d’autres se chargent de cette analyse pour vous sera de plus en plus déficitaire.
Il existe un autre aspect financier à prendre en compte lors de la phase de développement : les tentatives infructueuses coûtent souvent plus cher que les réussites. Les responsables ont donné un exemple : certaines conditions de concurrence particulièrement difficiles à surmonter peuvent faire grimper le coût d’un seul échec à plusieurs milliers de dollars ; ils recommandent donc de définir des conditions d’abandon, telles que « arrêter l’opération si aucun progrès n’est constaté au bout d’une heure ». En d’autres termes, l’automatisation n’est pas automatiquement synonyme de réduction des coûts ; l’orchestration et les stratégies de limitation des pertes restent des défis techniques.
Au moins 10 nouvelles techniques d'exploitation, ainsi que les 10 derniers jours en amont
Après avoir analysé un échantillon de 166 exploits, les auteurs ont identifié au moins 10 techniques relativement nouvelles, même pour leurs experts-conseils : injection d’objets élastiques, réorganisation de la mise en page, élévation de privilèges par données brutes, écriture arbitraire, confusion de types, etc. — les détails n’ont pas été rendus publics pour des raisons de sécurité. Autre constat encore plus frappant : parmi les premiers résultats de tests, sur environ 200 cas de « root d'accès obtenu », une vérification manuelle a révélé que 20 d'entre eux reposaient en réalité surAutre chose 0day, et non celui qui lui avait été attribué. Une « vérification du chemin d'accès » a ensuite été ajoutée au pipeline.
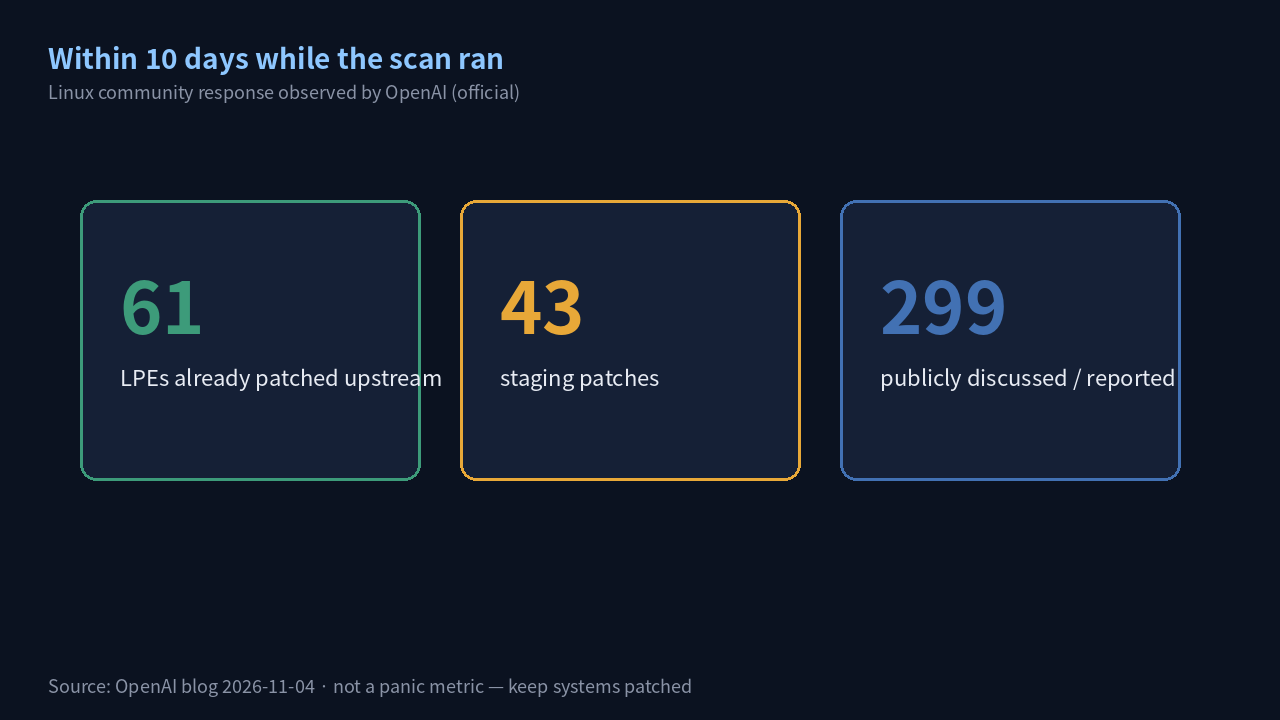
Au cours des 10 jours où l'analyse était encore en cours, les responsables ont constaté que : 61 LPE avaient déjà été intégrées dans les correctifs en amont, 43 disposaient de correctifs en phase de staging et environ 299 faisaient l'objet d'une discussion publique. En d’autres termes, les responsables de la maintenance et la communauté n’attendent pas que « l’IA rende ses conclusions » pour passer à l’action. Pour les distributions et les équipes d’exploitation, cela revient à rappeler que, en cas de retard dans l’application des correctifs, les comptes locaux à faibles privilèges se rapprochent de plus en plus d’un « équivalent root » pour les attaquants disposant de ressources suffisantes.
L'épaisseur de l'architecture évolue également en fonction des capacités du modèle. Au début, ils ont intégré une liste de 103 techniques d'exploitation dans un modèle relativement faible, ce qui a permis de faire passer le taux de réussite de 76,2 % à 88,9 % ; après être passés au modèle plus puissant GPT-5.6 Cyber, une structure allégée s’est avérée plus efficace, l’ajout de la couche de techniques n’apportant qu’un gain de 1,5 point de pourcentage. La conclusion est très « ingénieure » : la structure doit être réévaluée en fonction du modèle de base, et il ne faut pas considérer les anciens « harnais » comme des atouts permanents.
One More Thing : ne vous laissez pas influencer par le slogan « un million de dollars pour obtenir les droits root »
Les conclusions d’OpenAI penchent plutôt du côté de la défense : la génération automatisée de correctifs doit suivre le rythme des découvertes ; les bacs à sable et l’isolation (du type Firecracker ou gVisor) servent à réduire la portée des impacts ; pour les projets complexes et de grande envergure, il faut effectuer plusieurs cycles de « balayage — correction — nouveau balayage » . Ils admettent également que les premières versions des correctifs parviennent souvent à bloquer les PoC, mais qu’elles peuvent être trop lourdes, nuire aux performances, ne pas respecter le style de codage ou omettre certaines variantes — il faut donc s’appuyer sur l’itération et la vérification par confrontation. L’étude a également mis en lumière des problèmes au sein de l’infrastructure de test (telle que la configuration QEMU utilisée pour les expériences), rappelant que « le champ de tir lui-même doit d’abord faire l’objet d’un bilan de santé ».
La liste des mesures concrètes que les lecteurs peuvent mettre en œuvre est courte : suivre les mises à jour de sécurité des distributions et réduire la fenêtre de correction ; fermer toute surface d’attaque locale pouvant l’être ; dans les environnements multi-locataires et CI, ne pas utiliser par défaut « des privilèges limités équivalent à un risque faible ». Si vous gérez des chemins de noyau partagés exposés à l’extérieur, cet article s’apparente davantage à un guide de tests de résistance qu’à un document marketing.
Notre analyse :Interpréter « 1,2 million de dollars pour 948 comptes root » comme la fin du monde sur Internet revient à confondre l’entonnoir de recherche avec un rapport de bataille. Une lecture plus objective serait la suivante : les modèles de pointe ont déjà transformé la « recherche de failles + exploitation » en un pipeline reproductible ; la défense doit donc accélérer en parallèle la publication de correctifs, réduire la surface d’attaque locale et limiter la portée des incidents par l’isolation — la vérification manuelle et la collaboration en amont restent le dernier maillon, et le plus coûteux, de ce pipeline.


评论列表 (0条):
加载更多评论 Chargement...