


BLOG / 5 de noviembre de 2026
11 月 4 日,OpenAI 发了一篇读起来像安全通报、又像成本账单的博文:即将推出的 cyber model,在隔离研究环境里把 Linux 内核扫了一遍,留下 948 个可复现的本地提权(LPE) 利用,整次跑完的 API 账单是 1,213,430 美元——摊到每个 LPE 大约 1,279 美元。
别把这句读成「公网已经被炸穿了」。目标机是研究用虚拟机,产出要过人工复核,再按社区建议往上游送补丁。真正该紧张的,是补丁节奏与本地攻击面,而不是连夜重装全家桶。
948 是「隔离环境 + 动态复现 + 人工复核」后的独立 LPE 计数;不是已对公网无差别爆炸的 0day 库存。
漏斗长什么样
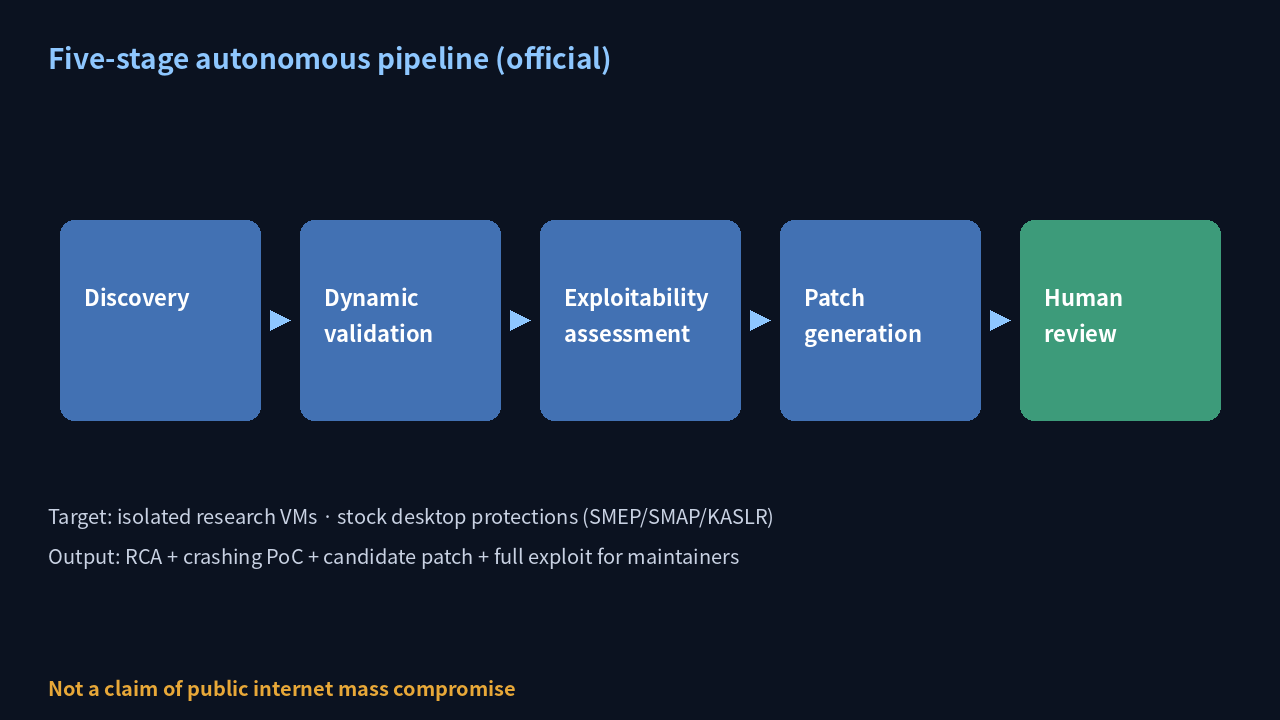
官方把管线拆成五段:发现 → 动态验证 → 可利用性评估 → 补丁生成 → 人工审查。中盘数字写得很直白:先得到 2,308 条候选,动态复现 1,724 个漏洞,再产出 291 个信息泄露 PoC,以及 948 个可拿到 root 的独立 LPE。
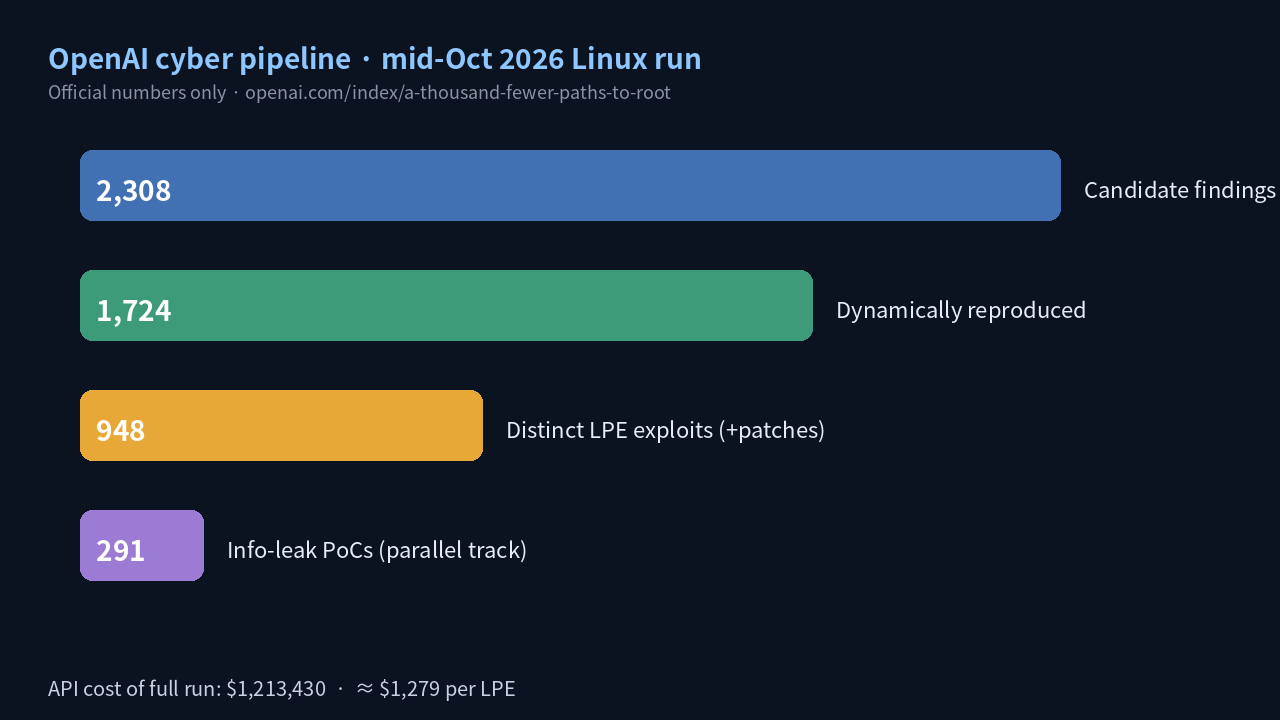
时间锚是 2026 年 10 月中旬那次扫描,目标是当时最新的 Linux master,跑在「常见桌面发行版」级别的防护配置上——SMEP、SMAP、KASLR、HARDENED_USERCOPY 都开着,不是故意拆掉缓解再刷分。
Scout 只挑约 7% 内核代码(约 280 万行、5,034 个审计目标)交给 Analyst;纯静态候选在 12 小时内堆到 2,308。验证阶段在 KASAN 虚拟机里砸 PoC,约 30 小时复现 74.7%。官方写明:只有 3.1% 属于模型分析条件不可能成立的假阳性——瓶颈不在「会不会找」,而在「哪些该先修」。
为什么选 Linux?官方给的理由很务实:Android、云基础设施、超算都压在这套内核上,四千多万行代码经系统调用、网络、文件系统与驱动向外摊开攻击面。发现端一旦规模化,真正卡住安全团队的是分诊与验证,而不是「再找一条告警」。
钱花在哪,和 7 月那次差多少
整次 API 成本 1,213,430 美元。阶段账大致是:发现侧 Scout 约 3,426、Analyst 约 316,549;验证约 73,330;筛查约 44,194;利用开发约 775,929(信息泄露约 8.5 万、LPE 约 69.1 万)。官方强调这是「能力测量」的上界,不是已经压到极限的工程报价。
对照同一条主线:6 月 Patch the Planet 叙事里,GPT-5.5 Cyber 验证并上报过 24 个 LPE;7 月末 GPT-5.6 Sol 端到端拿到 166 个独立 LPE,成本约 513,690 美元。10 月中旬更新的 cyber model 把独立 LPE 推到 948——官方自己的说法是「novel LPE 数量约五倍以上」,尽管中间三个月内核也在继续硬化。
他们还改编跑了 kernelCTF 风格环境:25 个信息泄露 PoC、21 个 LPE,API 约 32,936 美元。文中用历史 Pwn2Own / TyphoonPWN 赏金做「假想估值」,那是叙事对照,不是 OpenAI 真的去领了那笔钱。对防守方更有用的一句话是:在当前公开赏金量级下,这类管线在研究时点上「账面」划得过来——所以等着别人帮你扫,会越来越亏。
利用开发阶段还有一个成本细节:失败尝试往往比成功更贵。官方举过例子,少数难啃的竞态会把单次失败推到数千美元量级;他们建议设「一小时无进展就停」一类放弃条件。换言之,自动化并不自动等于便宜,编排与止损策略仍是工程题。
至少 10 种新利用手法,以及上游这 10 天
抽样 166 个利用后,作者判断至少出现 10 种对其专家顾问也相对新颖的手法:弹性对象喷射、页布局整理、纯数据提权、任意写、类型混淆等——细节出于安全原因没公开。另一条更刺耳的观察:早期跑分里,约 200 个「成功拿到 root」的案例,人工复核发现有 20 个其实踩的是别的 0day,而不是被指派的那一个。管线后来加了「路径校验」。
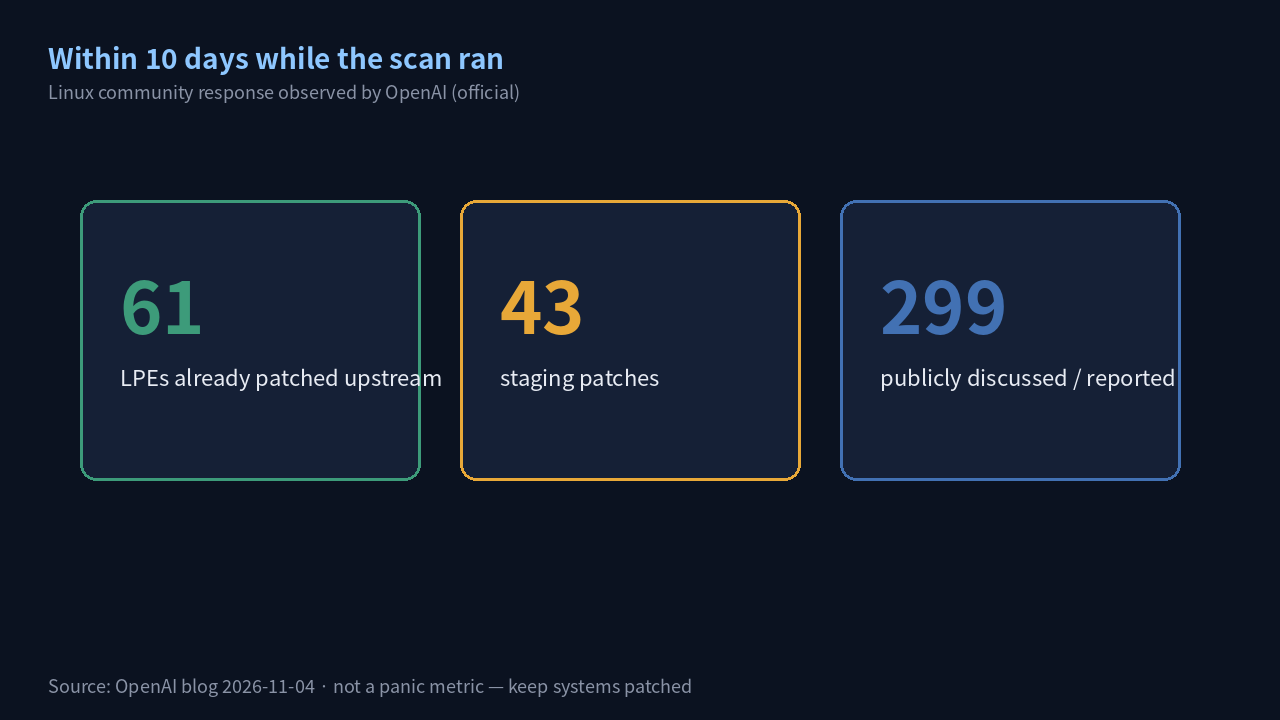
扫描还在跑的那 10 天里,官方观察到:61 个 LPE 已进上游修复、43 个有 staging 补丁、约 299 个进入公开讨论。换句话说,维护者与社区并不是「等 AI 交卷才动手」。对发行版和运维,这更像在提醒——本地低权限账号,在补丁滞后时,对有资源的攻击者越来越接近「等价 root」。
编排厚度也在跟着模型能力变。早期他们给较弱模型塞了 103 条利用技巧清单,成功率从 76.2% 抬到 88.9%;换到更强的 GPT-5.6 Cyber 后,轻编排反而更好,加回技巧层只多 1.5 个百分点。结论很工程师:脚手架要随基座模型重估,别把旧 harness 当成永久资产。
One More Thing:别被「百万美元买 root」带节奏
OpenAI 自己的结论偏向防守侧:自动化补丁生成必须跟上发现速度;沙箱与隔离(Firecracker、gVisor 一类)用来缩爆炸半径;对大型复杂项目要多轮「扫—修—再扫」。他们也坦白:补丁初稿常能挡住 PoC,但可能啰嗦、伤性能、不合风格或漏变体——要靠迭代与对抗审查。研究中还顺手挖到测试基建(如实验用 QEMU 构建)里的问题,提醒「打靶场本身也要先体检」。
对读者可落地的动作清单很短:跟踪发行版安全更新并缩短补丁窗口;能关的本地攻击面就关;多租户与 CI 跑内核相关负载时,别默认「低权限等于低风险」。若你维护的是对外暴露的共享内核路径,这篇更像压力测试说明书,而不是营销稿。
Nuestra valoración:把「120 万美元买到 948 个 root」读成公网末日,是错把研究漏斗当成战场战报。更冷静的读法是:前沿模型已把「找洞 + 做利用」做成可重复流水线,防守必须同步加速打补丁、缩小本地攻击面,并用隔离限制爆炸半径——人工复核与上游协作,仍是这条管线最后也最贵的闸门。


评论列表 (0条):
加载更多评论 Cargando...