


去年我还在为每个模型厂商写一套薄封装:鉴权头不一样、流式字段不一样、错误码要人肉翻译。后来把调用收进 BerriAI/litellm,业务代码只认 OpenAI 形态的 chat.completions。结论先说:LiteLLM 实测下来,多模型统一接口后,我少写了一半厂商适配代码——剩下一半是预算、密钥轮转和「何时不该用网关」的判断。本文是Structure d'agrégation:以 LiteLLM 为第一站,把 SDK 直连、原生厂商 SDK、自研网关按「什么时候该换」聚到一条路由上;最后两节是安装冒烟和第一周的配置要点与翻车排查。
定位:统一接口解决什么、不解决什么
LiteLLM 给你两种用法:Python SDK 里 completion() 一把梭;或起一个自托管的 AI Gateway(Proxy),让任何 OpenAI 兼容客户端把 base_url 指过来。官方文档把它说成:应用只跟网关说话,网关再跟一百多家上游说话。我真正省下的,不是「少写几行 HTTP」,而是少维护几套重试、错误归一和模型名映射。
Convient à :团队已经同时用两家以上模型;想用虚拟密钥做预算与限流;希望业务代码不随上游 SDK 大版本一起抖。
Ne convient pas :你只绑死一家模型且要用到该厂最新独占 API 细节;你需要毫秒级额外延迟为零的嵌入式路径(网关再轻也有一跳);你把网关误当成「安全边界的全部」——密钥仍要管,提示词注入仍要防。
读 README 与 docs.litellm.ai 时我先看:支持的 providers 列表、Proxy 快速开始、config.yaml 的 model_list、虚拟密钥与 spend tracking。版本与 extras 名称以你安装当日文档为准,本文不锁死次版本号。
和托管聚合服务怎么选:如果你不想自己运维任何东西,OpenRouter 一类托管聚合服务也能一个密钥调多家模型,代价是流量和账单都经过第三方。我的判断是:个人项目、原型期用托管省事;团队需要自管密钥、自定预算、日志留在自己机房时,选自托管的 LiteLLM。两者接口都是 OpenAI 形态,前期选错了迁移成本也不高,先按「数据能不能出门」这一条定。
Fiche de projet
| 项 | Contenu |
|---|---|
| Entrepôt | https://github.com/BerriAI/litellm |
| 文档 | https://docs.litellm.ai/docs/ |
| Morphologie | Python SDK + 自托管 Proxy(OpenAI 兼容) |
| Autorisation | Sous réserve de la licence du dépôt (à vérifier avant l'installation) |
| Convient à | 多模型统一调用、预算/虚拟密钥、负载与兜底 |
| Ne convient pas | 单厂最新独占特性要第一天跟上、零额外跳的内嵌极限路径 |
卡片之外我还会问自己两个问题:团队有没有人愿意值班网关?有没有地方存 master key 与上游密钥?两问都「没有」时,先用 SDK 模式在单服务里统一接口,比急着上 Proxy 更稳。
用例:切模型与打 budget
用例一:同一业务只改 model 字段。我把「草稿生成」和「最终润色」指到两个 model_name。客户端始终是 OpenAI SDK,base_url 指向本地 Proxy。切换模型不再改 import,也不再改鉴权分支。验收很土:对同一提示各打一枪,看响应头或日志里的上游模型名是否符合预期,延迟是否在自己设的阈值内。
用例二:给虚拟密钥挂预算。官方 Gateway 能力里明确有 virtual key、spend tracking、按用户/团队看花费。我给「试玩环境」钥匙设更低预算,给「批跑任务」钥匙设更高预算但仍封顶。验收:故意打超预算请求,应被拒绝或告警,而不是默默刷爆账单。预算不是财务装饰,是生产刹车。
用例三:主模型限流时自动兜底。在 config 的 litellm_settings 里给 draft 配一个 fallbacks 到 polish,主模型返回限流或超时,网关替你重试到兜底模型,业务代码不用写第二套 try/except。验收:把主模型密钥换成一个限流很低的测试钥匙,连打几次,确认响应仍是 200、日志里能看到发生过兜底。兜底模型要选价格和能力都能接受的,否则一次上游故障就变成一次账单事故。
这两个用例解决的是「适配代码爆炸」和「账单失控」——恰好是我过去半年最烦的两件事。日志接到 Langfuse / OTEL 一类后端是加分项,但第一周不必上满;先让切模型与预算拒绝可演示。
迁移顺序:先旁路、再切流。旧代码路径保留一到两周,新路径经 LiteLLM 打影子流量,对比状态码、延迟和抽样答案质量;影子阶段只写日志,不改用户可见结果。差异大就停,别为了「统一」而统一。我自己的节奏是:周一上影子,周三看差异决定是否切 10% 流量,周五查预算拒绝有没有误伤正常批跑。
优缺点短表:何时换回原生 SDK
| Préparation | 何时换到它 |
|---|---|
| LiteLLM SDK | 单服务内多模型,暂不想运维 Proxy |
| LiteLLM Proxy | 多服务共享密钥、预算、兜底与统一日志 |
| 厂商原生 SDK | 要用当日才发布的独占 API / 精细流控 |
| 自研网关 | 合规要求代码完全自控,且有专职平台组 |
Avantages :OpenAI 兼容心智负担低;模型别名好做灰度;预算与密钥集中。
Inconvénients :多一跳要监控;个别上游特性映射会滞后;把所有流量经一台 Proxy 时,可用性变成单点——要准备多实例与健康检查。
我何时换回原生 SDK:当某次发布必须用上该厂特有的工具调用字段或批处理接口,而 LiteLLM 映射尚未覆盖,且业务 deadline 紧过「等上游开 issue」。换回去不是背叛统一接口,是承认边界。等映射跟上,再迁回网关。
成本账先算再上 Proxy:少写一半适配代码,省的是工程师周数;网关的机器与值班是新成本。两者相抵仍划算才上。一周只有几百次调用、且只用一家模型时,SDK 直连更诚实——工具跟着约束走,不跟着明星项目热度走。
Installation et premier test de fonctionnement (à réaliser dès ce soir)
按官方 Getting Started / Proxy 文档,最小路径可以是:安装带 proxy 的包,写一份两行模型的 config,起服务,用 OpenAI 客户端打一枪。
# 安装以当前文档为准,示意:
pip install 'litellm[proxy]'   # 或 uv tool install 'litellm[proxy]'

# config.yaml 示意(密钥用环境变量,勿提交仓库)
model_list:
  - model_name: draft
    litellm_params:
      model: openai/gpt-4o-mini
      api_key: os.environ/OPENAI_API_KEY
  - model_name: polish
    litellm_params:
      model: anthropic/claude-sonnet-4-5
      api_key: os.environ/ANTHROPIC_API_KEY

litellm --config config.yaml
# 默认 :4000 后:
# OpenAI(base_url="http://127.0.0.1:4000", api_key="sk-...")
# 只改 model="draft" / "polish"
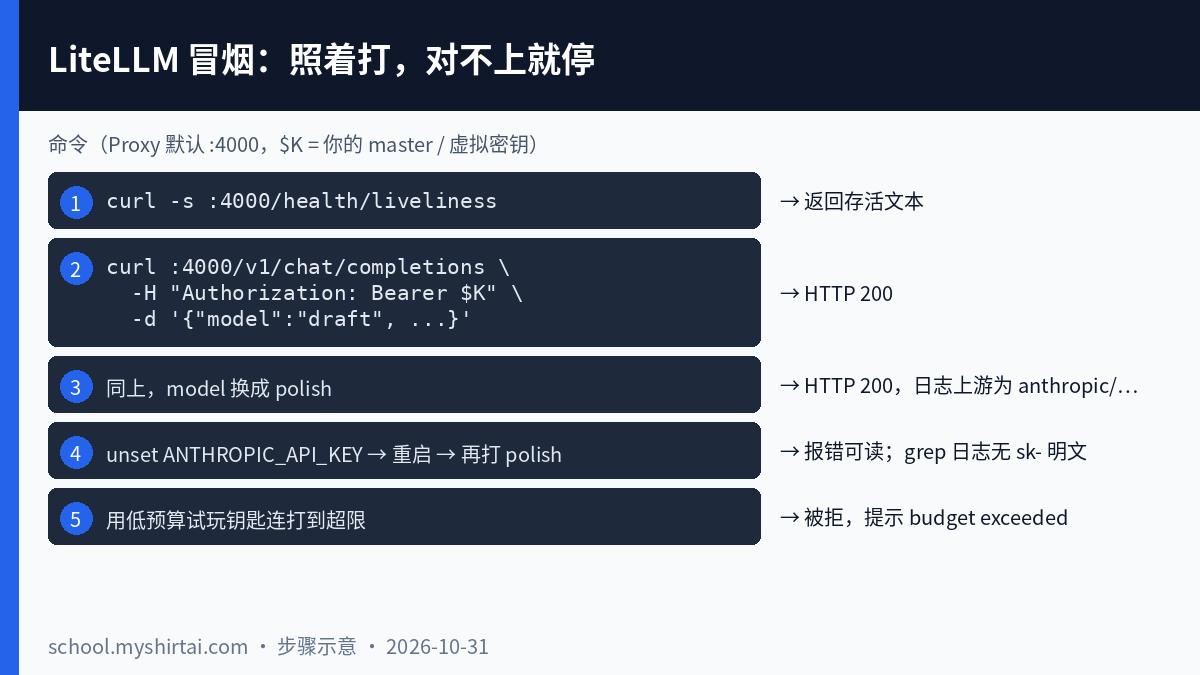
起服务后按上图从上往下打,哪一条和期望对不上就停在那一条,先别接业务。第 4 条最容易被跳过,但它决定线上出事时日志能不能直接发给同事看。批处理只会放大失败。团队已经容器化的,直接用官方 Docker 镜像(docker.litellm.ai/berriai/litellm 一类标签以文档为准),减少「我机器能跑」纠纷。
第 5 条跑不起来先查前置条件:虚拟密钥与花费统计依赖 general_settings 里的 master_key 和一个 Postgres 数据库(环境变量 DATABASE_URL)。只写了模型列表、没接数据库时,生成钥匙的接口会直接报错,这不是预算逻辑坏了。本地试可以用 Docker 起一个临时 Postgres;master_key 以 sk- 开头,同样走环境变量注入,生成试玩钥匙时带上 max_budget 与允许的 models 列表。
Points clés de la configuration et dépannage en cas de plantage (première semaine)
冒烟过了,第一周只做配置收口,不加新能力:虚拟密钥、护栏、负载均衡都可以等预发跑稳再叠。
配置要点(照着改):
- config 进 git,密钥走注入:config.yaml 与注入方式写进仓库文档,密钥本身放密钥柜;改配置走「提交 → 滚动重启」,流量上来后再按官方文档评估热更新。
- 钥匙按用途拆:试玩钥匙低预算、批跑钥匙高预算但封顶,一把钥匙不通吃。
- 主模型 + 兜底模型写进路由:业务只认 model_name,错误按 OpenAI 形态统一处理,不再写厂商分支。
- 健康检查挂进现有探活:多实例部署,别让一台 Proxy 成为单点。
- 先定哪些字段不出网:用户原文、证件类编号、密钥能哈希就哈希、能截断就截断;合规要求不出专有云时,Proxy 与日志后端放同一边界,不指向公共 SaaS。
- 列「仍走原生 SDK」例外清单,锁小版本:升级先读 changelog,在预发重跑冒烟再放量。
翻车排查(按症状查):
| 症状 | 先查 | 动作 |
|---|---|---|
| 预算拒绝误伤正常批跑 | 是不是试玩钥匙被复用到了批跑任务 | 按用途拆钥匙:试玩就是试玩,批跑就是批跑;别第一反应关预算 |
| 灰度名单莫名漂移 | 有没有人在服务器上手改过容器里的 yaml | 以 git 里的 config 为准重新部署;生产禁止手改 |
| 升级后报错,说不清是谁的锅 | 这次是否同时改了提示词和网关版本 | 回滚网关版本,单独重跑冒烟五条再放量 |
| 上游报错细节丢了 | LiteLLM 映射后的错误是否保留原始响应 | 把原始错误写进结构化日志字段,只给值班看 |
| 单测账单异常 | CI 里是不是有测试真打了付费 API | 单测改用假上游或录制回放,集成测试只在预发跑 |
| 新人加模型去改了业务代码 | 团队手册里有没有「新增 model_name」的说明 | 补半页文档 + 一个示例 PR,抽象泄漏先修文档 |
若只改一个习惯:消灭业务代码里 import openai 又 import anthropic 的双栈,先收进 LiteLLM 一条调用链。
说明:统一接口降低适配成本,不降低泄密成本;开源许可证允许你改网关,不等于客户允许你把原文打到第三方后端。版本、extras 与 LICENSE 以 GitHub / docs.litellm.ai 当前页为准,本文不替代官方说明。


评论列表 (0条):
加载更多评论 Chargement...