


从信息检索的技术架构与商业模式来看,AI搜索若试图在通用索引规模、高并发低延迟响应以及关键词广告变现上正面对抗传统搜索引擎,不仅需要承受极高的单次推理算力成本,还会陷入成熟巨头构建的生态护城河中。避开这种存量竞争的核心逻辑,在于完成从“网页链接分发”到“确定性任务闭环”的范式转移。
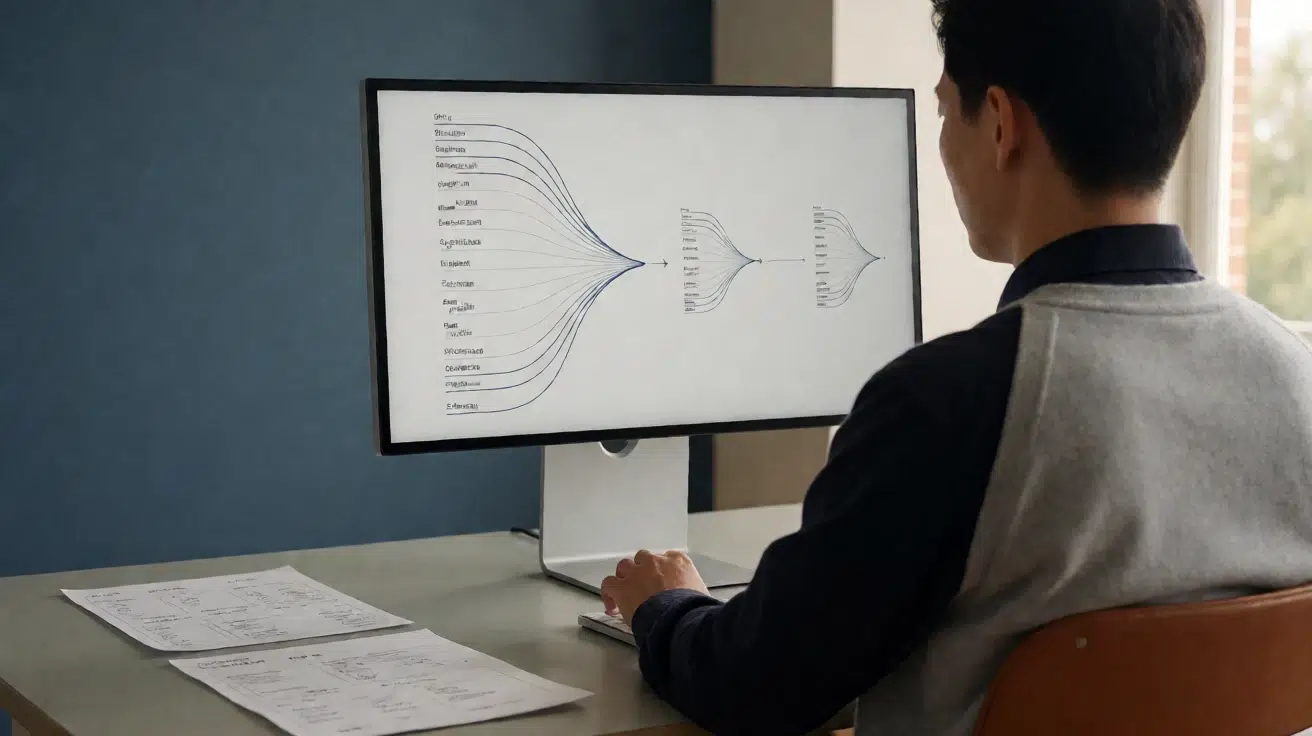
传统搜索本质上是基于倒排索引的信息路由机制,商业价值建立在展示尽可能多的链接候选以获取流量与点击广告收益。而AI搜索的底层架构基于生成式模型的语义理解与多源信息综合,其破局点在于放弃对通用海量网页索引的执念,转向深度推理与复杂问题的端到端交付。面对模糊、多步骤或高度跨学科的查询需求,用户不再需要自行筛选十几个网页并拼接信息,系统直接输出经过归纳、核验与逻辑重构的结构化答案,从而在信息交付的效率上形成差异化代际优势。
锚定垂类高价值场景
避开正面战场的有效路径,是将能力收拢于传统网页索引难以充分覆盖的垂直领域,例如专业代码研发、金融与商业分析、法律文献推演等深层场景。
在通用网络环境下,大量高价值信息沉淀在企业内网知识库、结构化数据库以及长篇行业研究中。传统爬虫受制于权限、格式和动态交互,往往只能抓取表面摘要。AI搜索可以通过结合向量检索增强生成机制与特定领域的上下文理解,直接接入专业语料环境。这类场景的用户对单次检索的响应速度相对宽容,但对信息提炼的精确度与上下文连贯性有着极高要求,同时具备清晰的订阅制或软件付费意愿,从而规避了依靠通用流量争夺广告预算的恶性循环。
从检索入口演进为执行中枢
另一个结构性差异在于交互链条的深度。传统搜索的终点通常是跳转离开,而新型AI搜索的终点是完成操作。
通过将检索能力与工具调用、工作流编排深度整合,搜索不再仅是寻找答案的工具,而是作为驱动下游任务的起点。用户发起查询的目的往往是解决某个现实任务,例如生成一份对比方案、编写一段特定逻辑的脚本或完成多阶段数据归纳。AI搜索在此过程中同时扮演分析者与执行者的角色,这种深度的交互黏性使它能够建立独立于传统网页导航之外的全新使用习惯。
将竞争焦点从“全网信息入口”转移到“复杂决策辅助”,AI搜索便能在算力成本、变现路径与用户心智之间找到平衡,在巨头笼罩的成熟信息分发生态外建立属于自己的业务壁垒。

评论列表 (14条):
加载更多评论 Laden...