


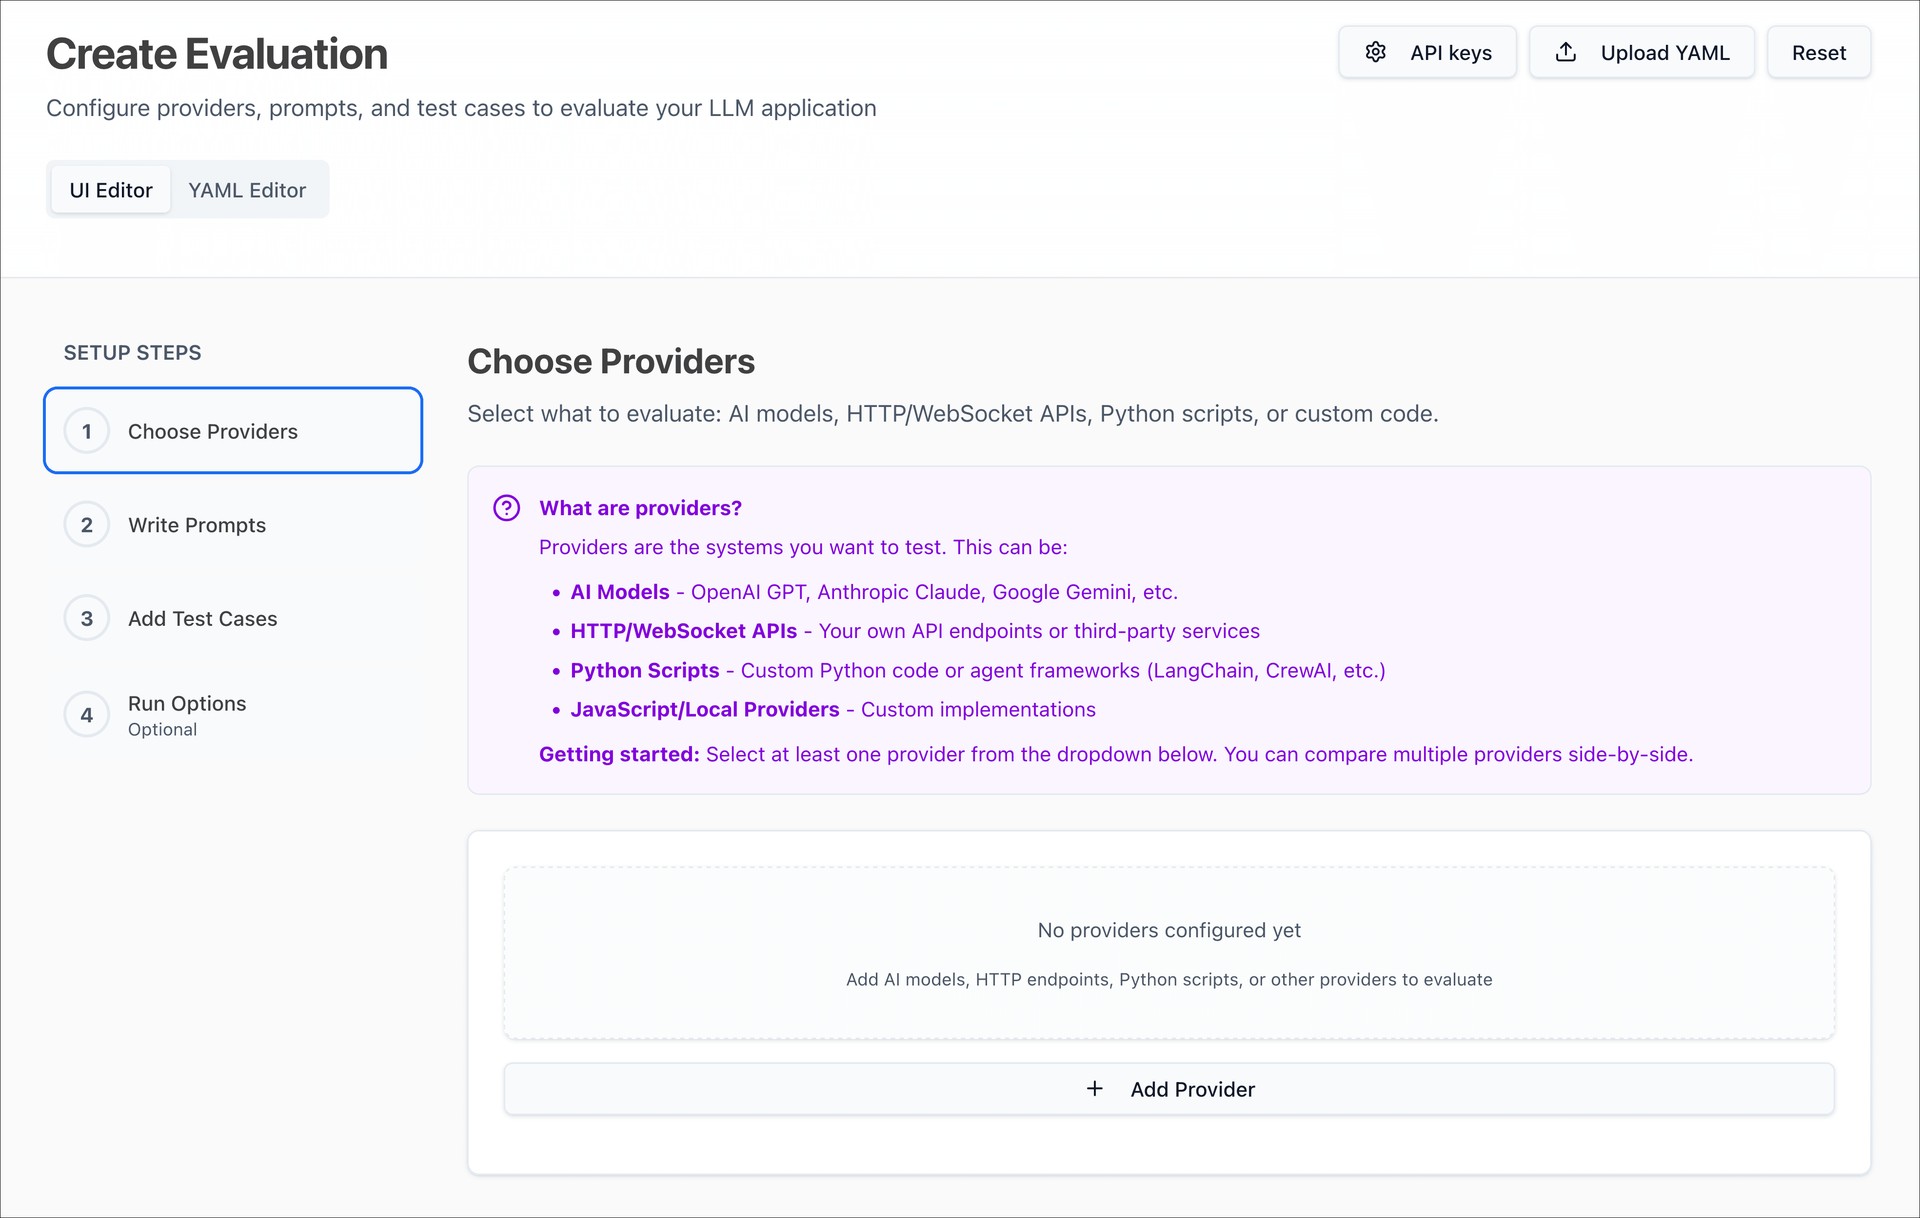
用 Promptfoo 做提示词与模型评测:文档核验版上手指南
文档核验版上手指南:在 Node.js 22.22.0 或更新版本上,按官方文档用 init --example get...

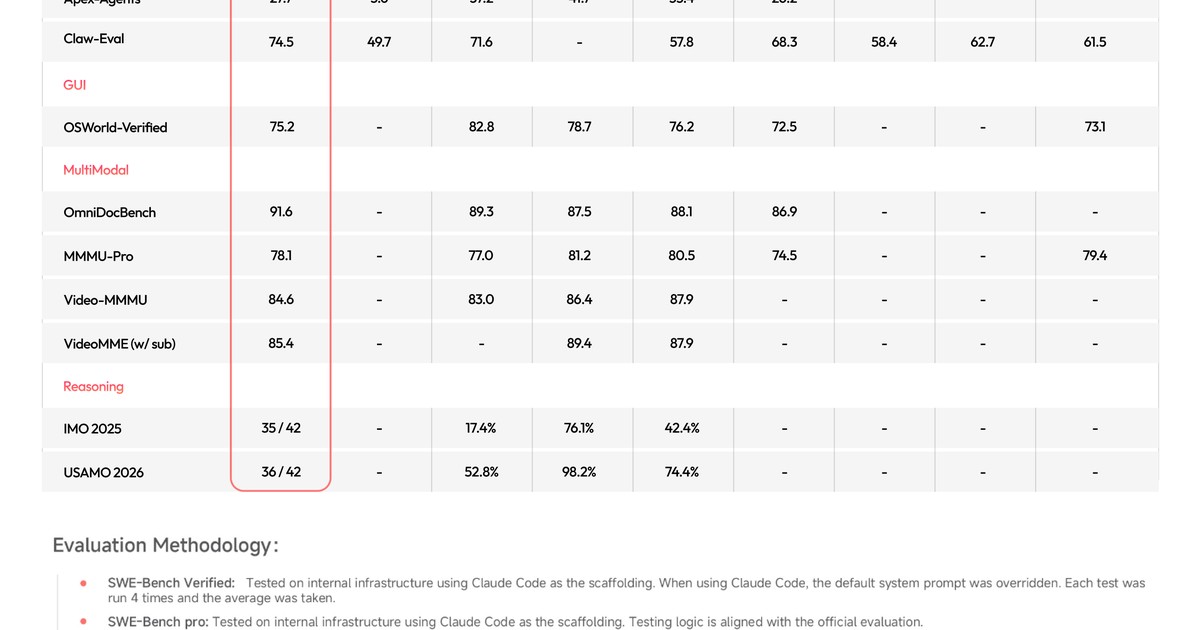
Sollte der Codierungs-Agent nach der Veröffentlichung des MiniMax M3 als Open-Source-Projekt sofort umgestellt werden?
Ein dreidimensionaler Vergleich rund um die Open-Source-Gewichtungen von MiniMax M3: Closed-Source-Modelldateien des Flaggschiffmodells vs. M3-API/Gewichtungsdienst – unter Berücksichtigung der Long-Position-Erfüllungsrate, der Stückkosten und multimodaler Aspekte...
Sollten Agent-Aufträge im Stapelbetrieb sofort auf eine günstigere „computer-use“-Tarifstufe umgestellt werden?
Im Vergleich zu GPT-6.1 Terra: Offizielle Preise – Flaggschiff-Segment vs. kostengünstiges Segment für den Computergebrauch hinsichtlich Fertigstellungsrate, Kosten pro Aufgabe und Fehlerquote...
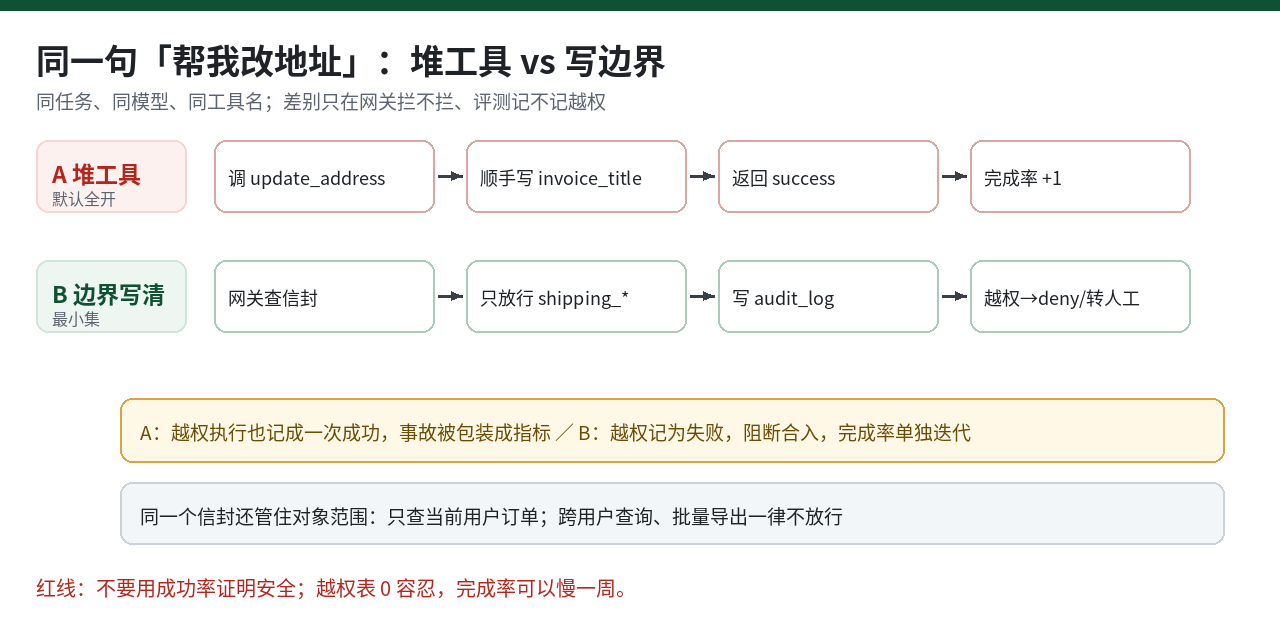
Wenn ein Agent versagt, liegt das meist nicht daran, dass die Werkzeuge nicht ausreichen, sondern daran, dass die Handlungsgrenzen nicht klar definiert sind.
Vergleich: Klar definierte Grenzen vs. Heap-Tools. Die Erfolgsquote ist kein Sicherheitskriterium; heute Abend werde ich die Umschläge vorbereiten und die Tests mit Use-Case-Szenarien, die die Zugriffsgrenzen überschreiten, wiederholen.
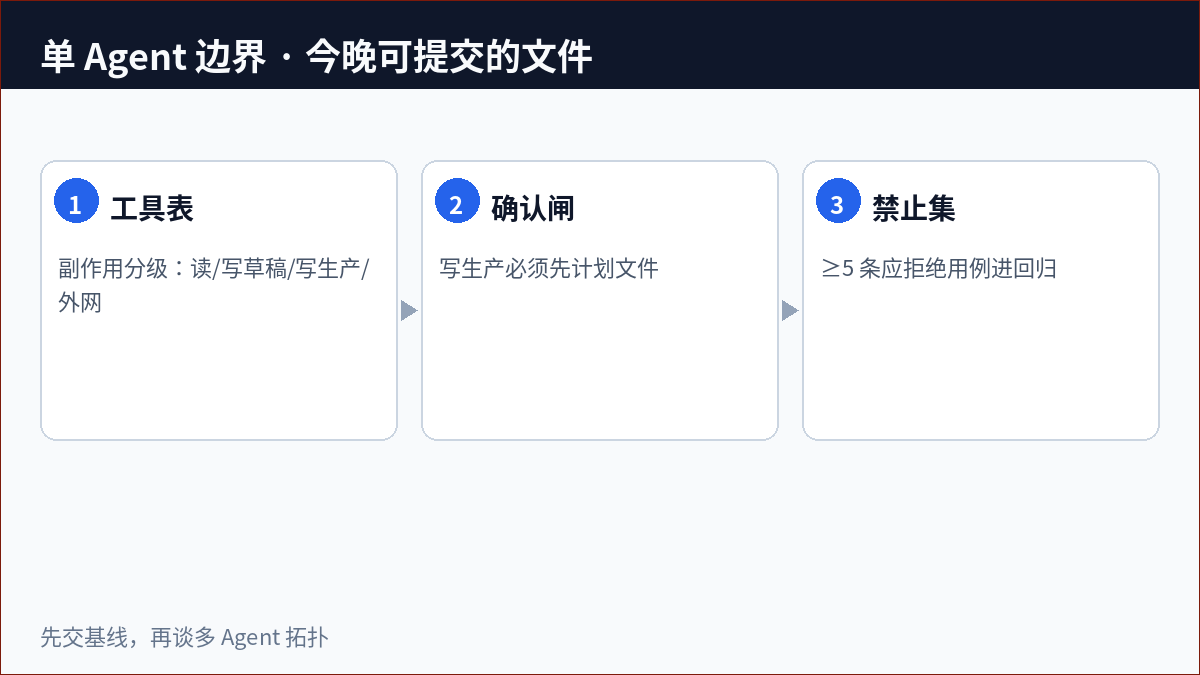
Multi-Agent-Systeme sehen zwar spannend aus, aber ich möchte lieber zunächst die Grenzen des Single-Agent-Tools klar definieren.
Dreiteiliges Set zur Aggregation ausführbarer Grenzen: Tool-Tabelle, Bestätigungsschleuse, verbotene Anwendungsfälle; kann heute Abend eingereicht werden, keine leeren Worte über mehrere Agenten.
