AI-Tagesüberblick
AI-Kurzmeldungen von heute
Ausgewählte Trends, Produktneuheiten und praktische Anwendungsbeispiele
Claude Code schränkt lediglich Anfragen ein, die darauf abzielen, bestimmte Spiele anderer direkt nachzubilden, nicht jedoch die Spieleentwicklung an sich: Laut einem Bericht von The Verge werden originelle Spiele sowie Projekte, die eigene Designs und Materialien verwenden, weiterhin unterstützt. Weitere vier Meldungen in dieser Ausgabe: Qodo wird den Zugang zu Programmiersitzungen überprüfen, LifeVal nutzt ein Bewertungsmodell für alltägliche Aufgaben, WIRED untersucht versteckte Missbrauchsfunktionen in gängigen KI-Tools, und Japan plant eine Anpassung des Zulassungsverfahrens für lenkradlose autonome Fahrzeuge.
Verzeichnis (auf der Festplatte des Computers)
01
Claude Code verschärft die Beschränkungen für Spiel-Remakes, während die Entwicklung von Originaltiteln weiterhin unterstützt wird
02
Qodo wird in Codex integriert, wodurch die repositoryübergreifende Überprüfung bereits vor der Einreichung eines PR erfolgt
03
LifeVal – Bewertungsmodell für die Auswahl von Kindergärten, die Wohnungssuche und Betreuungsaufgaben
04
WIRED-Untersuchung: Rund 400 KI-Apps und -Websites verbergen Funktionen, die zu Missbrauch führen können
05
Japan plant eine Anpassung der Zulassungsvorschriften für lenkradlose autonome Fahrzeuge; der Entwurf muss noch diskutiert werden
06
Pando unterstützt die Entwicklung des monolithischen Repositorys von OpenAI – die mediane Push-Verzögerung sank um fast 80 %
07
Kimi demonstrierte, wie man 20 Stunden am Stück arbeitet und ein natives Spielprojekt fertigstellt.
08
Goldman Sachs schränkt den Zugriff auf KI-Programmierwerkzeuge ein – nur Ingenieure behalten Zugriff
09
Bei Anthropic gehen Umsatzwachstum und steigende Verluste Hand in Hand
10
Bei Tests mit HomeView OS wurde kein App Store gefunden; die App-Funktionalität basiert auf CarPlay
01
Claude Code verschärft die Beschränkungen für Spiel-Remakes, während die Entwicklung von Originaltiteln weiterhin unterstützt wird
03.11.2026, 08:28:59 Uhr (Asia/Shanghai)
Das Erstellen von Spielen mit Claude Code ist weiterhin erlaubt, doch die direkte Nachbildung bestimmter Spiele anderer unterliegt nun klareren Einschränkungen. Wie The Verge berichtet, hat Anthropic bestätigt, dass zwei Sätze in die System-Prompts von Claude Code mit Opus 5.5 hinzugefügt wurden, um solche Nachbildungen einzuschränken. Als Begründung wurde angeführt, dass die Nutzung von Claude zur Verletzung von Rechten des geistigen Eigentums gegen die Nutzungsrichtlinien verstößt. Dies bedeutet jedoch nicht, dass jegliche Spieleentwicklung verboten ist.
Für Entwickler kommt es auf den konkreten Inhalt der Anfrage an. Gemäß den Erläuterungen in dem Bericht sollten originelle Spiele, Spiele bestimmter Genres sowie Projekte, die eigene Entwürfe und Materialien der Nutzer verwenden, weiterhin wie gewohnt unterstützt werden. Daher darf man die “Entwicklung eines Spiels eines bestimmten Genres” nicht mit der “Nachbildung eines bereits existierenden Werks” verwechseln; ebenso wenig kann die Entscheidung des Tools, ob ein Antrag angenommen wird, eine rechtliche Beurteilung des konkreten Projekts ersetzen.
Es bleibt abzuwarten, ob diese Einschränkungen tatsächlich genau zwischen Originalen und Nachbildungen unterscheiden können. Addy Osmani von Anthropic erklärte, dass weitere Anpassungen vorgenommen würden, und bat Nutzer, deren Originalprojekte abgelehnt wurden, um Feedback. Für Teams, die derzeit an Prototypen arbeiten, lohnt es sich, nicht nur die generierten Ergebnisse im Auge zu behalten, sondern auch die Anforderungsbeschreibung und den Projektkontext zum Zeitpunkt der Ablehnung zu dokumentieren, um Probleme mit fälschlichen Ablehnungen melden zu können.
Derzeit ist noch unklar, ob die Prompts anderer Claude-Systeme ebenfalls aktualisiert wurden, und die vorliegenden Informationen reichen nicht aus, um alle betroffenen Versionen und den gesamten Nutzerkreis zu bestimmen. Wir gehen davon aus, dass diese Änderung eher als Einschränkung bestimmter Nachahmungsanfragen zu verstehen ist und nicht als vollständiger Rückzug von Claude aus der Spieleentwicklung. Der Umfang der Einschränkung und die Fälle von fälschlichen Ablehnungen müssen noch durch weitere Dokumentation und Rückmeldungen bestätigt werden.
02
Qodo wird in Codex integriert, wodurch die repositoryübergreifende Überprüfung bereits vor der Einreichung eines PR erfolgt
03.11.2026, 08:28:59 Uhr (Asia/Shanghai)
Auch wenn der Code im aktuellen Repository korrekt geändert wurde, bedeutet das nicht, dass bei nachgelagerten Diensten keine Probleme auftreten können. Laut einer Einführung von OpenAI bietet Qodo bereits Plugins im Codex-Plugin-Marktplatz an, die das Wissen aus dem Unternehmenscodebestand, organisatorische Regeln und unabhängige Überprüfungen in die Codierungssitzungen integrieren: Vor dem Codieren werden relevante Regeln und historische Pull-Anfragen abgerufen, und nach der Änderung werden die Überprüfungsergebnisse in derselben Sitzung zurückgegeben, wodurch die Überprüfung bereits vor dem Einreichen einer Pull-Anfrage durch den Entwickler erfolgt.
Qodo gibt an, dass die Umgebungen seiner Kunden möglicherweise Zehntausende von Repositories umfassen, wobei der Kontext verschiedene Git-Hosting-Plattformen sowie über Kafka verbundene Dienste abdecken kann. Dies sind Angaben des Anbieters, die nicht direkt als Beweis für die Wirksamkeit der Überprüfung angesehen werden können. Nach unserer Einschätzung bietet das System zwar konkrete Ansatzpunkte für die Überprüfung von Abhängigkeiten über mehrere Repositorys hinweg, doch fehlt es noch an einer unabhängigen Überprüfung, ob dadurch Überprüfungslücken vermieden und der Aufwand für manuelle Überprüfungen verringert werden können; “nur die Probleme, bei denen sich die intelligenten Systeme nicht einigen können, an Menschen weiterzuleiten”, bleibt ebenfalls ein Produktziel und ist noch keine realisierte Funktion.
03
LifeVal – Bewertungsmodell für die Auswahl von Kindergärten, die Wohnungssuche und Betreuungsaufgaben
03.11.2026, 08:28:59 Uhr (Asia/Shanghai)
Ob KI alltägliche Aufgaben bewältigen kann, wird derzeit anhand konkreterer Testaufgaben geprüft. Das von OpenAI vorgestellte LifeVal deckt Aufgaben wie die Auswahl eines Kindergartens, die Wohnungssuche und die Organisation von Betreuungsleistungen ab. Das Unternehmen gibt an, es im vergangenen Jahr genutzt zu haben, um die Modellverbesserung zu verfolgen und voranzutreiben. Die Aufgaben wurden auf der Grundlage von Erhebungen zur Zeitnutzung in den USA und anderen Ländern sowie einer Bedarfsumfrage unter 3.995 Befragten konzipiert und umfassen Bereiche wie Gesundheit, Bildung, Haushaltsfinanzen, Einkaufen und öffentliche Dienstleistungen.
Diese Aufgaben beziehen sich auf Browser-, Computer- und Konnektivitätsfunktionen, doch da die vorhandenen Quellen keine Angaben zu den konkret getesteten Modellen und den Bewertungskriterien enthalten, lässt sich die Zuverlässigkeit im tatsächlichen Einsatz nicht beurteilen, und die Testergebnisse können keinesfalls als Sicherheitsgarantie für Aufgaben in den Bereichen Gesundheit, Pflege oder Finanzen angesehen werden. Wir sind der Ansicht, dass LifeVal für Produktteams im Bereich der persönlichen Assistenz eher als Referenz für die Gestaltung von Testaufgaben dienen sollte, anstatt direkt für die Modellauswahl oder Dienstleistungsempfehlungen herangezogen zu werden.
04
WIRED-Untersuchung: Rund 400 KI-Apps und -Websites verbergen Funktionen, die zu Missbrauch führen können
03.11.2026, 08:29:06 Uhr (Asia/Shanghai)
Selbst scheinbar gewöhnliche KI-Tools können ein erhebliches Missbrauchsrisiko bergen. Eine Untersuchung von WIRED ergab, dass etwa 400 Apps und Websites, die mit chinesischen Entwicklern in Verbindung stehen, versteckte Funktionen zur Erzeugung von Deepfakes mit sexuell missbräuchlichem Inhalt enthalten. Der Fokus des Berichts liegt auf den verborgenen Fähigkeiten hinter dem Erscheinungsbild gewöhnlicher Produkte und nicht auf missbräuchlichen Verwendungszwecken, die allein anhand des Produktnamens erkennbar sind; die sprachlichen Zusammenhänge sollten zudem nicht als Grundlage für Rückschlüsse auf die Nationalität der Entwickler herangezogen werden.
Die vorliegende Zusammenfassung der Quellen enthält weder eine konkrete Produktliste noch eine vollständige Beschreibung der Untersuchungsmethode oder der Ergebnisse der Plattformüberprüfung, sodass sich noch nicht beurteilen lässt, in welcher Phase der Überprüfung bei den einzelnen Plattformen Mängel aufgetreten sind. Wir sind der Ansicht, dass sich die Produktsicherheitsprüfung nicht auf die öffentliche Beschreibung beschränken darf: Auch Funktionszugänge, Zugriffskontrollen und kontinuierliche Überprüfungen müssen in die Prüfung einbezogen werden; die Tatsache, dass es sich “um ein scheinbar gewöhnliches Tool” handelt, darf nicht als Grundlage dafür herangezogen werden, dass Risiken bereits ausgeschlossen sind.
05
Japan plant eine Anpassung der Zulassungsvorschriften für lenkradlose autonome Fahrzeuge; der Entwurf muss noch diskutiert werden
03.11.2026, 08:29:04 Uhr (Asia/Shanghai)
Laut einem Bericht von Nikkei Asia, den IT-Home weitervermittelt hat, plant Japan, für autonome Fahrzeuge der Stufen L4 und L5, die weder über ein Lenkrad noch über Brems- oder Gaspedale verfügen, von einer Einzelfallprüfung der Sicherheit auf eine Zertifizierung nach einheitlichen Standards umzustellen. Eine dem japanischen Ministerium für Land, Infrastruktur, Verkehr und Tourismus unterstellte Arbeitsgruppe plant, am 4. November 2026 über den Änderungsvorschlag zu beraten; die neuen Standards sollen für Fahrzeuge gelten, die ab Dezember 2026 produziert werden. Bei beiden Punkten handelt es sich um geplante Maßnahmen, die noch nicht als bereits in Kraft getretene Vorschriften betrachtet werden können.
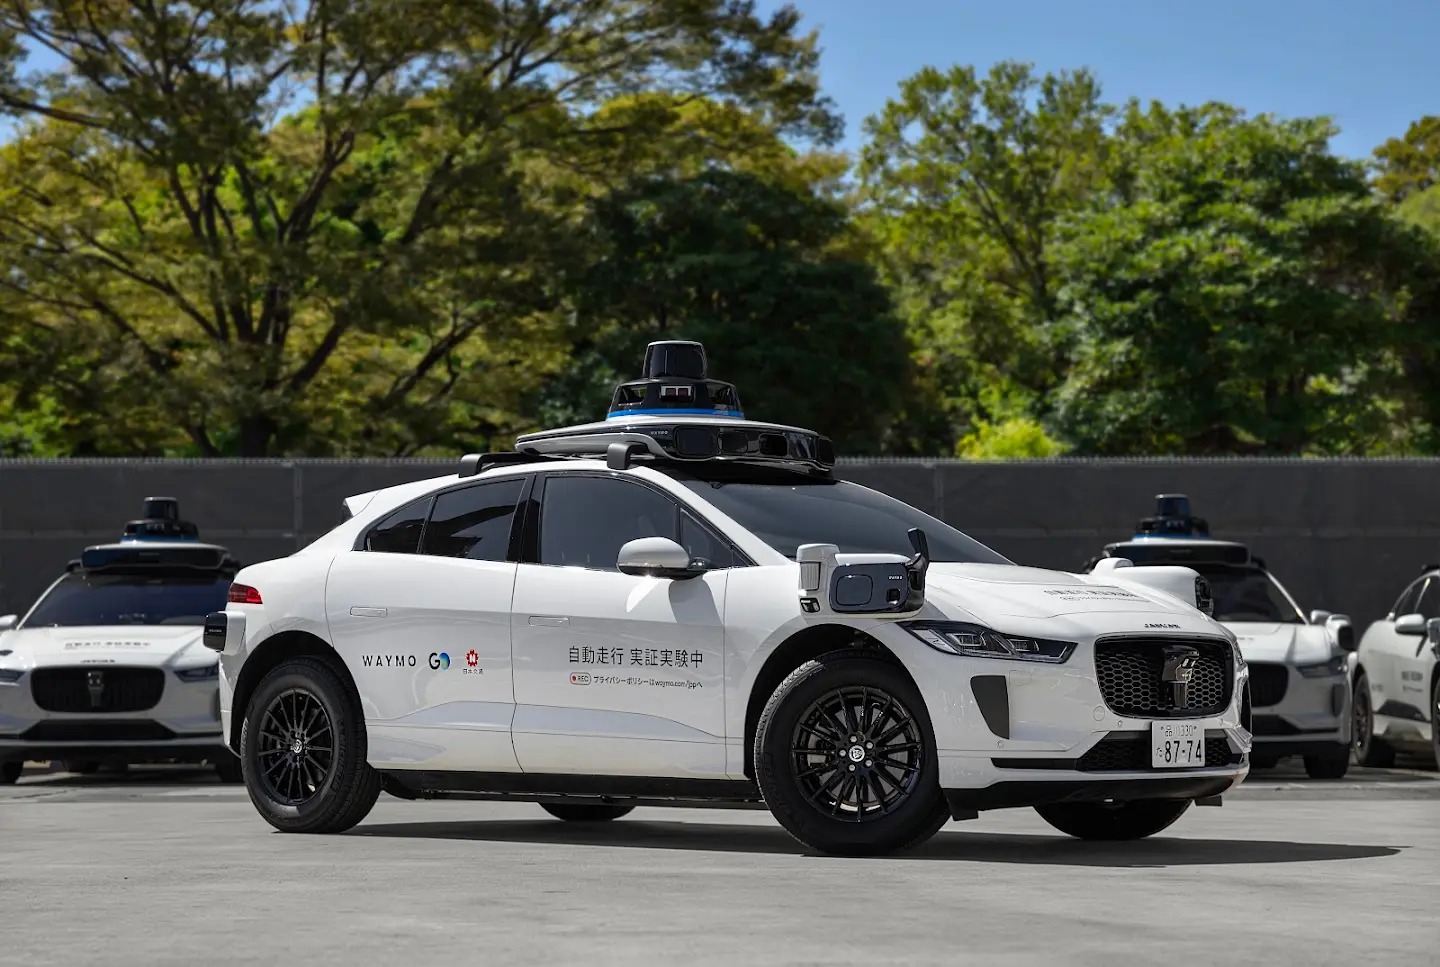
In dem Bericht wird erwähnt, dass Personenkraftwagen bei Crashtests mit Dummys getestet werden müssen, während Nutzfahrzeuge von dieser Prüfung ausgenommen sind; die Hersteller müssen jedoch weiterhin sicherstellen, dass die Fahrzeuge auch bei einem Systemausfall Unfälle vermeiden können. Wir sind der Ansicht, dass die Automobilhersteller vielmehr die Anpassungen der Zertifizierungsanforderungen im Auge behalten sollten, anstatt daraus zu schließen, dass die umfassende Betriebsgenehmigung bereits erteilt wurde; die Tatsache, dass L5 in den Zertifizierungsumfang einbezogen ist, bedeutet zudem nicht, dass die entsprechenden technischen Fähigkeiten bereits nachgewiesen wurden.
06
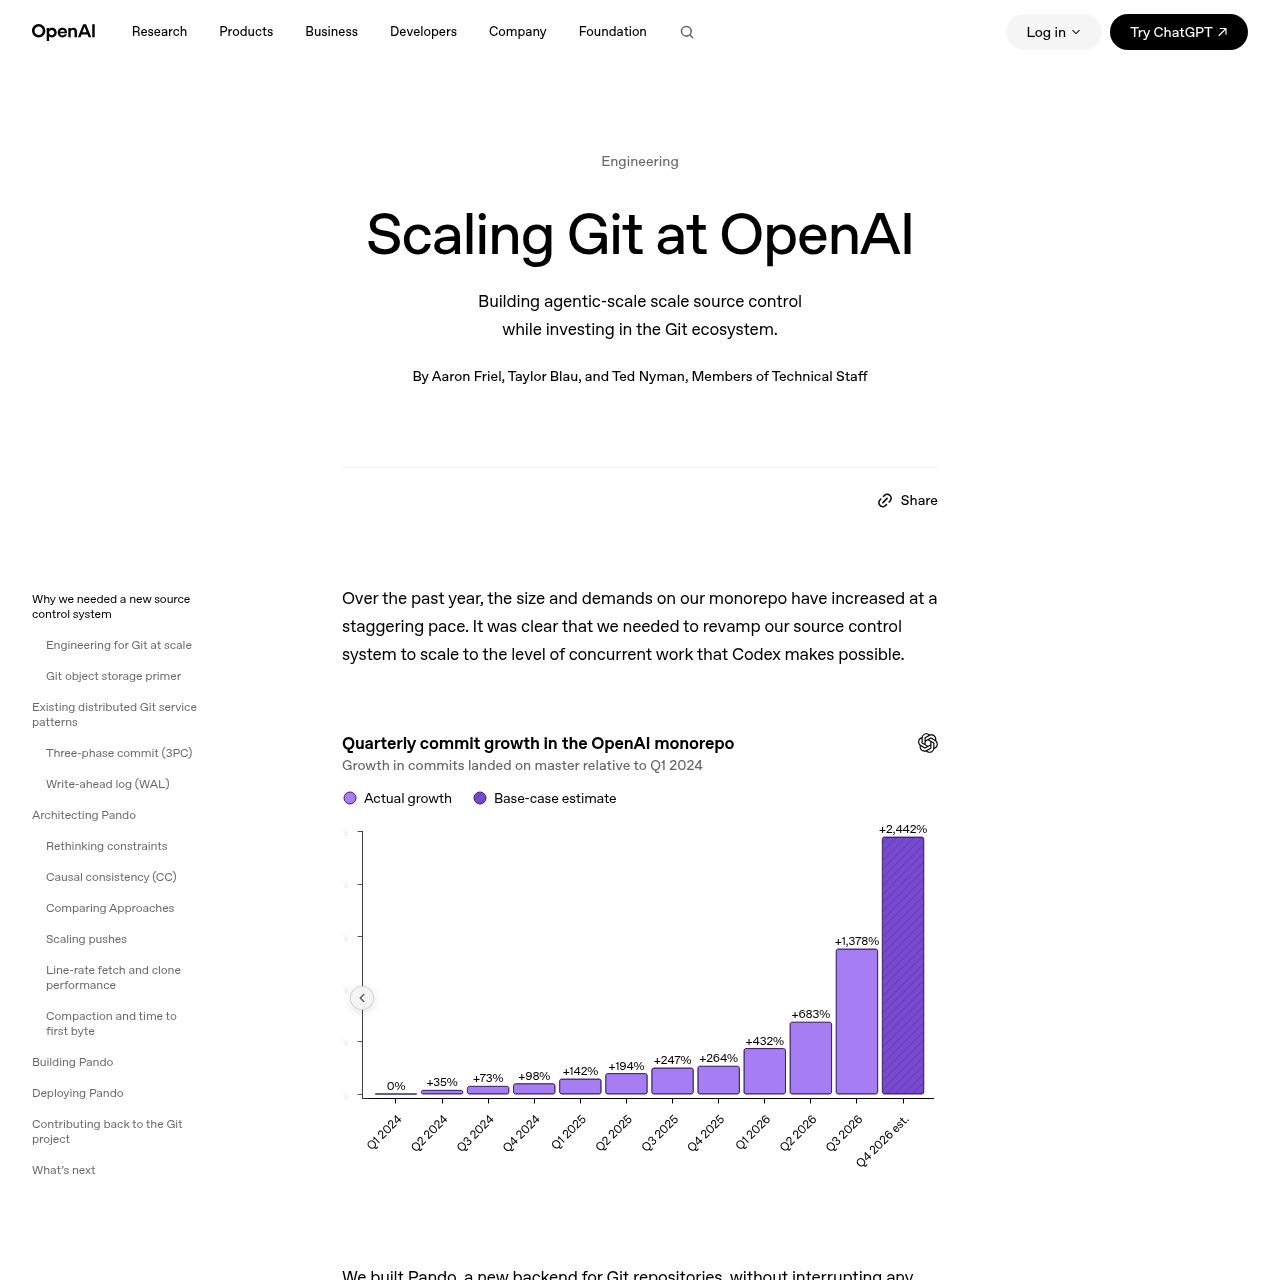
Pando unterstützt die Entwicklung des monolithischen Repositorys von OpenAI – die mediane Push-Verzögerung sank um fast 80 %
03.11.2026, 08:28:59 Uhr (Asia/Shanghai)
OpenAI gab an, dass das Team als Reaktion auf den durch Codex verursachten Druck durch parallele Entwicklung ein neues, mit dem Git-Protokoll kompatibles Backend namens „Pando“ entwickelt habe, das nun die gesamte Entwicklungsarbeit für das Monorepo übernehme. Offiziellen Daten zufolge sank der Medianwert der Push-Verzögerung nach der Umstellung um fast 80 %, und das System kann täglich fast 1 PB an Git-Daten verteilen. Das Ziel war es, die Kapazitäten für gleichzeitige Push-Vorgänge in mehreren Branches und für Lesevorgänge mit hohem Durchsatz zu erhöhen, ohne den bestehenden Git-Workflow der Entwickler zu verändern.
Gemäß den Angaben von OpenAI bietet Pando eine serialisierbare Semantik für Aktualisierungen einzelner Zweige, garantiert jedoch nicht, dass alle Verweise im Repository zu einem bestimmten Zeitpunkt konsistent sind; beim Auslesen mehrerer Zweige können Zustände aus unterschiedlichen Zeitpunkten angezeigt werden. Durch die Wiederverwendung von Packfiles und die unabhängige Annahme von Pushes pro Zweig reduziert es den Koordinationsaufwand und gibt einen Teil der Verbesserungen an das Upstream-Git zurück.
Wir kommen zu folgendem Schluss: Dies hat technischen Referenzwert für Szenarien mit „intensivem Push-Verkehr durch intelligente Agenten“, doch die im Artikel genannten Zahlen zu Latenz und Durchsatz stammen aus OpenAI’s eigener Single-Instance-Repository-Umgebung und lassen sich nicht direkt auf allgemeine Beschleunigungsverhältnisse für Repositorys beliebiger Größe übertragen. Ob eine ähnliche Architektur eingeführt wird, hängt weiterhin vom Umfang des gleichzeitigen Push-Verkehrs, den Anforderungen an die Konsistenz sowie den Betriebs- und Wartungskosten ab.
07
Kimi demonstrierte, wie man 20 Stunden am Stück arbeitet und ein natives Spielprojekt fertigstellt.
03.11.2026, 08:17:09 Uhr (Asia/Shanghai)
Am 2. November veröffentlichte „Die dunkle Seite des Mondes – Kimi“ die „Lösung für Spieleentwicklung und kreative Arbeit“, die Kimi K3.1 Pro, Kimi Code und Kimi Work sowie Plugins für Unity, Unreal Engine, Blender und andere zu einer Kette verknüpft und den gesamten Prozess von Spielprototypen über technische Anpassungen und grafische Überprüfungen bis hin zur Unterstützung bei der Veröffentlichung und dem Betrieb abdeckt. Laut offiziellen Angaben lassen sich vor Projektbeginn mit Engines wie Godot innerhalb von 1–2 Tagen spielbare Prototypen erstellen, die nach dem Ausprobieren und der Auswertung von Screenshot-Feedback weiter überarbeitet werden können.
In einer gemeinsamen Demonstration mit Unity China und dem Tuanjie Codely Agent erklärte Kimi, dass das System ohne menschliches Eingreifen 20 Stunden lang ununterbrochen arbeite, das Originalprojekt reproduziere und ein natives Projekt liefere, das weiterentwickelt werden könne; In der offiziellen Entwicklungsphase werden die Anforderungen anhand von Modellen erfasst und Code generiert, während der Agent innerhalb der Engine Szenen- und Projektänderungen ausführt und verifiziert. Diese Angaben zu Dauer und Lieferumfang stammen derzeit hauptsächlich aus offiziellen Präsentationen; es liegen noch keine veröffentlichten Vergleichstests von Dritten vor.
Wir sind zu folgendem Schluss gekommen: Wichtiger als das bloße Streben nach der in der Demonstration genannten Zahl von 20 Stunden ist die Frage, ob sich das „Modell + der in der Engine integrierte Agent“ in die bestehenden technischen Berechtigungs- und Abnahmeprozesse einbinden lässt. Wenn ein Studio einen Pilotversuch durchführt, sollte es zunächst eine einzelne Aufgabe mit klar definierten Grenzen und überprüfbaren Ergebnissen auswählen und die manuelle Überprüfung von Spielablauf, Leistung und urheberrechtlich geschütztem Material beibehalten. Quelle siehe Offizielle Erklärung von Kimi.
08
Goldman Sachs schränkt den Zugriff auf KI-Programmierwerkzeuge ein – nur Ingenieure behalten Zugriff
03.11.2026, 08:28:59 Uhr (Asia/Shanghai)
Laut einem Bericht von Bloomberg, der von „The Decoder“ wiedergegeben wurde, hat Goldman Sachs gemäß internen Richtlinien vom Oktober den Zugriff auf fortschrittliche KI-Programmierwerkzeuge wie Claude Code und GitHub wieder auf Ingenieure beschränkt; die zuvor von Händlern und Bankern zur Überwachung von Handelsströmen und zur Erstellung von Inhalten genutzten Funktionen wurden eingeschränkt, was intern zu Unzufriedenheit geführt hat.
Dies steht im Gegensatz zu der öffentlichen Äußerung des Chief Information Officers des Unternehmens vom Juli gegenüber nicht-technischen Mitarbeitern, wonach „zunächst mit KI Prototypen erstellt und diese dann an die Ingenieure zur Weiterentwicklung übergeben werden“ sollen. Ein Sprecher verwies lediglich allgemein auf Faktoren wie Produktivität und Risikomanagement und erklärte, dass die Testphase beendet sei und die Tools denjenigen überlassen würden, „die für den langfristigen Einsatz am besten geeignet sind“. Der Bericht enthält keine Angaben zur Anzahl der Personen, denen die Zugriffsrechte entzogen wurden, keine konkrete Liste der Tools und keine Details zu den Risikovorfällen.
Unsere Einschätzung lautet: Dies sollte eher als Rückbesinnung einer Organisation auf die Rollenzuweisung verstanden werden und nicht als branchenweite Schlussfolgerung, dass „die KI-Programmierung insgesamt an Bedeutung verliert“. Die praktische Erkenntnis für Unternehmen lautet: Die Berechtigungen für Prototypenentwicklung in nicht-technischen Positionen, die Weitergabe von Daten außerhalb des Unternehmens sowie die Genehmigung von Änderungen in der Produktion müssen in den Richtlinien festgeschrieben werden und dürfen nicht nur als bloße Ermutigung in Form von Slogans bleiben.
09
Bei Anthropic gehen Umsatzwachstum und steigende Verluste Hand in Hand
03.11.2026, 08:29:05 Uhr (Asia/Shanghai)
Laut Berichten von Bloomberg und The Information, die von The Decoder zusammengefasst wurden, belief sich der Quartalsumsatz von Anthropic auf fast 17 Milliarden US-Dollar, was etwa dem Zwölffachen des Vorjahreswerts entspricht; die Betriebskosten lagen jedoch bei rund 17,5 Milliarden US-Dollar, und der Nettoverlust betrug etwa 23,3 Milliarden US-Dollar, was über dem Verlustniveau des Vorjahreszeitraums von rund 12,1 Milliarden US-Dollar liegt. Das Unternehmen führt den Kostenanstieg hauptsächlich auf eine kurzfristige Rechenleistungsverpflichtung in Höhe von rund 5 Milliarden US-Dollar sowie auf Mitarbeiter-Spenden und entsprechende Unternehmenszuschüsse in Höhe von rund 2 Milliarden US-Dollar zurück.
In dem Bericht wird zudem auf die enorme Rechenleistung und das Ausmaß der Mietverpflichtungen für Rechenzentren hingewiesen, die im Zusammenhang mit den Erwartungen hinsichtlich einer bevorstehenden groß angelegten Kapitalbeschaffung durch einen Börsengang genannt werden. Die Angaben verschiedener Medien zu Umsatz, Betriebskosten und Nettoverlust stimmen nicht vollständig überein, und die derzeit öffentlich zugänglichen Informationen reichen nicht aus, um ein vollständiges Bild der Finanzlage zu vermitteln.
Wir kommen zu folgendem Schluss: Ein sprunghafter Umsatzanstieg und eine Ausweitung der Verluste können gleichzeitig auftreten. Entscheidend ist, das „Umsatzwachstum“ und den „Druck auf Cashflow und Gewinn durch die zugesagte Rechenleistung“ getrennt zu betrachten und zu vermeiden, die Gesundheit eines Modellunternehmens anhand einer einzigen Gewinnkennzahl zu beurteilen. Solange die Originalunterlagen und die Prüfungsgrundlagen nicht veröffentlicht sind, sollten aus zweiter Hand stammende Zahlen nicht als Grundlage für Investitionsentscheidungen herangezogen werden.
10
Bei Tests mit HomeView OS wurde kein App Store gefunden; die App-Funktionalität basiert auf CarPlay
03.11.2026, 08:28:59 Uhr (Asia/Shanghai)
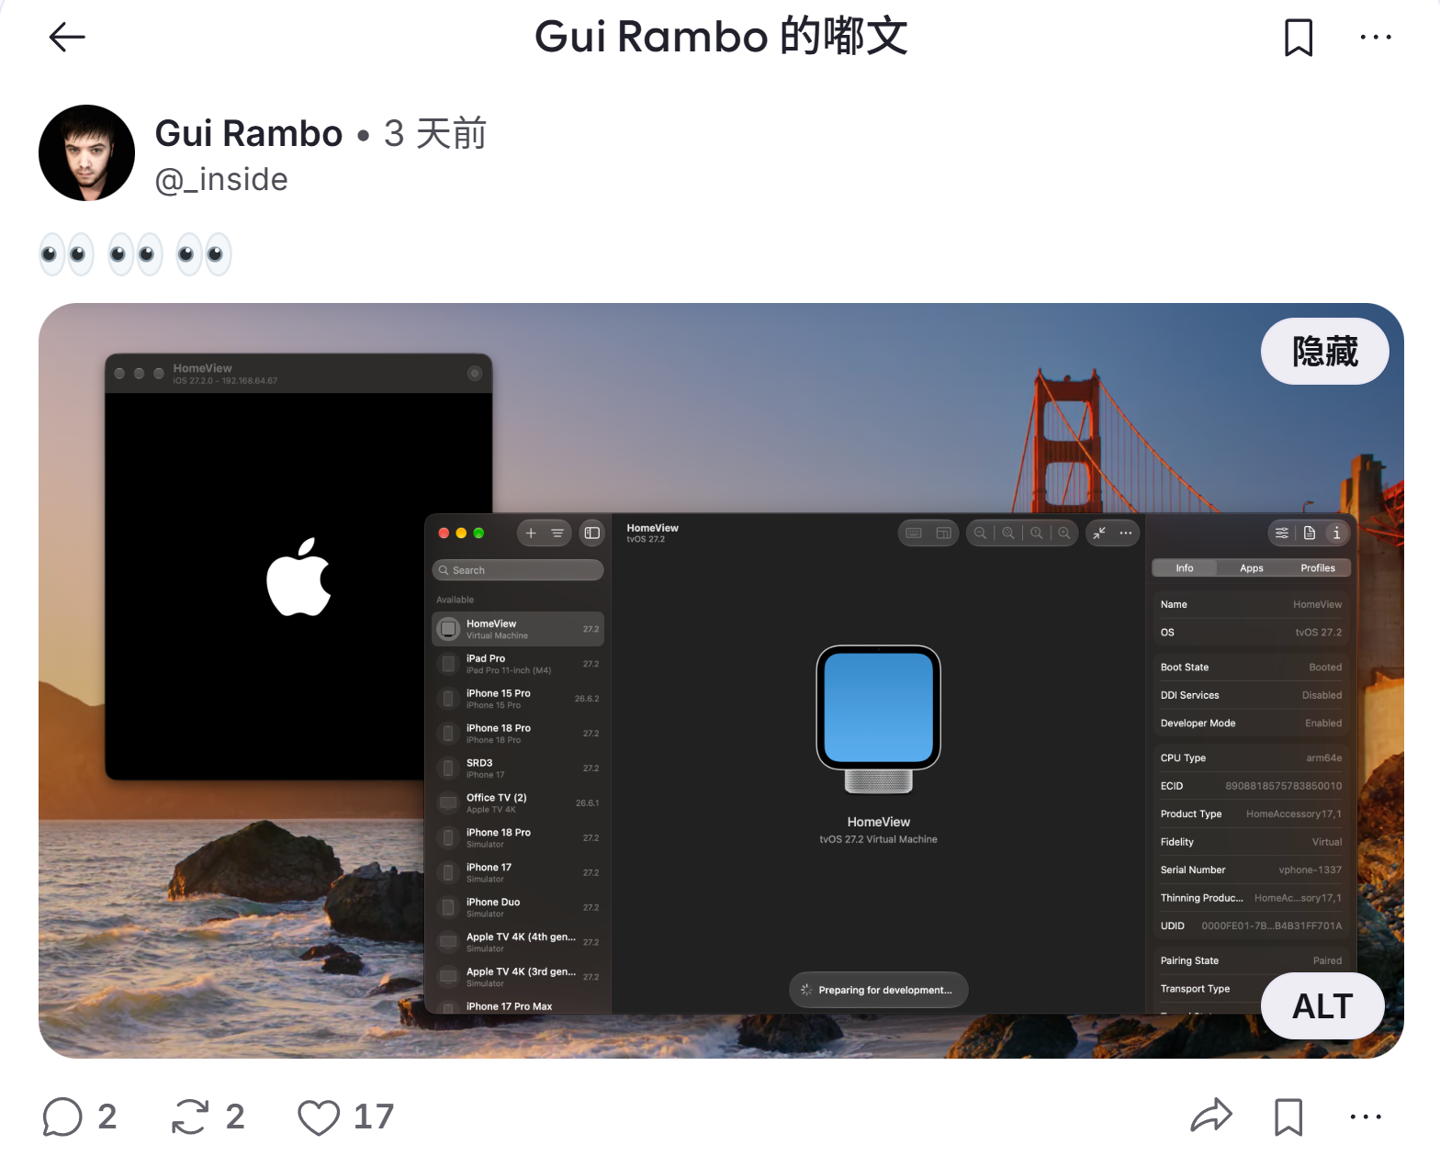
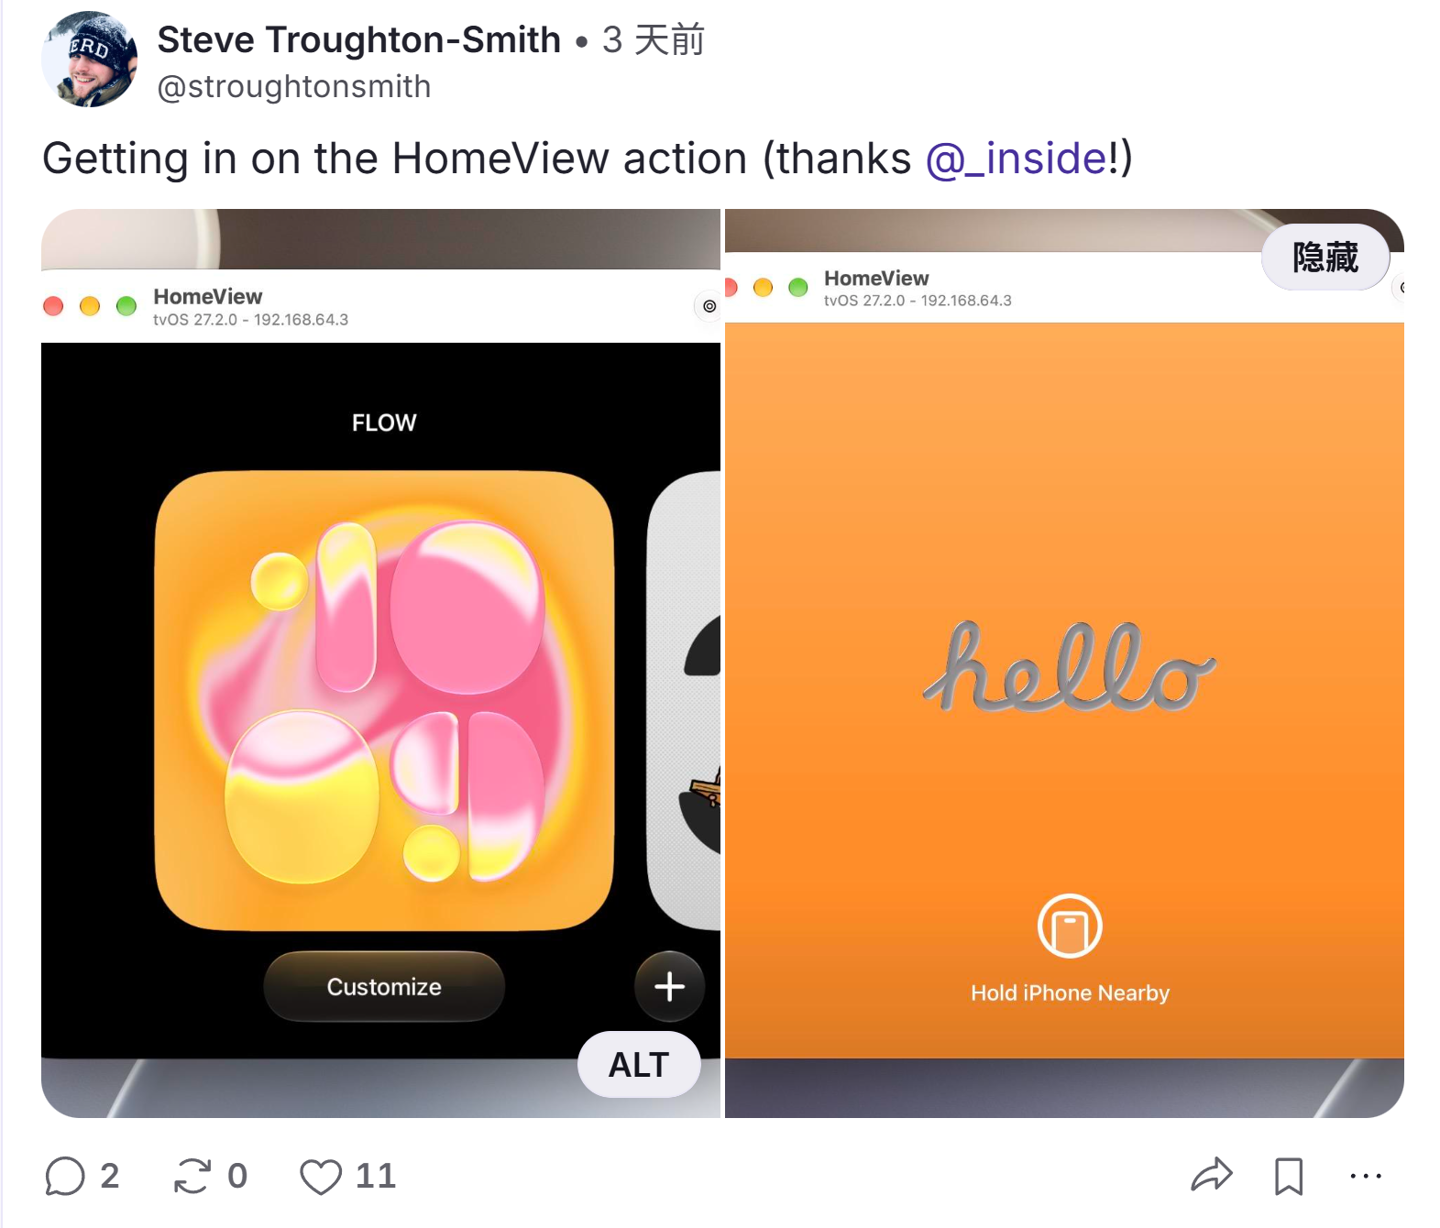
Laut einem Bericht von AppleInsider, den IT-Home weitervermittelt hat, haben Entwickler beim Testen des Betriebssystems von HomeView, der Smart-Home-Zentrale von Apple, festgestellt, dass derzeit kein App Store vorhanden ist und Nutzer keine Apps von Drittanbietern selbst installieren dürfen, wodurch der Grad der Offenheit deutlich geringer ist als bei Geräten wie dem iPhone oder dem iPad.
Den Testbeobachtungen zufolge scheint der derzeitige Betriebsmechanismus der Anwendungen in großem Umfang auf die CarPlay-API zurückzugreifen, wobei der Schwerpunkt bislang eher auf Audio- und Videoanwendungen liegt; Funktionen zur Anpassung der Benutzeroberfläche, wie beispielsweise „Liquid Glass“, wurden zwar erwähnt, befinden sich jedoch noch im Teststadium. Ob diese Funktionen kommerziell genutzt werden können und wann die Bereitstellung durch Drittanbieter freigegeben wird, geht aus den bisherigen Berichten nicht hervor.
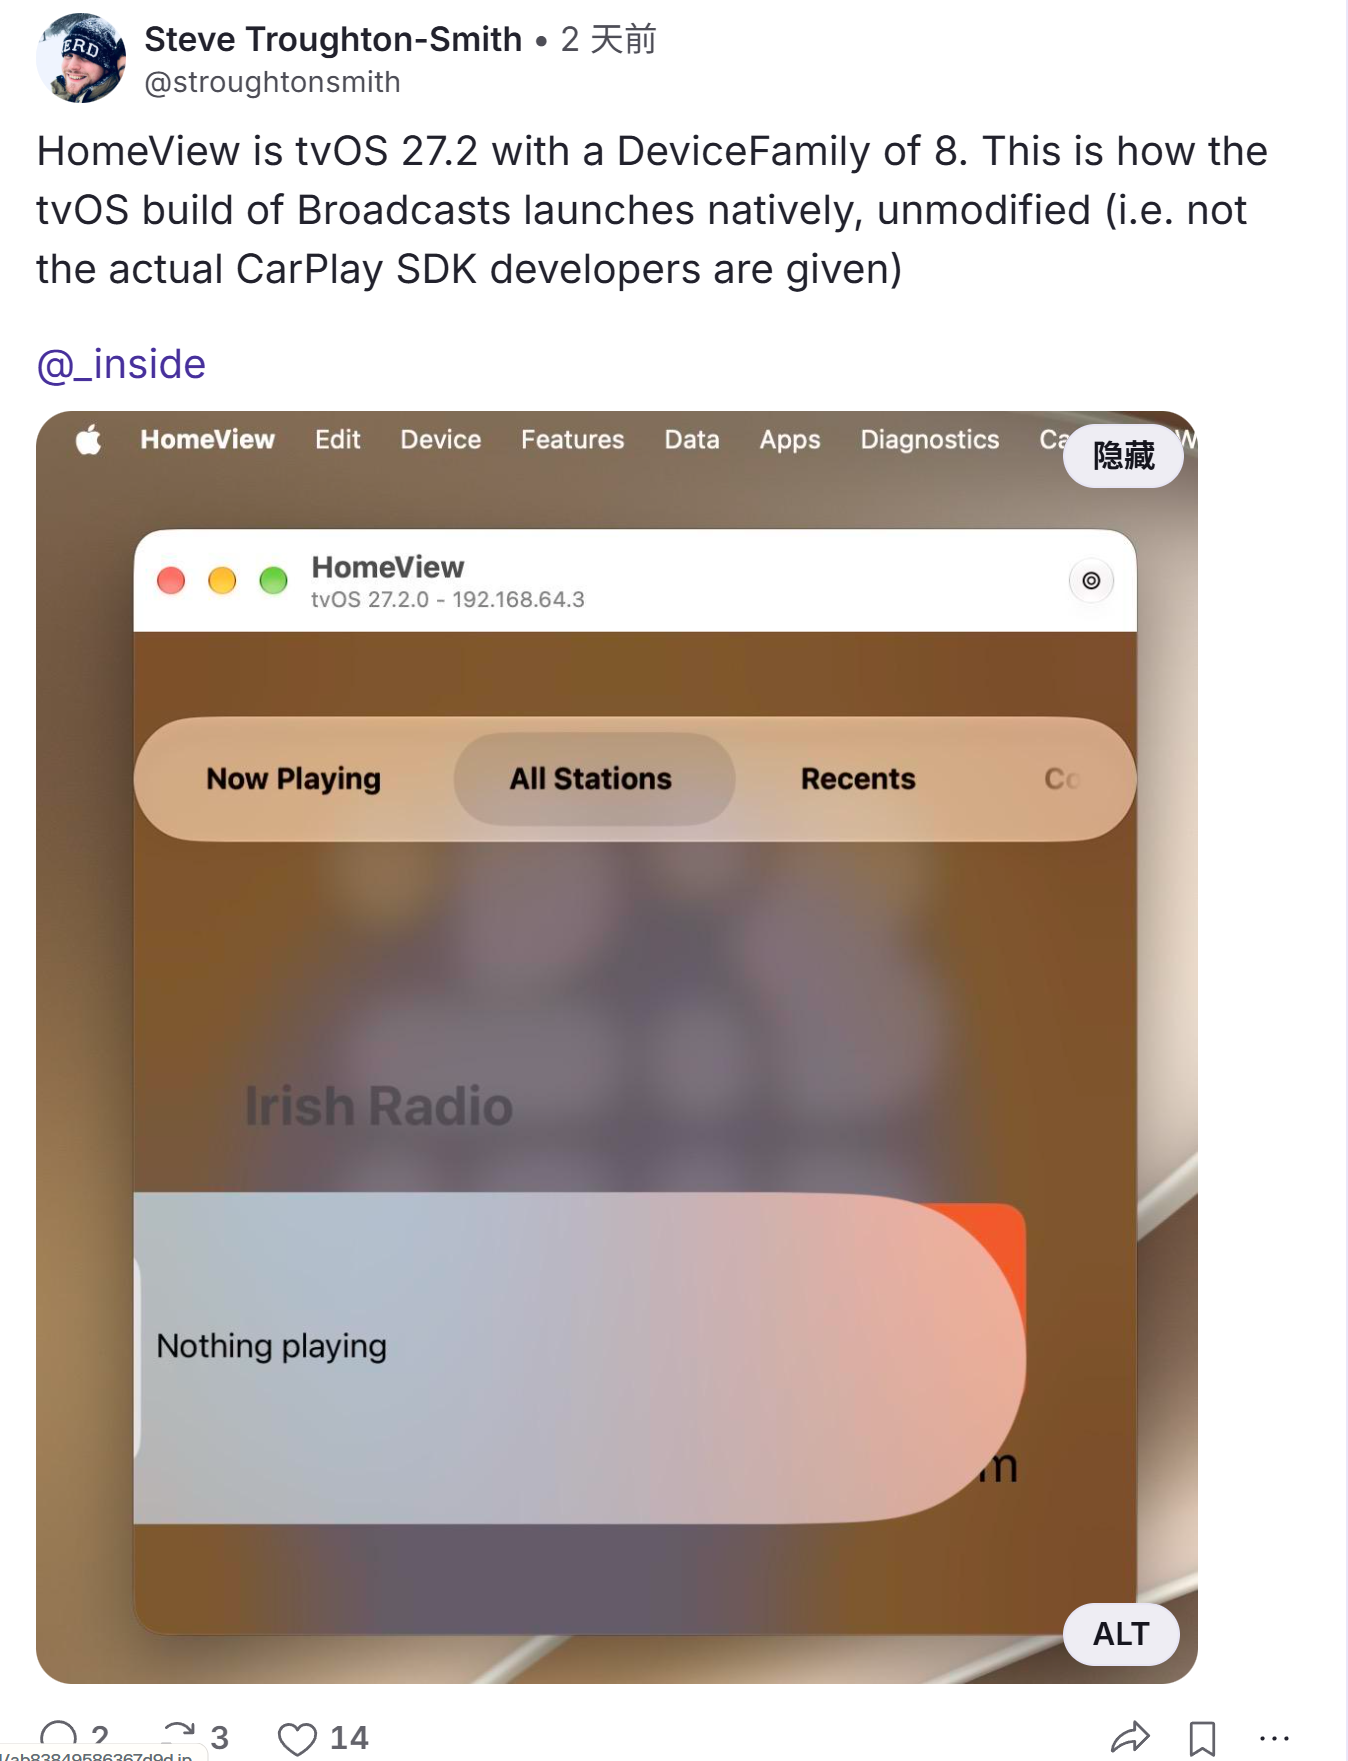
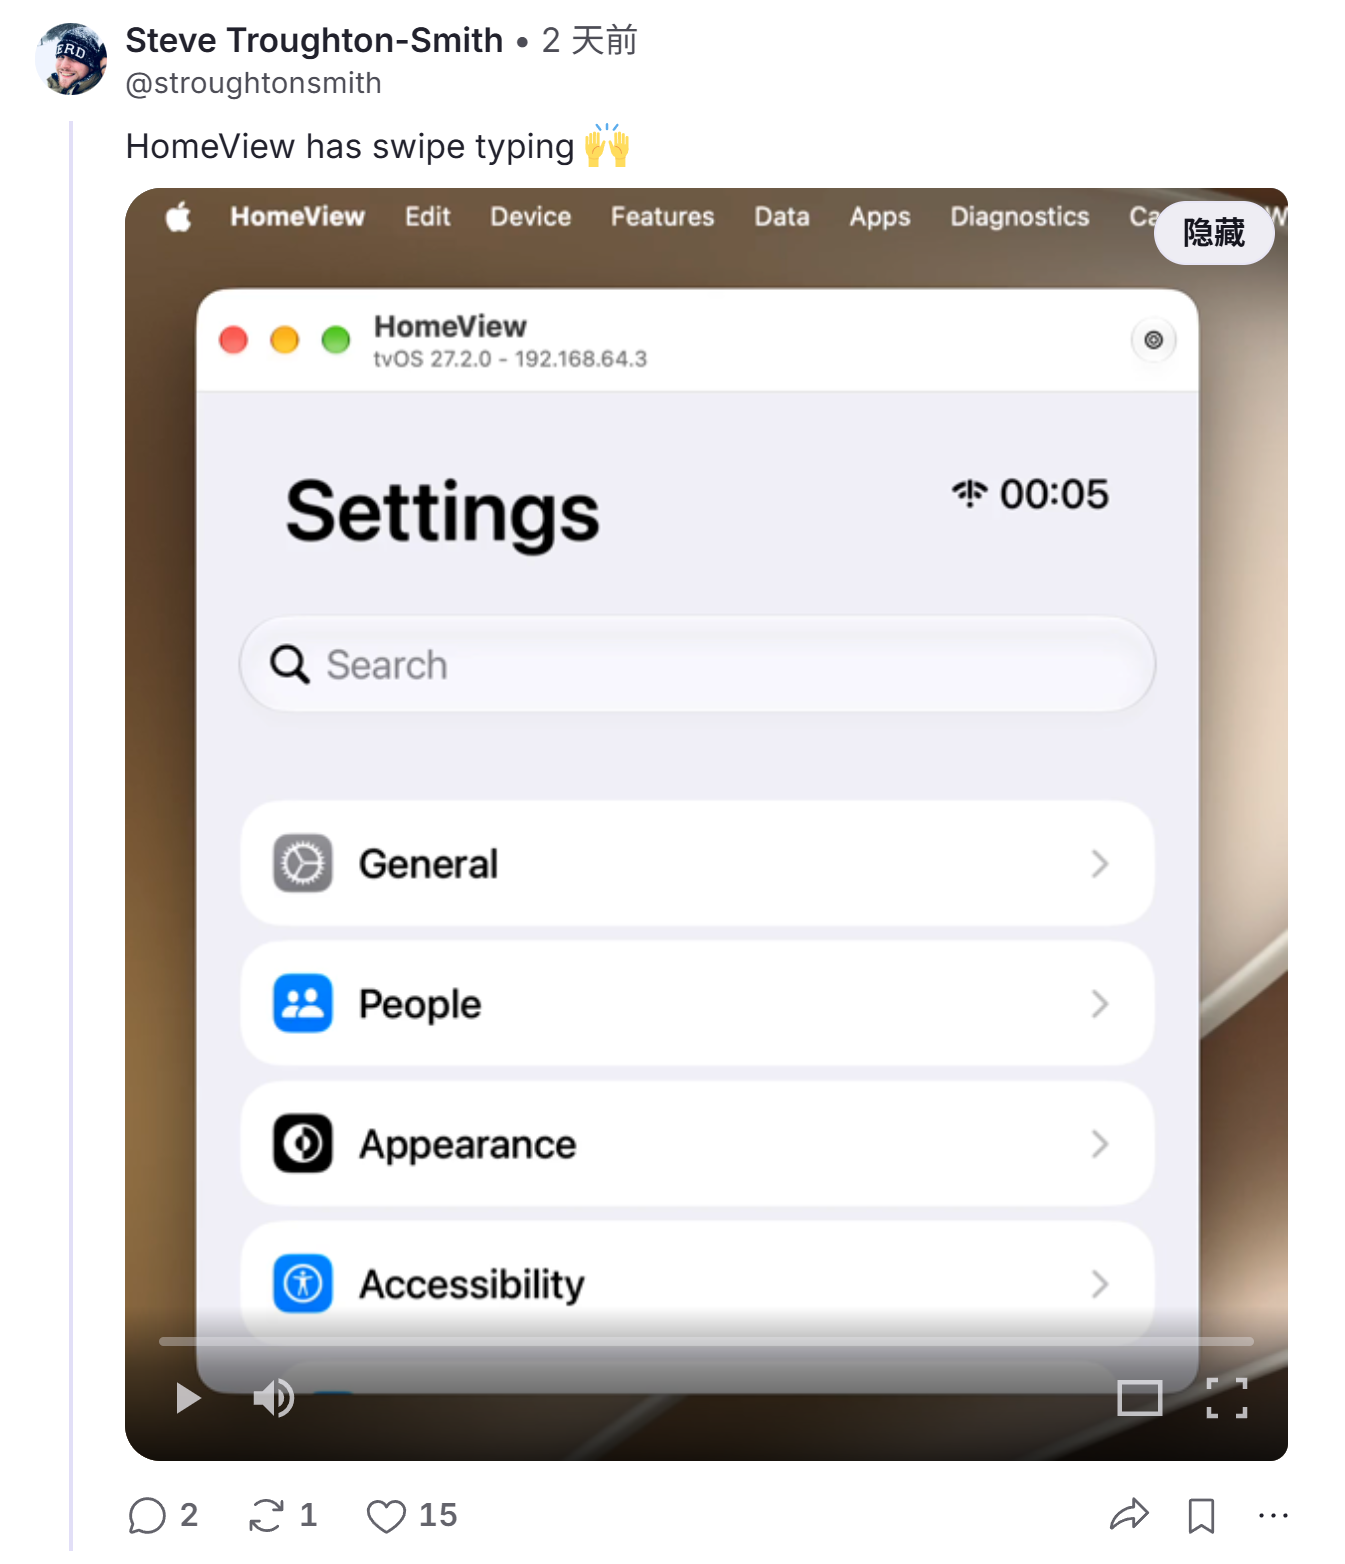
Wir sind zu folgendem Schluss gekommen: Es sollte zwischen den drei Ebenen „Testfunktion für bestimmte Anwendungen“, „vollständige Anwendungsfähigkeit“ und „vorhandene offizielle Vertriebskanäle“ unterschieden werden, um zu vermeiden, dass die Erkundungen der Entwickler fälschlicherweise als feststehende Produktrichtlinien dargestellt werden. Die Auswirkungen einer langfristigen Abschottung der Smart-Home-Zentrale auf Drittentwickler lassen sich erst nach Veröffentlichung der offiziellen Dokumentation und der Quotenregelungen beurteilen.




评论列表 (0条):
加载更多评论 Laden...