


DEEP DIVE / 2026.11.16
思考档位该不该默认开到最高?结论先说:不要把每条请求都开到 xhigh 或 max。
官方把「要不要思考」和「花多少力气」分成两套控制。要压成本或延迟,先降 effort;要硬封顶,用 max_tokens 或 max_output_tokens。本文是官方资料解读,核验日 2026 年 11 月 16 日,未在本机发请求验证。
effort 是软指引,硬上限是输出 token 上限。旧的
budget_tokens不能直接贴到会返回 400 的新模型上。
先分清 thinking 和 effort
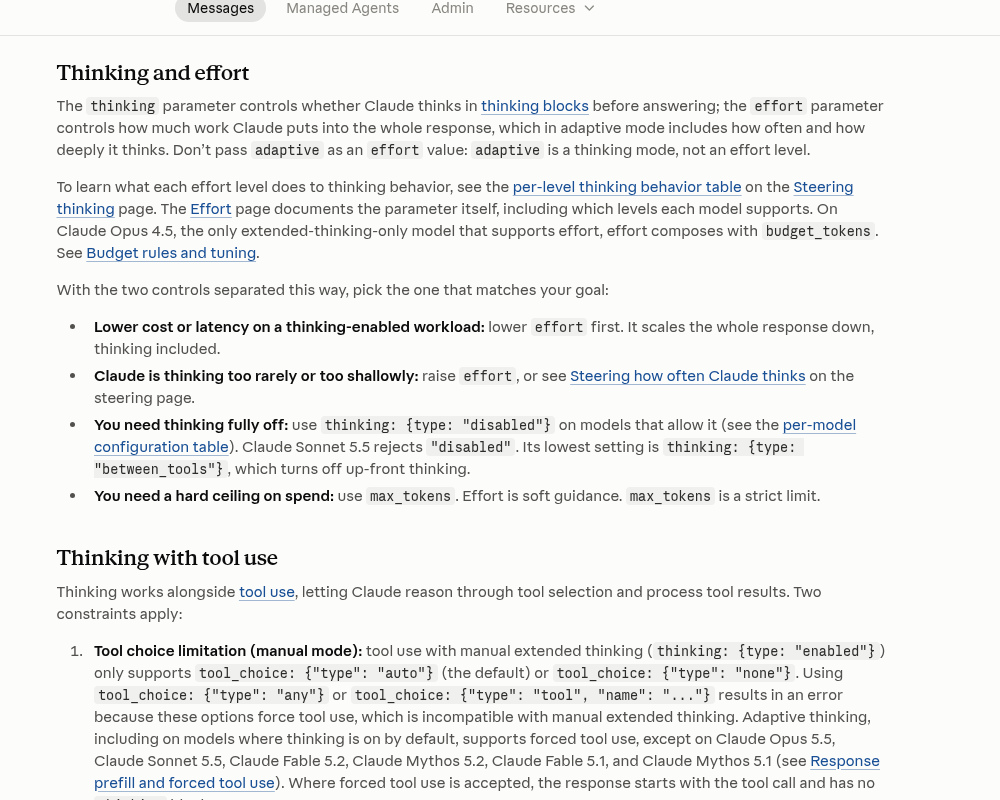
Anthropic 的 Thinking 文档写明:thinking 控制模型会不会在回答前写出 thinking 块;effort 控制整段回复花多少力气,自适应模式下也包括想得有多勤、有多深。
不要把 adaptive 当成一个 effort 档位。它是思考模式,不是力度等级。力度应写在 output_config.effort 里。
在多数 Claude 5 及之后的型号上,思考默认已打开,采用自适应模式。省略 thinking 字段,往往就是自适应思考,不必再额外「打开」一次。
OpenAI 的 Reasoning models 指南用 reasoning.effort 提示模型这次要想多少。支持的取值因模型而异,文档列出 none、minimal、low、medium、high、xhigh 和 max。
同一页写:较低档偏向速度和更少 token,较高档会想得更完整;模型也会按任务难度自适应,简单题少想、复杂题多想。具体哪个取值可用,要先看对应模型页。
GPT-6 Astra 不支持 none,写成 none 会返回 HTTP 400。GPT-6.1 Sol 不支持 none 或 minimal,默认是 medium。文档还写,gpt-5.5 的默认是 medium。同一页也写,若省略 reasoning.effort,GPT-5.6 在两种 mode 下默认都是 medium,GPT-6 Sol 和 GPT-6 Luna 默认同样是 medium。
默认不要开到最高档
Anthropic 的 Effort 文档把 effort 写成行为信号,而不是严格的 token 预算。多数型号默认 high;Claude Opus 5.5 和 Claude Haiku 5.5 默认 medium。
对 Claude Fable 5.2,官方建议从 high 起步:能力上的大部分收益在 high 已经出现,再往上的增益不均,且取决于任务。只有测到收益,再升到 xhigh。
同一节把 max 留给测模型上限,或「时间和 token 都不计较」的少见任务。它写明:在 max 上模型会不顾 token 成本冲能力,往往比 xhigh 更慢、更贵,却常常只有很小的增益。
对 Claude Sonnet 5.5,官方建议:若不是智能体或对延迟敏感,从 high 开始;智能体编码和多步工具调用,任务明确时可从 medium 起步,更难或更长再升到 high;聊天等对延迟敏感的场景,从 medium 或 low 开始。xhigh 或 max 只在评测证明有质量收益时再用。
OpenAI 指南把 medium 写成多数工作负载的均衡起点,并给了分档用途:none 留给几乎不需要推理或多步工具的低延迟任务;low 适合还要规划、搜索或工具调用、但又要控速度和成本的场景;high 留给硬推理和更看重质量的任务。
对 xhigh,该页写:只在评测证明额外延迟和成本说得过去时再用。对 max,它建议:若你已经在用 xhigh,再评估 max 是否明显更强,而不是直接设成默认。
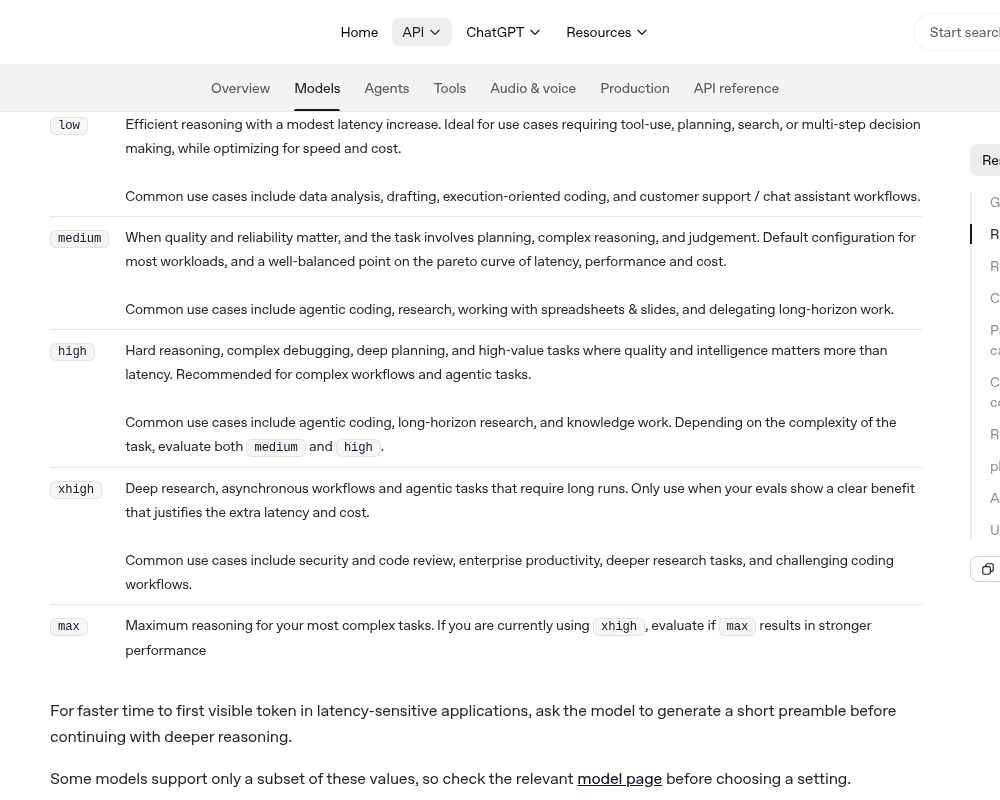
OpenAI 在 GPT-5.5 的说明里还写:更高的推理力度并不自动更好。任务指令冲突、停止条件含糊,或工具访问过宽时,加档可能导致想得过久、多余搜索,甚至质量回退。只有评测显示出可衡量的收益,再升高。
同一家的提示建议也把 reasoning.effort 写成调节旋钮,而不是挽回质量的首要手段。先把目标、约束和输出约定写清楚,再调档位。
要封顶花费,请用 max_tokens
Anthropic 在 Thinking 页把两套控制的用法写得很干脆:要降低已开启思考的工作负载的成本或延迟,先降 effort;模型想得太少或太浅,再升高 effort;需要完全关掉思考时,只在该型号允许的前提下使用 thinking: {type: "disabled"}。
若需要硬性花费上限,用 max_tokens。官方原句是:Effort 是软指引,max_tokens 才是严格限制。
思考 token 会计入 max_tokens,并按输出 token 计费。即便把 display 设成 omitted、界面上看不到思考正文,费用也不会因此减少;它主要缩短流式时等到首个可见文本的时间。
Claude Sonnet 5.5 拒绝 disabled,其最低设置是 between_tools,只关闭开场思考,且只在 high 及以下档位接受;到 xhigh 或 max 会返回 400。Claude Opus 5.5 等型号则完全不能关闭思考。
OpenAI 用 max_output_tokens 限制生成总量,其中包含推理 token、可见输出和不可见的格式 token。若打到这个上限或上下文窗口上限,响应可能是 incomplete,原因是 max_output_tokens。
官方提醒:这种情况可能发生在任何可见文本出现之前。也就是说,你可能已经为输入和推理付了费,却拿不到可见答复。起步试验时,OpenAI 建议至少为推理和输出预留 25,000 个 token,再按实际用量收紧。
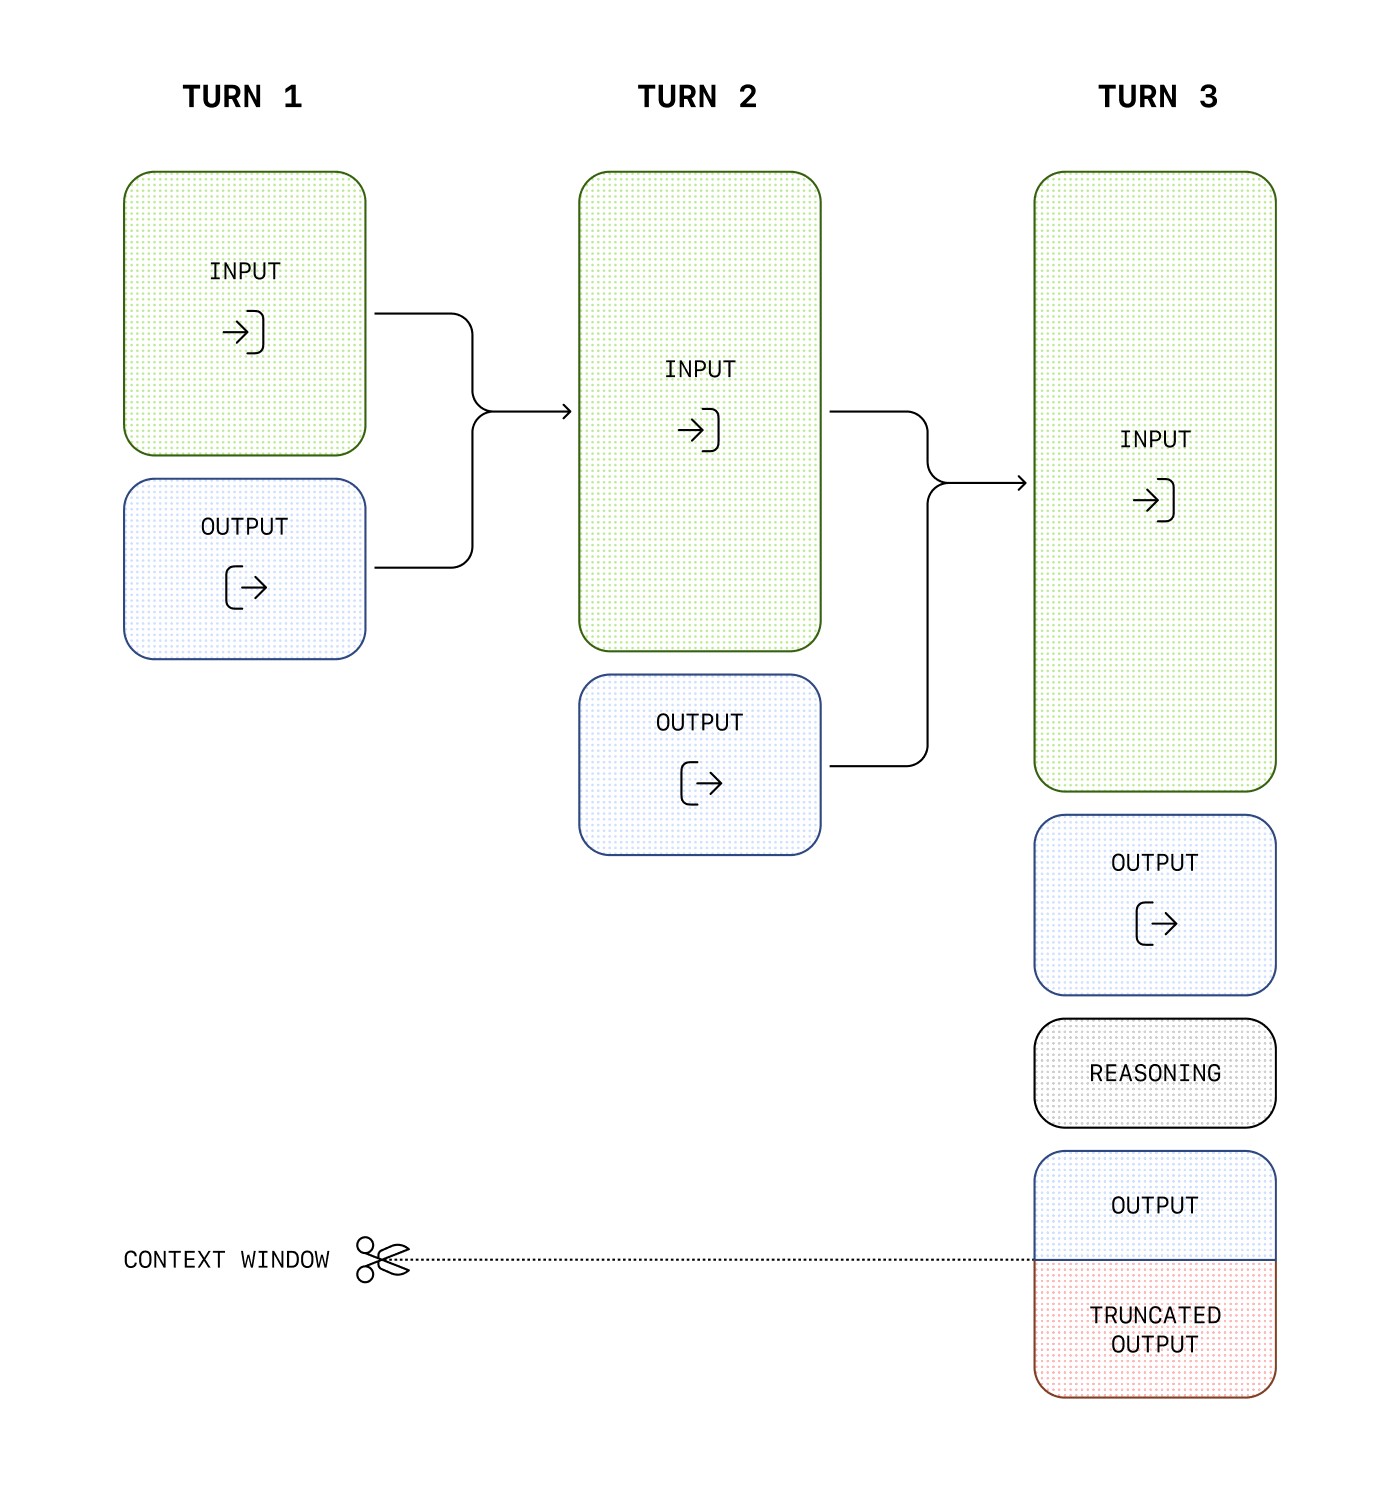
因此,把 effort 调低,和把输出上限设紧,不是同一件事。前者是在建议模型少花力气,后者才是请求级的硬封顶。两者可以一起用,但不能互相替代。
旧的 budget_tokens 不能直接套用
Anthropic 把带 budget_tokens 的 thinking.type: "enabled" 称为扩展思考,并标成旧模式。Thinking 页的型号表写明:在 Claude 4.7、Claude 4.8 以及 Claude 5 及之后的型号上,这种写法会返回 400;Claude Opus 4.6 和 Claude Sonnet 4.6 上已标成弃用,请求目前仍可能成功。同一张表里,Claude Mythos Preview 仍接受扩展思考,不能把它算进「一律 400」的范围。
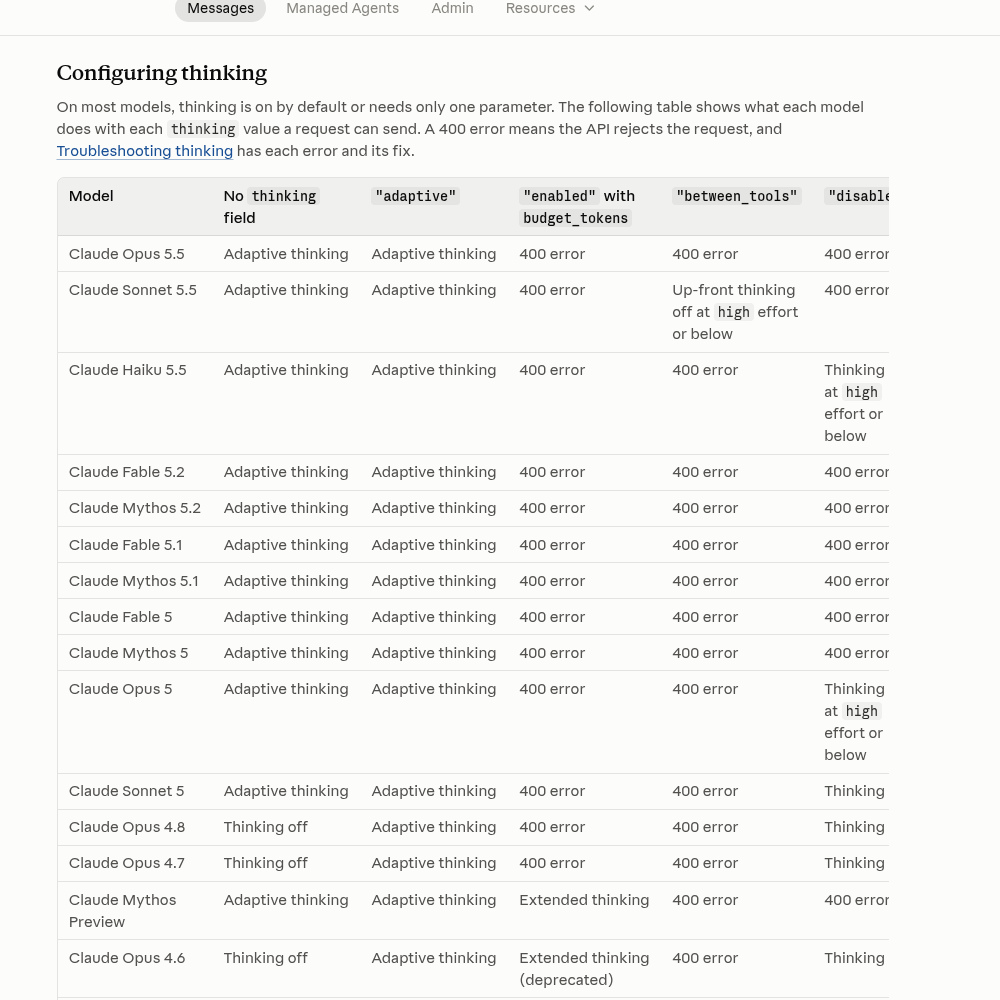
只支持扩展思考的旧型号,例如 Claude Opus 4.5、Claude Sonnet 4.5 和 Claude Haiku 4.5,仍要用 type: "enabled" 加 budget_tokens;对它们发送 adaptive 反而会 400。
扩展思考文档还写:budget_tokens 最小为 1,024,且一般必须小于 max_tokens。预算是目标而不是硬顶,模型可能提前结束思考;硬顶仍是 max_tokens。
若代码库里还留着旧示例,先按当前型号查官方对照表,再决定是改成自适应思考加 effort,还是继续留在旧模式。不要把同一段配置复制到所有型号上。
Anthropic 的 Managed Agents 另有一条边界:思考配置由托管层设置,Agent 定义里没有 thinking 字段。那条路径不能用本文的请求级开关去套。
适用边界和与旧文的分工
本文判断适用于:你在生产或预发里配置思考或推理档位,并需要在质量、延迟和账单之间做默认策略。核验依据是 11 月 16 日仍可访问的官方文档,接口随后可能改,发布前应再对一次当前型号页。
它不适用于:没有思考或推理接口的型号;要把精度数字交给代码执行的场景,见 11 月 9 日的代码执行判断文;以及任务根本不该做成 Agent 循环的情况,见 11 月 12 日的脚本边界文。
要不要换成更便宜的 computer-use 档,见 11 月 3 日的档位切换文;Message Threads 是降延迟还是降账单,见 11 月 5 日的 Threads 文。那是另一类接口,不是思考档位。
会改变判断的条件包括:评测证明升高一档有稳定质量收益;当前型号不再允许关闭思考;或者旧的 budget_tokens 在目标型号上开始返回 400。改变默认档位前,先在固定评测集上做对照,而不是全量改配置。
最小行动可以很小:先查出当前默认型号允许哪些 thinking 和 effort 取值,把生产默认从最高档降到官方建议的起点,并用 max_tokens 或 max_output_tokens 留下足够余量,同时设下一道硬顶。
我们的判断:不要把思考档位默认开满。先用官方建议的中间或默认档,只有评测证明有收益再升高;要硬封顶就设输出上限。旧的 budget_tokens 只留给仍支持它的型号。


评论列表 (0条):
加载更多评论 Loading...