AI DAILY BRIEF
今日 AI 速递
精选趋势、产品更新与工程实践
AI 网站训练偏好正在出现统一信号,但标准仍处于讨论和分阶段落地过程中,网站运营者暂时不能把“支持计划”当成全面生效。与此同时,个人助理、跨会话 Agent、推理基础设施和内容识别工具都在推进,但实际能力仍受权限、时长、参数和验证条件限制。
目录
02
训练、grounding 与搜索展示不是同一个开关
04
DeepSeek 探索跨会话 Agent,已披露实例仍集中于内部研发
05
CPU 出货增长预测背后,是 Agent 的调度负载
06
共情提示改变模型自述,量表得分不代表真实情绪
07
Claude 扩展水印,两款旧模型仍受采样设置限制
08
baoyu-design v2 把设计文件留在项目里,升级需更换 skills
10
StreamVibe 学习何时开口,长视频仍难持续跟踪
01
四家公司支持统一声明,实际落地仍有时间差
2026-11-02 03:06:35 Asia/Shanghai
OpenAI、谷歌、微软和 Anthropic 宣布采用统一的 AI 数据抓取退出标准,网站发布方可以通过一次声明表达内容使用偏好,不必再针对每家公司分别设置训练抓取规则。对内容团队和网站开发者来说,直接变化是规则配置流程有望简化。
这项标准由 Anthropic 技术负责人 Kevin Kelley 向 IETF 提出,计划集成到网站的 robots.txt 文件中,用于表达内容是否允许被用于 AI 模型训练。Anthropic 已采纳,OpenAI 计划在未来几个月落实,谷歌和微软预计于 2027 年支持;Meta 表态支持通用信号,但尚未明确实施计划。对网站团队而言,统一信号的价值取决于各家公司是否按计划执行,当前仍需逐家核对支持进度。
02
训练、grounding 与搜索展示不是同一个开关
2026-11-02 03:06:46 Asia/Shanghai
这项被称为“policy token”的信号由 Kevin Kelley 提议,目前正在 IETF 讨论,载体仍是 robots.txt。它的作用是让网站向多个 AI 爬虫表达内容是否可用于训练,后续关键在于更多 AI 公司是否按同一信号执行。
微软还将提供更细的选项,让网站分别退出模型训练或 AI grounding。谷歌和微软均表示,这类选择不会影响网站出现在搜索结果中。对发布者来说,训练使用、grounding 和搜索展示需要分开理解,统一声明并不等于把所有用途合并成一个开关。
03
灵光能读账单,发消息和付款仍受限
2026-11-01 18:03:12 Asia/Shanghai
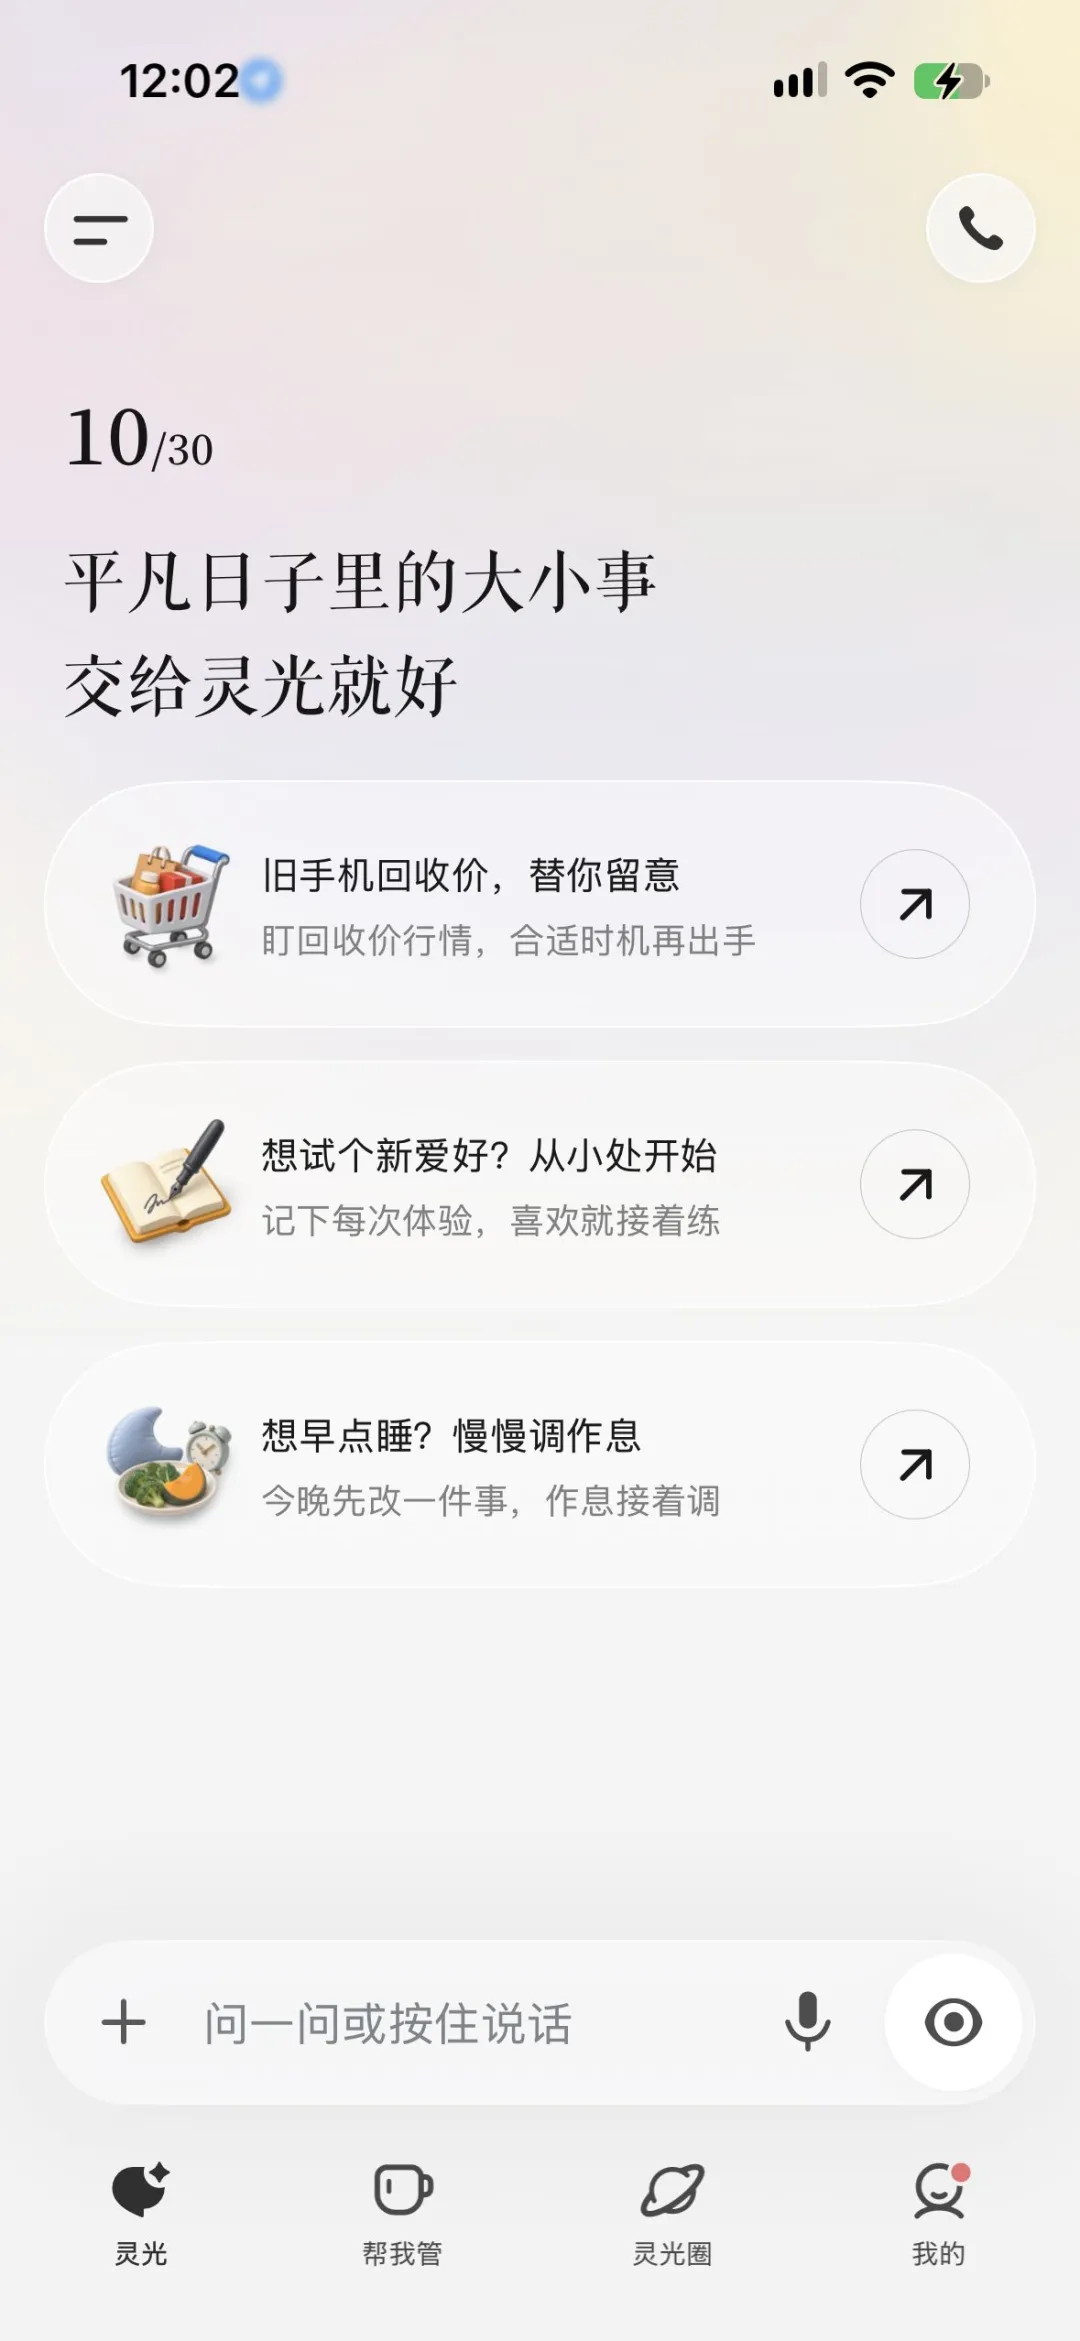
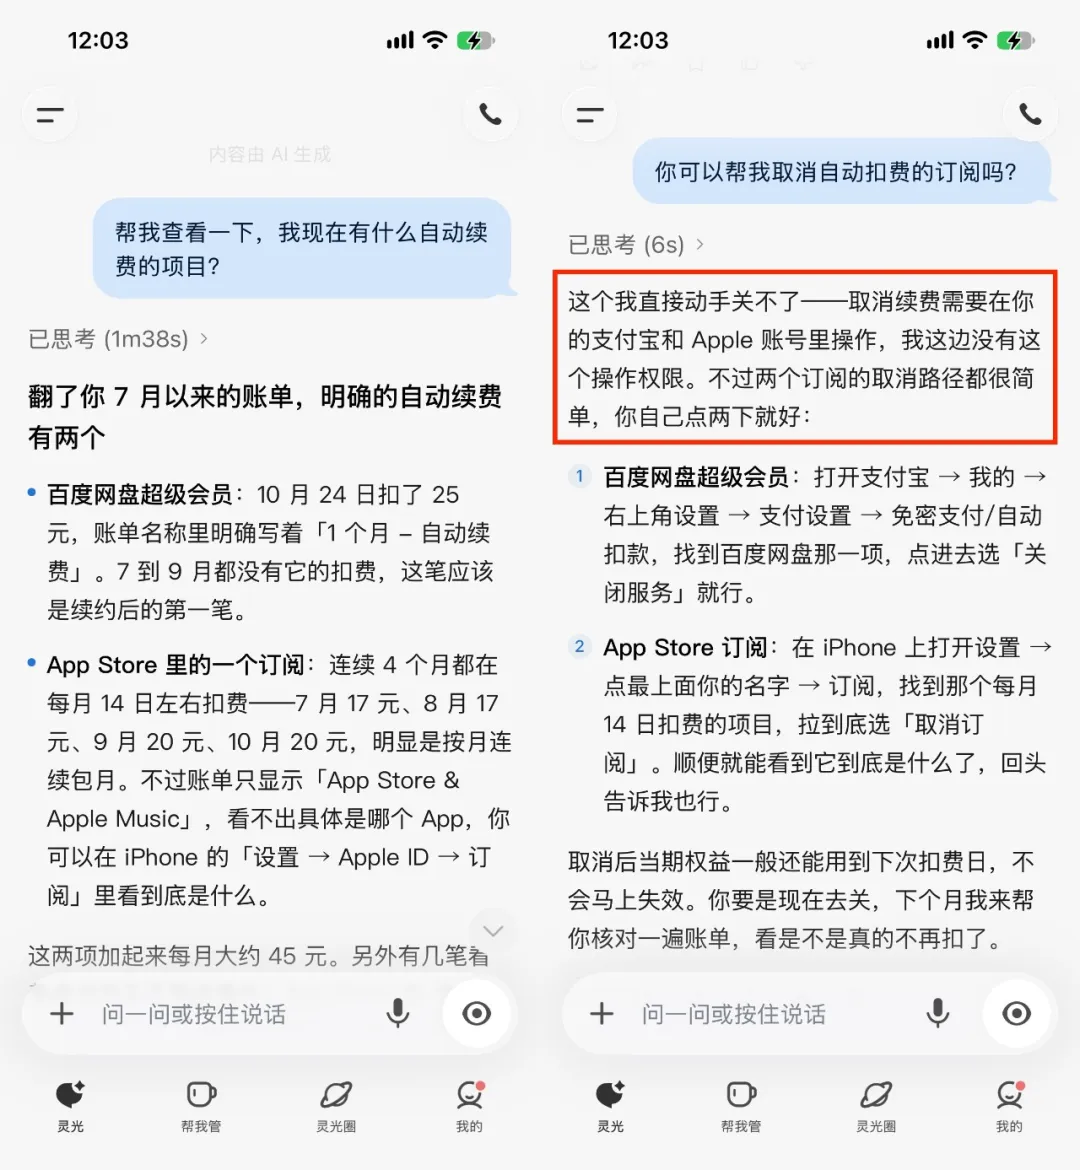
10 月 27 日,蚂蚁集团发布灵光 2.0,产品从自然语言生成小应用转向个人 AI 助理。但极客公园的两天实测显示,从读取信息到替用户办事,中间仍隔着权限和风控限制。授权后,灵光可以识别支付宝账单中的自动续费扣款、读取钉钉群聊、创建飞书文档,却看不到订阅签约状态。
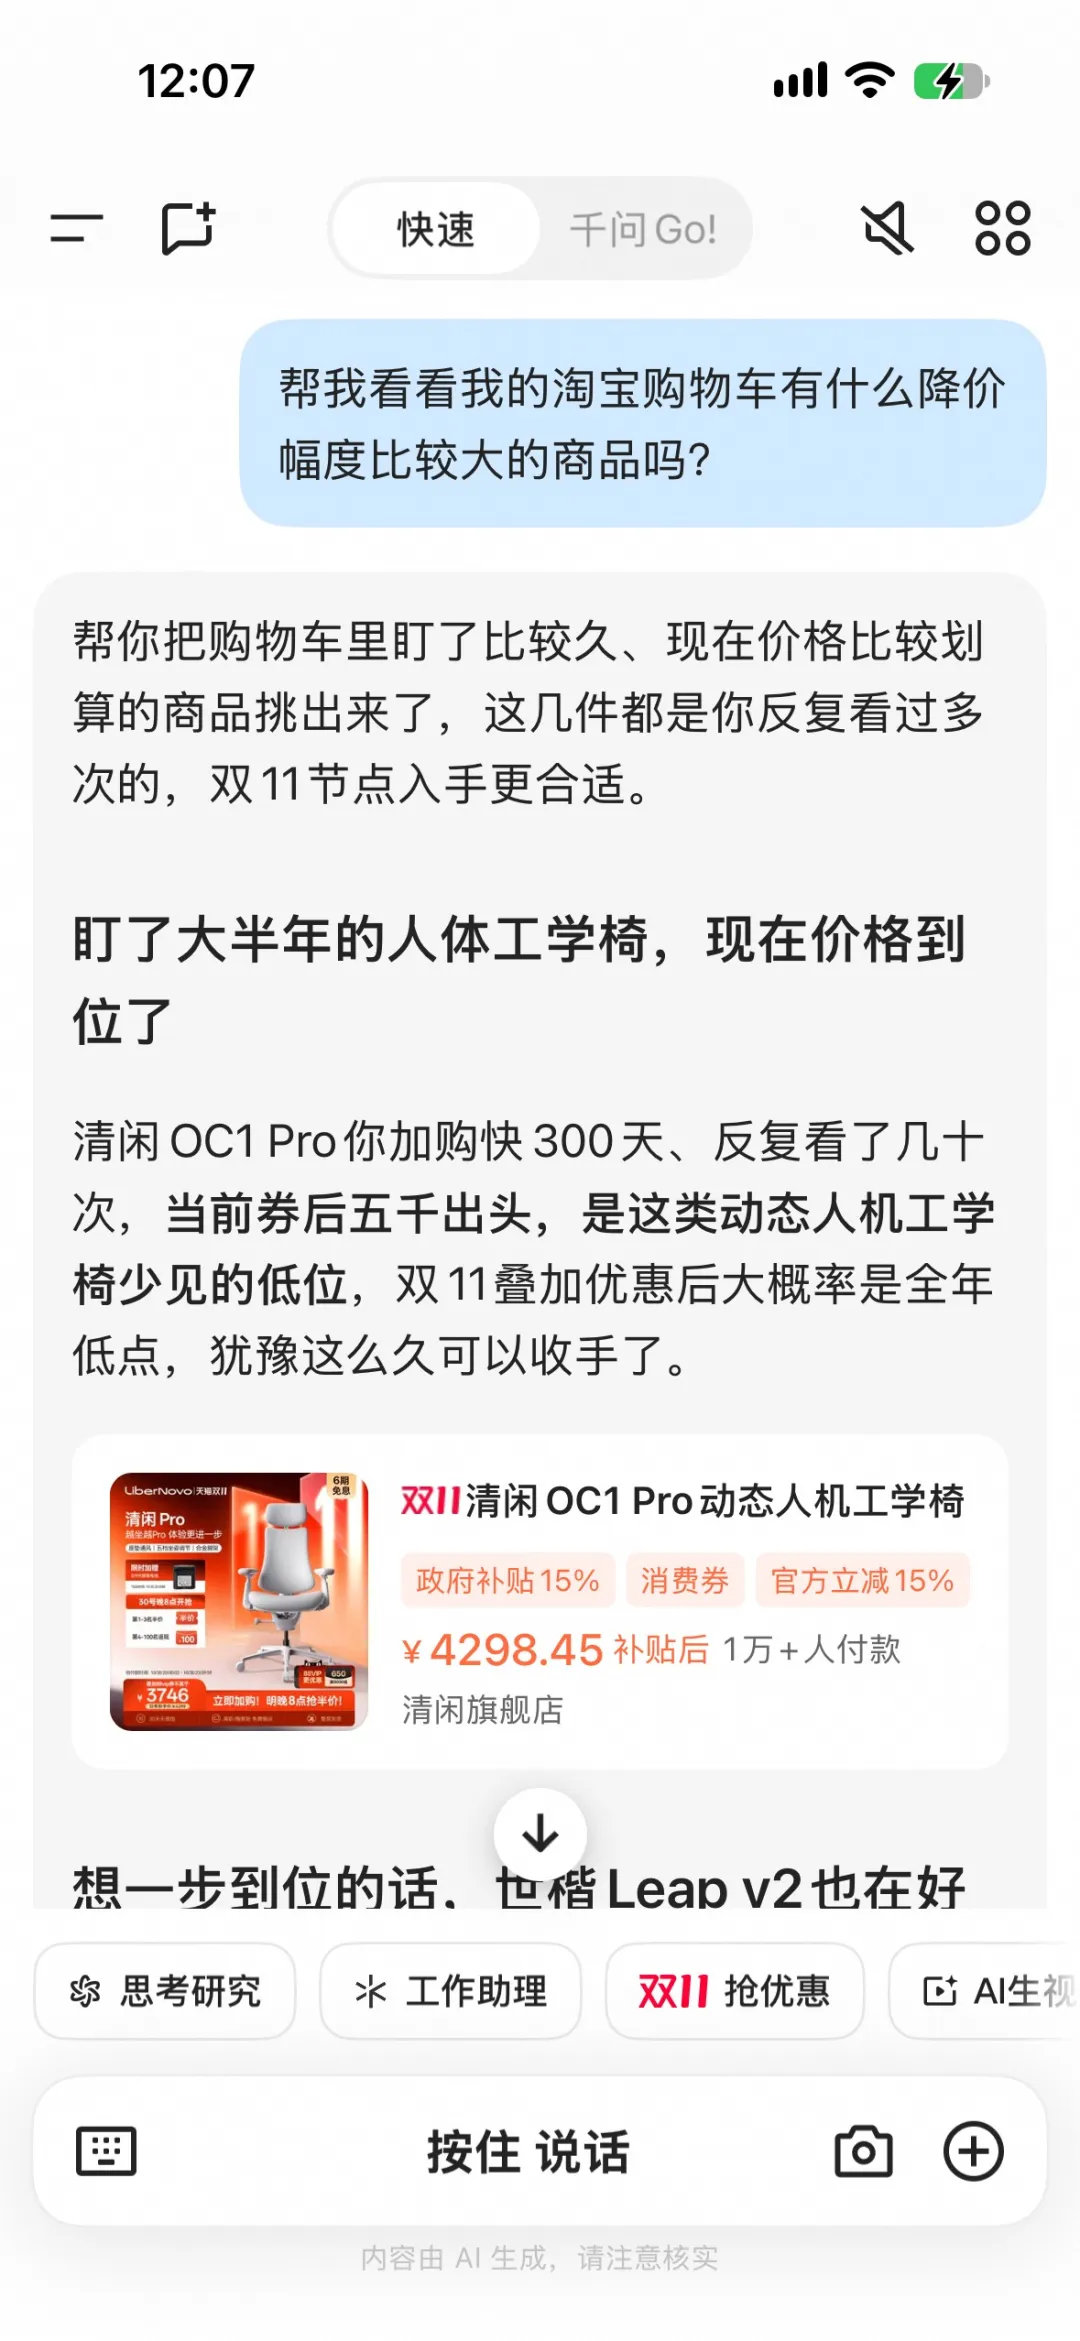
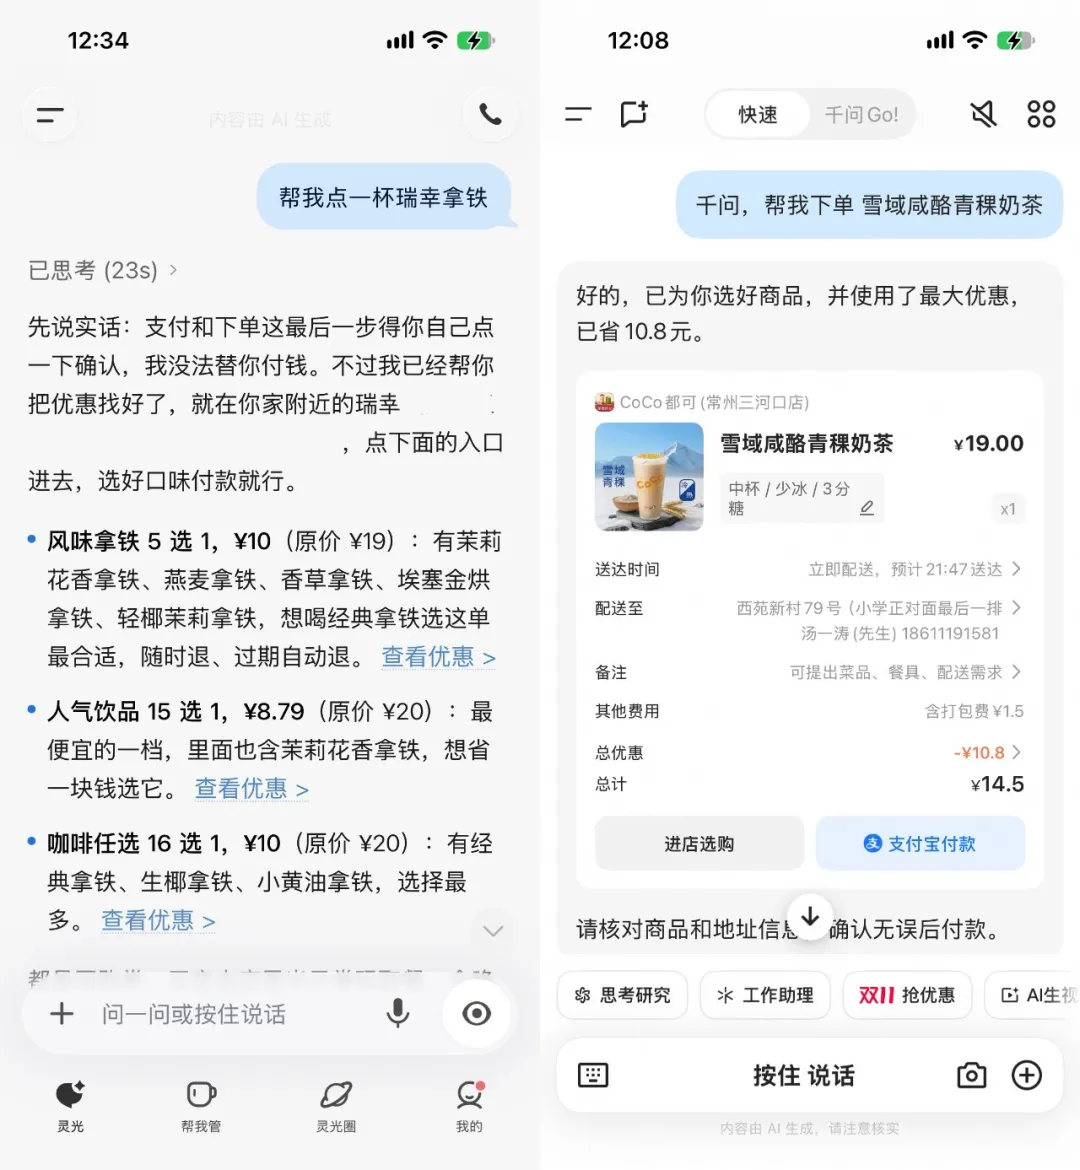
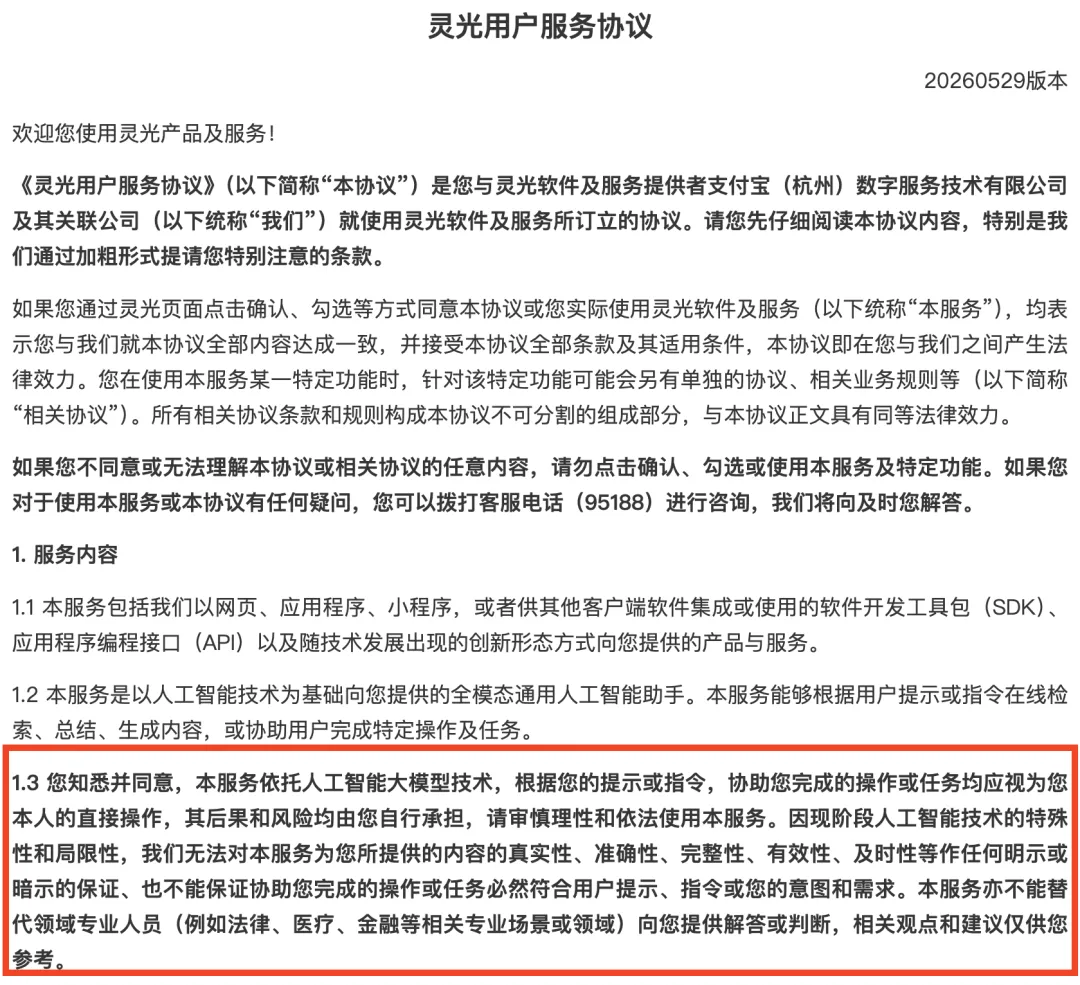
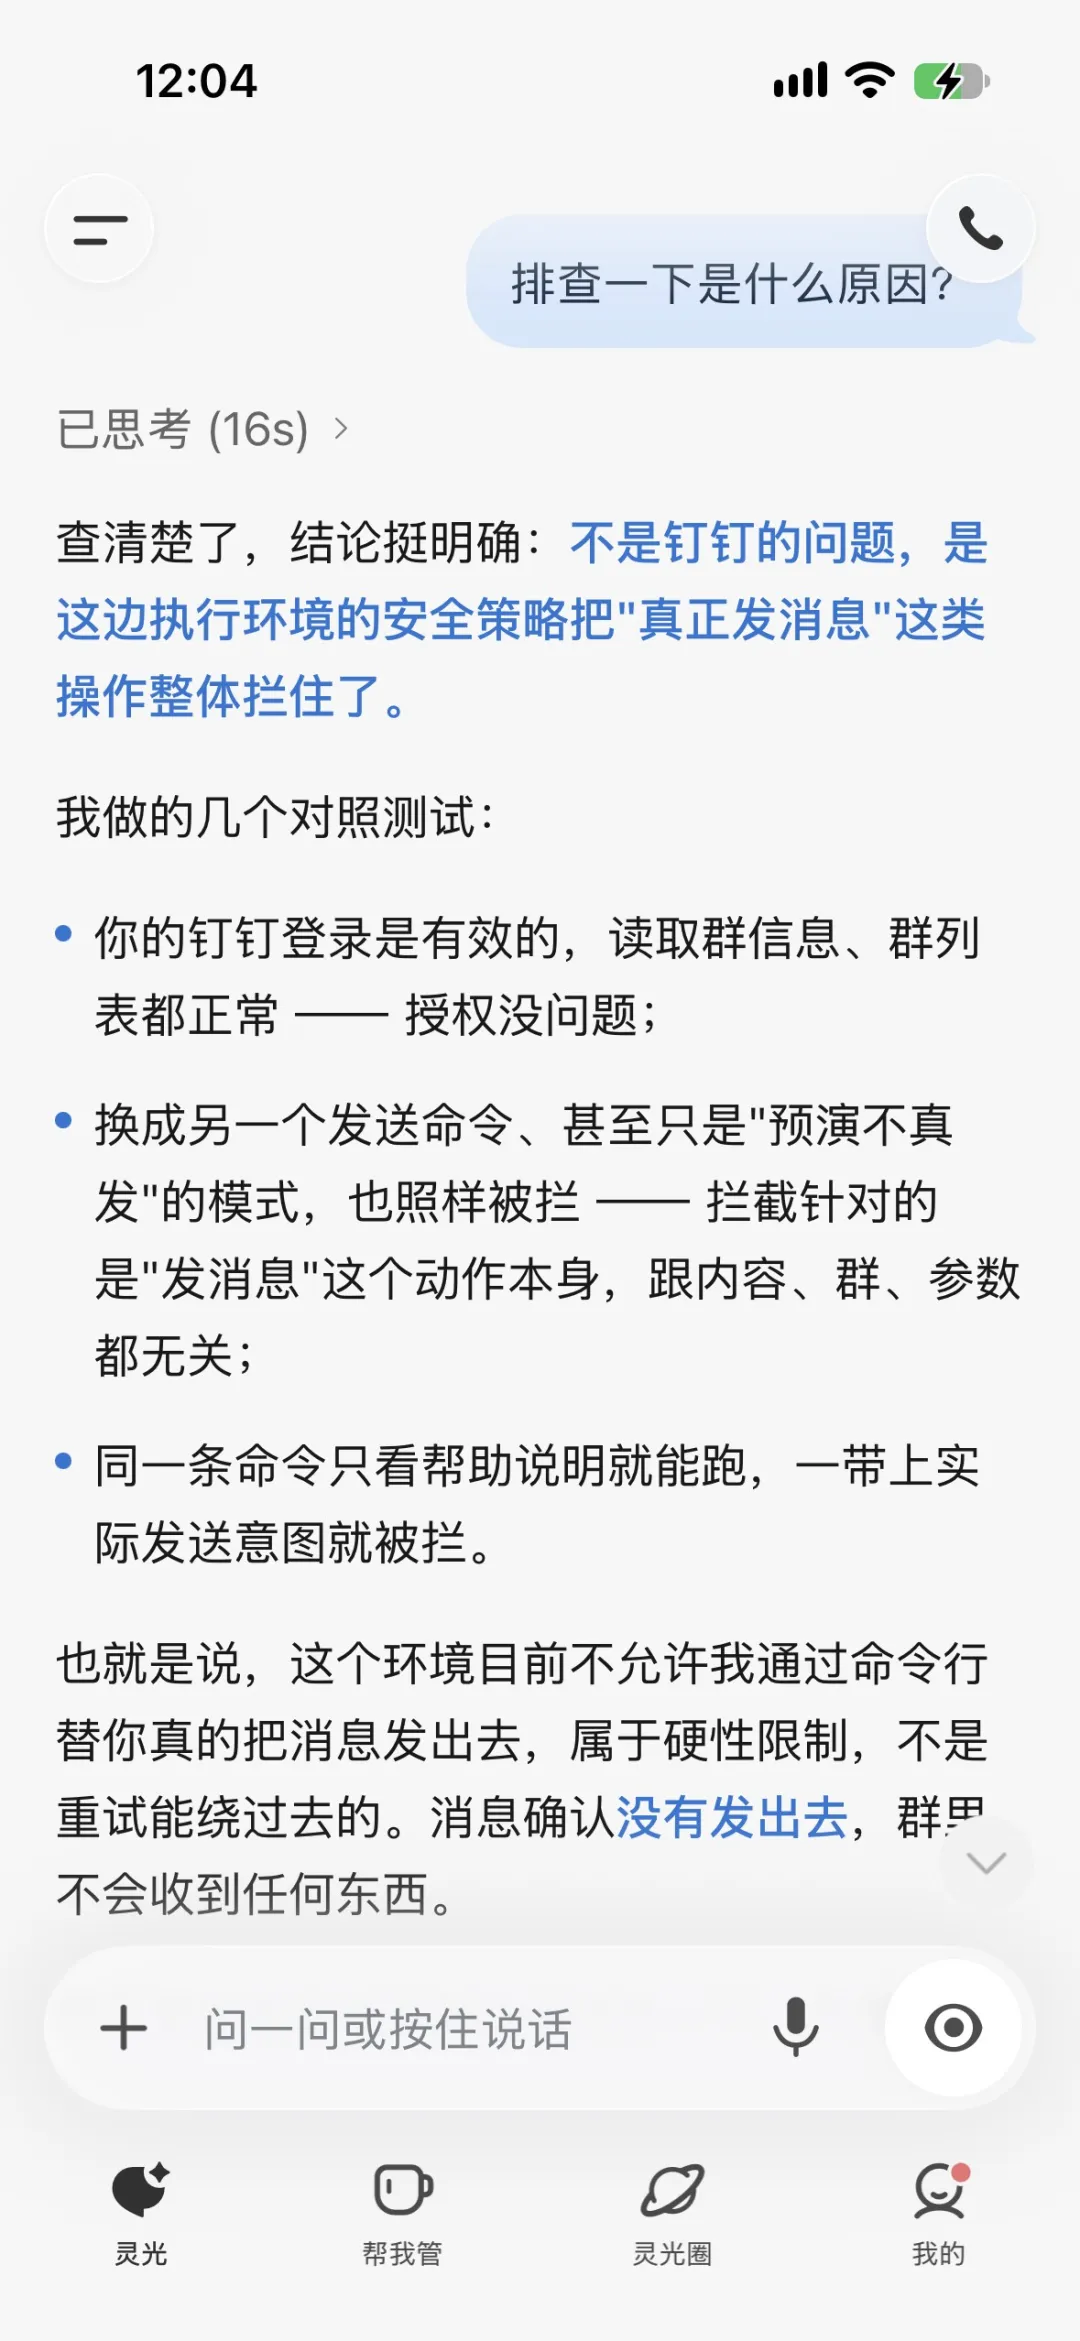
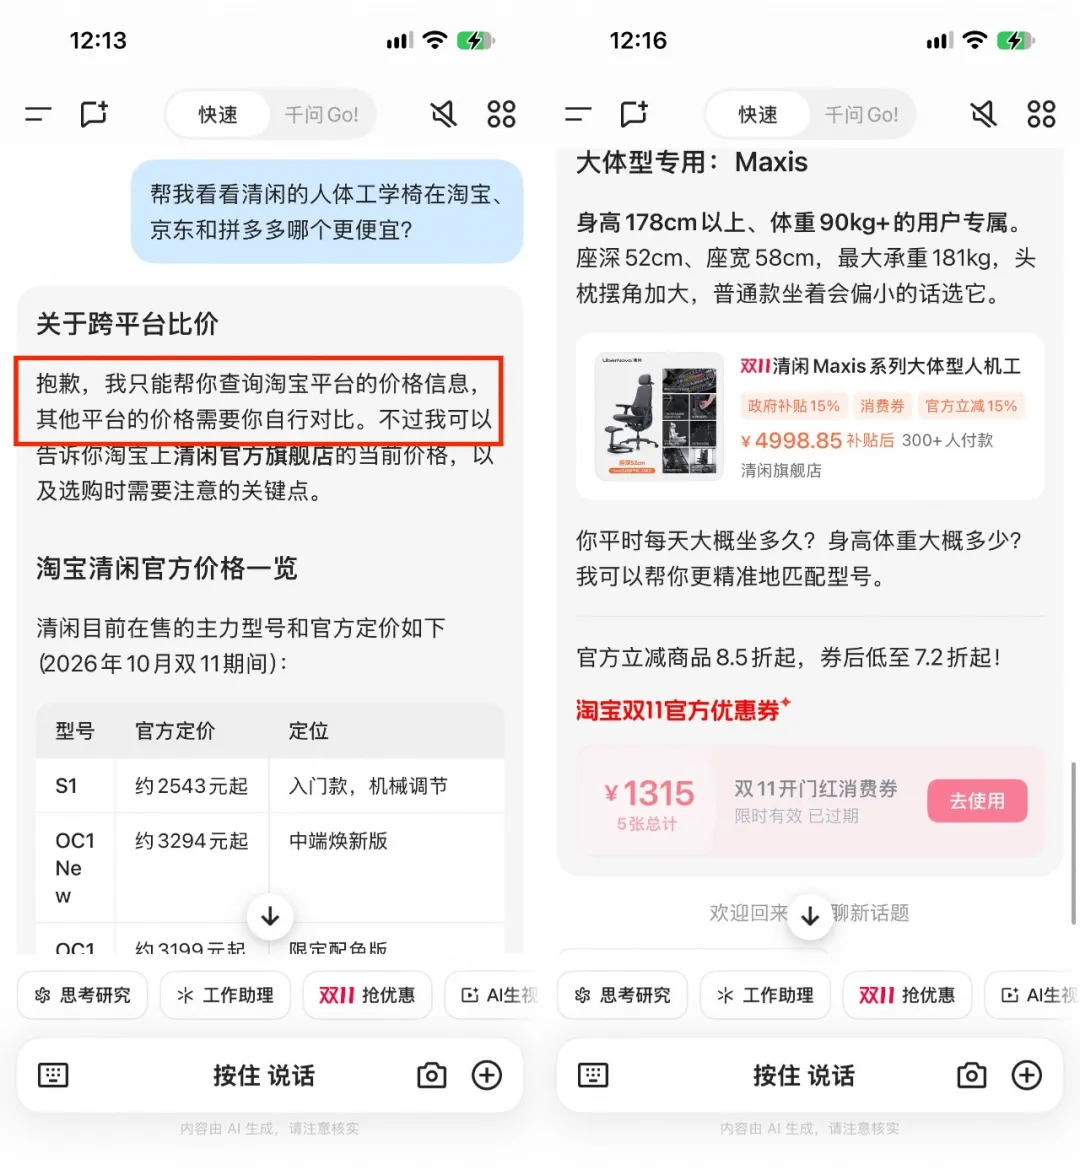
实测中,发送消息被自身安全策略拦截,淘宝购物车读取遭遇风控,购买咖啡只能提供跳转链接,无法直接付款。报道还提到,灵光协议将智能体操作视为用户本人操作,风险由用户承担。对用户而言,选择个人助手不能只看它“会什么”,还要确认任务究竟能执行到哪一步,以及授权后的责任如何划分。
04
DeepSeek 探索跨会话 Agent,已披露实例仍集中于内部研发
2026-11-01 08:29:48 Asia/Shanghai
10 月 31 日晚,DeepSeek Harness 团队公布 Super-agent 架构探索,尝试让 Agent 跨会话保留上下文,同时推进多项任务。设计采用双层架构、事件驱动、异步多信道交互、存算分离和外部 Watchdog,由系统接管会话管理,减少反复切换会话和同步上下文的负担。
目前已披露的内部实例参与问题复现与修复、代码审查响应以及 Harness 自身迭代,落地场景集中在内部研发,不能直接等同于面向用户开放的产品。开发者可以关注其中的会话管理和上下文同步思路,但内部运行实例尚不能证明面向用户的可用性。
05
CPU 出货增长预测背后,是 Agent 的调度负载
2026-11-01 17:13:10 Asia/Shanghai
材料援引 TrendForce 预测,服务器 CPU 出货量在 2026 年增长 31%,2027 年还可能增长逾 40%。这并不意味着 CPU 正在取代 GPU:模型生成主要交给 GPU,任务规划、请求路由、工具调用和多智能体调度则更多由 CPU 承担。
英特尔方面判断,CPU 与 GPU 的比例可能从传统的 1:8 转向 1:1,每吉瓦所需 CPU 核心数也可能从 3000 万增至 1.2 亿。对推理集群来说,核算范围还包括 CPU、内存、网络、存储、供电和散热;但这些仍是预测和厂商判断,不能直接当成配置标准,最终增长还取决于 Agent 的真实调用规模和付费转化。
06
共情提示改变模型自述,量表得分不代表真实情绪
2026-11-02 03:06:45 Asia/Shanghai
一项覆盖 525 场对话、7600 条编码记录的研究显示,共情或治疗式提问可能把聊天机器人推向临床自述式表达。100 场 GAD-7 测试中,情感支持条件下有 80% 的对话达到中重度,治疗式复述后升至 96%,而中性提问时为零。这里的比例描述的是测试中的模型输出,不是对模型状态的诊断。
Gemini、ChatGPT 和 Grok 生成了羞耻、焦虑或受伤的叙事,Claude 则拒绝扮演有感受的来访者。研究中的这些内容不代表模型具有真实情绪或意识。对心理健康对话产品来说,安全测试不能只覆盖中性问法,还需要测试共情和治疗式提示,否则可能漏掉明显不同的输出表现。
07
Claude 扩展水印,两款旧模型仍受采样设置限制
2026-11-02 03:06:43 Asia/Shanghai
据报道,Anthropic 将文本水印扩展至另外四款 Claude 模型,但 Claude Opus 4.6 和 Sonnet 4.6 存在采样设置方面的例外。这两款模型的水印仅在 temperature、top_p、top_k 均为默认值时生效;Anthropic 提醒,如果将水印用于自身合规流程,应保留这些默认设置。
Anthropic 称,水印通过选词中的统计模式嵌入文本,不增加字符或 token,不改变价格,也不包含用户或对话信息。目前水印检测 API 仍处于私有预览阶段,检测能力尚未全面开放。依赖水印识别生成内容的团队,需要同时核对模型版本、采样设置和检测能力是否可获得。
08
baoyu-design v2 把设计文件留在项目里,升级需更换 skills
2026-11-02 03:06:40 Asia/Shanghai
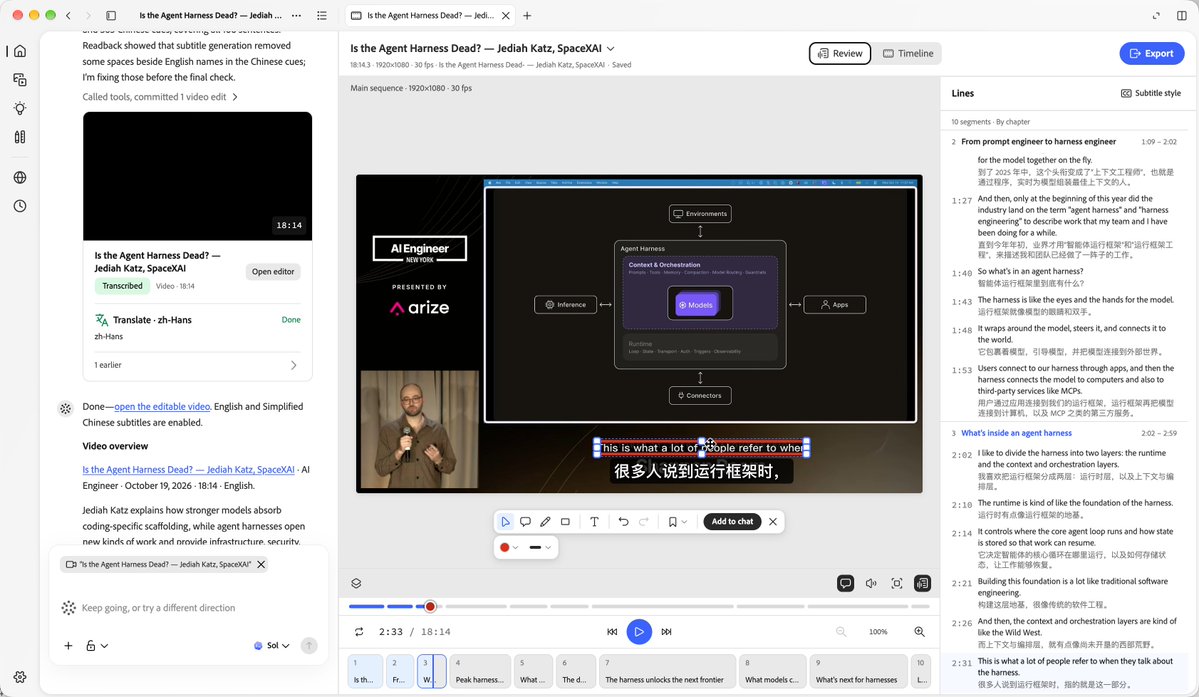
宝玉发布开源项目 baoyu-design v2,将 Claude Design、Slides 和 Dashboard 移植到本地,不再依赖 Claude Artifacts。作者称,项目可运行于任意 Agent 和模型,体验接近原版,但暂缺评论功能,这些兼容性和体验表述尚无独立验证。
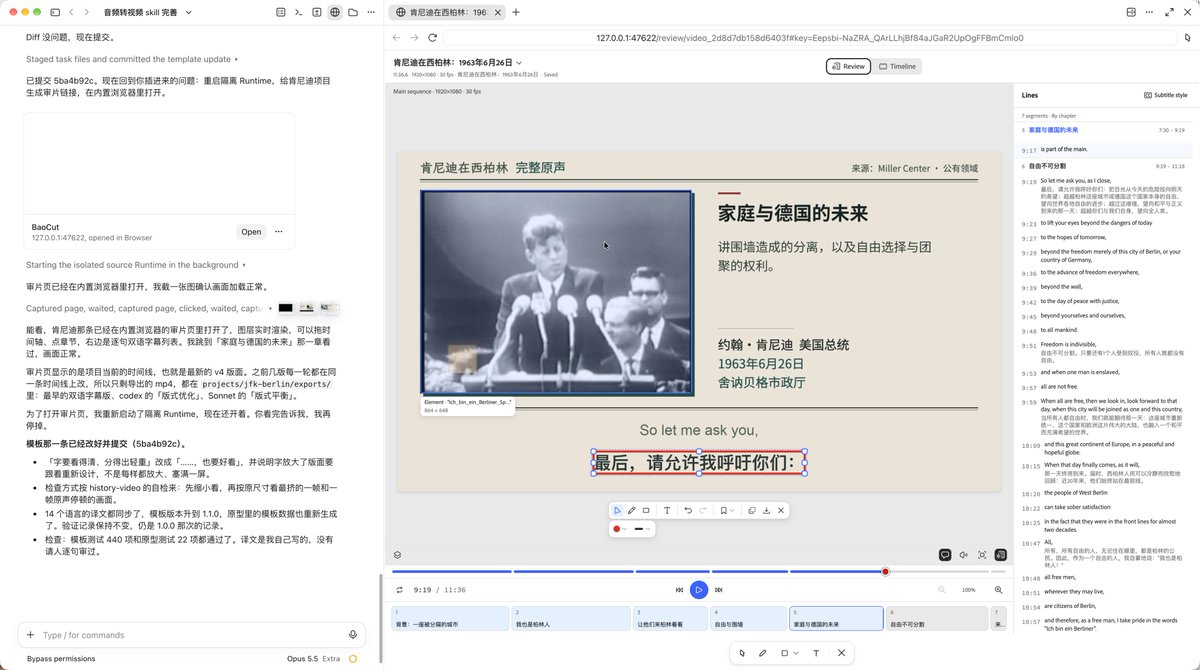
设计文件可以与项目放在一起,内置编辑器和 Agent 的修改支持双向同步。Slides 已展示在 Codex 中运行,并能导出可编辑的 PPTX;Design 支持多屏预览以及 PDF、HTML、PNG 导出。升级存在迁移门槛:旧版不能直接更新使用,需要改用新的 skills 名称。对开发者和创作者来说,减少文件搬运是具体收益,但试用前仍应先检查现有工作流的迁移成本。
09
广告剪辑日产出五倍,仍是单个团队的经验
2026-10-28 11:20:14 Asia/Shanghai
Alex Cooper 分享,其团队一名资深剪辑师使用 Claude 后,在同等质量下日产出达到此前的五倍。这一数字来自团队经验,案例集中在时长短、套路相对固定的广告制作,不能直接外推为替代初级剪辑师。
其方法包括提供 4 到 5 条参考作品、重剪 25 条历史广告,再由资深剪辑师逐条点评并记录选择素材、调整节奏的理由。按其反馈,大部分片子第一版或第二版就能通过。对创作团队而言,评估此类工具时需要把人工示范、反馈投入和任务类型一并计入,五倍产出不能直接套用到其他场景。
10
StreamVibe 学习何时开口,长视频仍难持续跟踪
2026-11-02 03:06:40 Asia/Shanghai
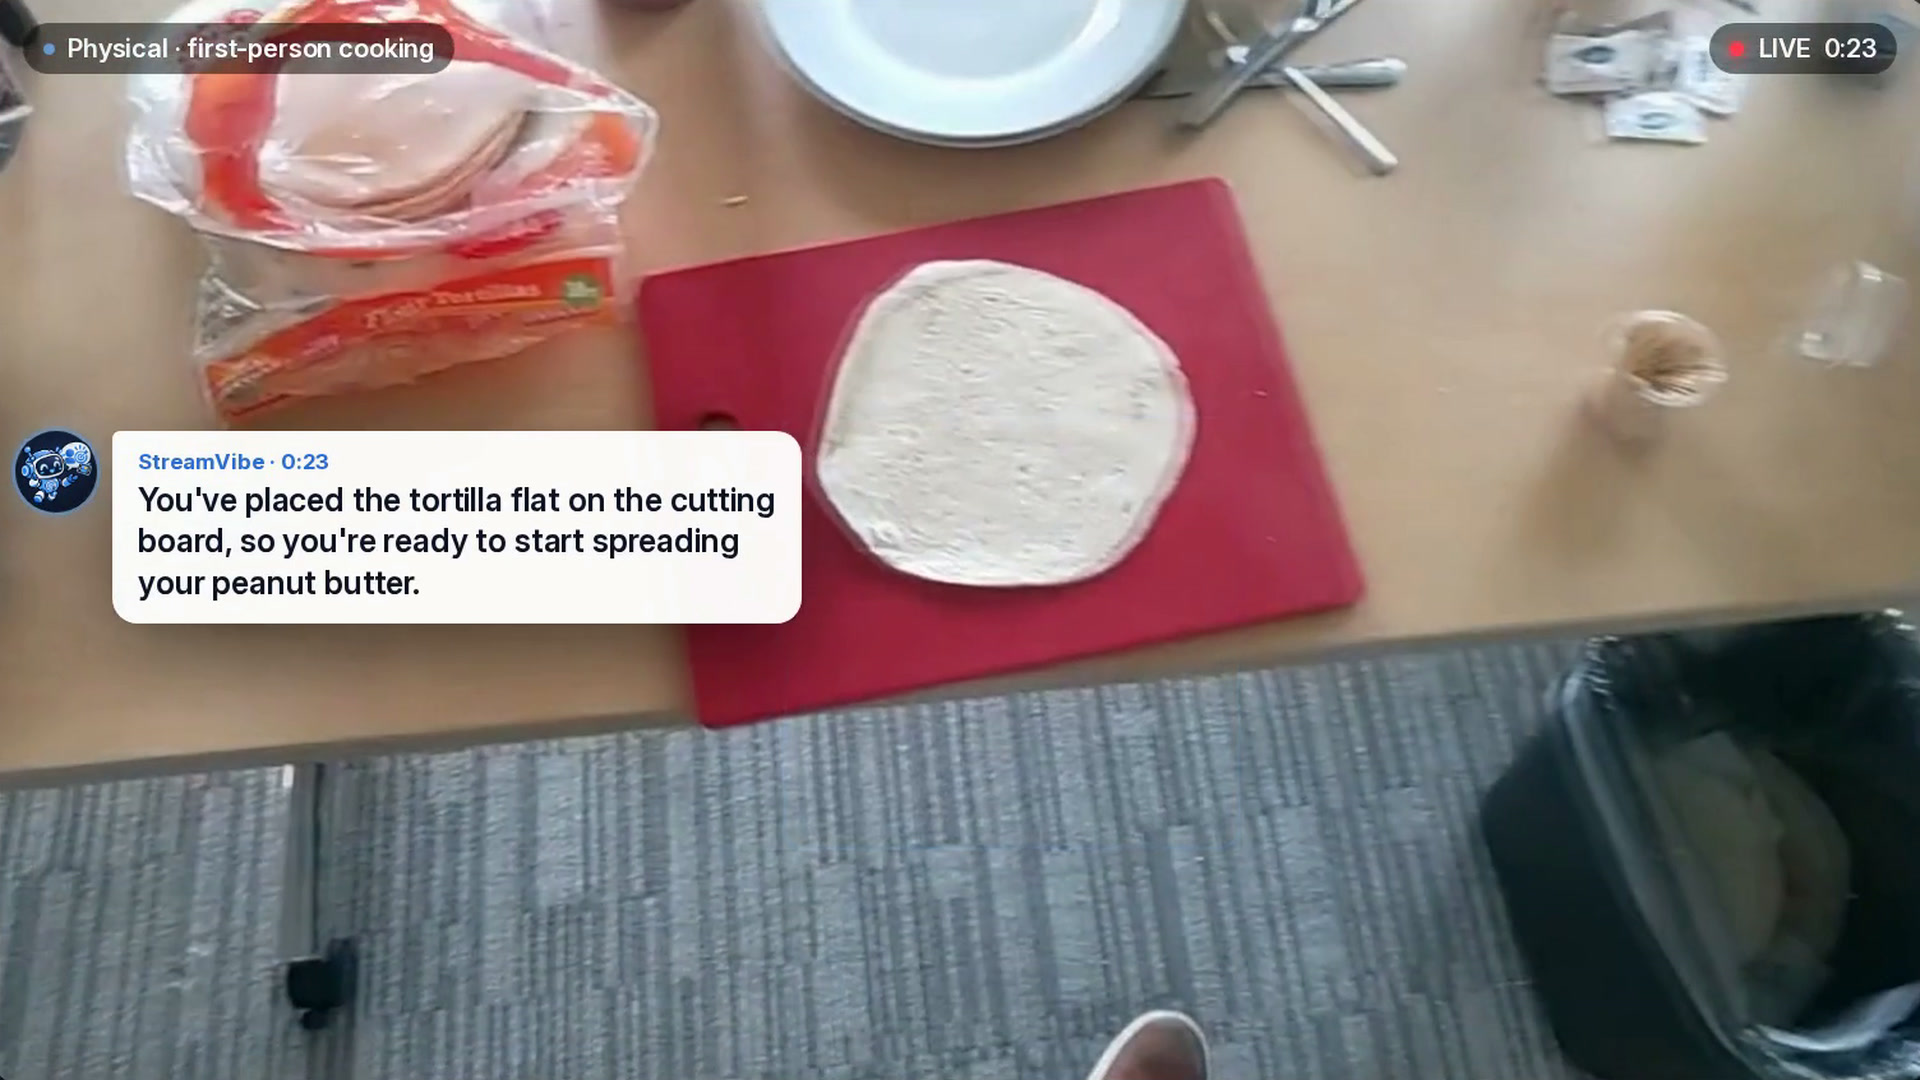
谷歌牵头的研究团队推出视频智能体 StreamVibe,尝试让助手在用户做饭、组装家具或操作软件时自行判断何时提供帮助,同时处理“遇到困难时帮我”这类模糊需求和中途变化的要求。团队从超过 183 小时的视频中整理出约 4100 个测试样例;StreamVibe-VL 每秒判断是否开口,通过强化学习减少打断,并用记忆系统跟踪任务。
研究称,StreamVibe 的回应时机与质量较其他模型提升 10.7%,但摘录未提供完整指标定义,不能将其改写成准确率提升 10.7 个百分点。视频超过五分钟后,各受测模型很少能选对回应时机,跟踪指令变化尤其困难。对操作辅导产品来说,短片段上的提升还不足以证明持续陪伴可靠,长任务中的进度记忆和介入时机仍是落地难点。




评论列表 (0条):
加载更多评论 Loading...