


Agent 一晚烧掉的钱,以前我只能对着总账单发呆:不知道是检索步在抖、还是重试环在空转。把调用挂进 langfuse/langfuse 之后,单次对话拆成可点开的 trace,哪一步贵、哪一步慢,终于能指着 span 说话。结论先说:Langfuse 实测:给 Agent 挂上 trace 后,我终于能定位是哪一步在烧钱。本文是聚合结构:以 Langfuse 为第一站,把适合/不适合、最小接入、trace 与 cost 用例、优缺点,以及何时改看 Phoenix / Helicone 聚到一条路由上。版本与安装命令以你访问当日官方文档为准。
定位:可观测解决什么、不解决什么
Langfuse 把自己定位成开源的 LLM 工程平台:追踪、评估、提示词管理,面向 Agent 与 LLM 应用的调试与迭代。我真正用上的第一价值不是「又一个仪表盘」,而是把一次用户请求拆成树状 span——模型调用、工具调用、检索、重试都挂在同一条 trace 下,延迟与 token 能对上号。
适合:你已经有多步 Agent / RAG;需要自托管或 Cloud;想把 cost、latency、错误率按 trace 看,而不是按日总账猜。
不适合:你只做单次 completion、且暂时零调试需求;你指望可观测产品替代评测集与权限门禁——trace 能告诉你烧在哪,不能替你定义「什么叫对」;你没有人愿意保管密钥与(自托管时的)数据库。
读 langfuse.com/docs 与 GitHub README 时我先看:Get Started、Tracing、Self-hosting、SDK 对 OpenAI / LangChain 的包装方式。Cloud 与 self-host 功能边界以文档当日说明为准;本文不锁死次版本号。
今晚可做的动作:列出你最贵的一条 Agent 路径(例如「问答→检索→生成→工具」),在纸上标出你现在看不到的三步。看不到的那三步,就是第一周 trace 的验收目标。
项目卡片
| 项 | 内容 |
|---|---|
| 仓库 | https://github.com/langfuse/langfuse |
| 文档 | https://langfuse.com/docs |
| 形态 | 开源平台 + Cloud;SDK / API 接入;可自托管 |
| 许可 | 以仓库 LICENSE 为准(安装前再确认) |
| 适合 | Agent/RAG 追踪、成本与延迟定位、团队协作调试 |
| 不适合 | 零观测需求的单次脚本;把平台误当唯一质量门禁 |
卡片之外我还会问:日志里能不能出现用户原文与检索片段?若合规要求脱敏,接入前先定 redaction 策略,别等 trace 里堆满手机号再补救。密钥只走环境变量或密钥柜,禁止写进前端。
今晚可做的动作:在团队群里确认一件事——用 Cloud 还是 self-host。定不下来就先 Cloud 开一个空项目做冒烟,自托管放到第二周,避免第一晚卡在 Postgres。
用例:trace 单次对话、看 cost / latency
用例一:拆开一次「答错但很贵」的对话。用户抱怨答案跑偏,账单显示这一小时特别烫。没有 trace 时,我只能猜是提示词或模型。挂上 Langfuse 后,点开该 session:检索 span 命中了过期文档、生成步又因超时重试了两次。修法变成「修索引 + 限重试」,而不是盲目换更大模型。验收:同一用户问题重放,trace 树层级与工具名符合你画的架构图,且能按 span 看到耗时。
用例二:按 cost 视图抓「默默烧钱」的步。官方能力里强调 token / cost 与观测一体。我给批跑任务打上独立的 user/session 元数据,第二天按元数据过滤,找出「工具循环调用」的尖刺。验收:故意造一次双倍工具调用,Cost 视图或 trace 详情里的费用应明显抬升,且能点回对应 span——否则你接的是日志搬运,不是成本观测。
用例三(可选加分):把失败 trace 链到评测集。观测负责「发生了什么」,评测集负责「该不该这样」。两者目录分开,但失败 trace id 要能写进评测工单。第一周做不到自动化也没关系,手工贴三条就够养成习惯。
今晚可做的动作:用 SDK 打一枪带 metadata 的测试调用(例如 run=smoke-1101),在 UI 里按该标记过滤,确认你能找到它。找不到就先别接业务流量。
优缺点短表:何时换 Phoenix / Helicone
| 做法 | 何时换到它 / 并用它 |
|---|---|
| Langfuse | 要开源可自托管的 trace + 成本视图 + 团队协作调试 |
| Arize Phoenix | 偏本地/笔记本式排障与评估实验,或已在 Arize 生态 |
| Helicone 等代理型 | 想以 API 代理方式快速挂观测,少改业务代码 |
| 只打应用日志 | 日调用极低且无人看仪表盘——但要承认你看不清 span 级成本 |
优点:trace 树对 Agent 友好;开源可自托管;文档把 Get Started 写得短。
缺点:自托管有状态组件要运维;接入要改 SDK 或包装层;把观测当质量门禁会自我安慰——仍需评测集与权限表。
我何时换或并用 Phoenix:当团队主战场在笔记本里做实验分析,或已有 Phoenix 工作流,不必强行迁数据。何时看 Helicone 一类:业务想「改一行 base_url」就出报表,且能接受代理链路。选型标准仍是:你能不能指着一次失败对话说出贵在哪一步。
今晚可做的动作:用上表给自己的项目勾一个「主观测」;主观测未冒烟前,禁止同时开三个平台「都试试」——并行只会让 metadata 约定分裂。
安装与最小跑通(今晚就能做)
按官方 Get Started / Self-hosting 文档,最小路径通常是:创建 Cloud 项目(或 docker compose 自托管)→ 创建 API keys → 用官方 SDK 包一层现有 OpenAI/LangChain 调用 → UI 里看到第一条 trace。
# Cloud:在项目设置复制 LANGFUSE_PUBLIC_KEY / LANGFUSE_SECRET_KEY
# 自托管:按文档 docker compose 起栈后,同样配置密钥与 host

# Python 示意(包名与初始化以当日文档为准)
# pip install langfuse openai
import os
from langfuse import Langfuse  # 或文档推荐的 OpenAI 包装方式
langfuse = Langfuse(
    public_key=os.environ["LANGFUSE_PUBLIC_KEY"],
    secret_key=os.environ["LANGFUSE_SECRET_KEY"],
    host=os.environ.get("LANGFUSE_HOST", "https://cloud.langfuse.com"),
)
# 按文档用 trace/span 或 OpenAI drop-in 包装打一枪
# 然后打开 UI → Traces,应看到 smoke 调用
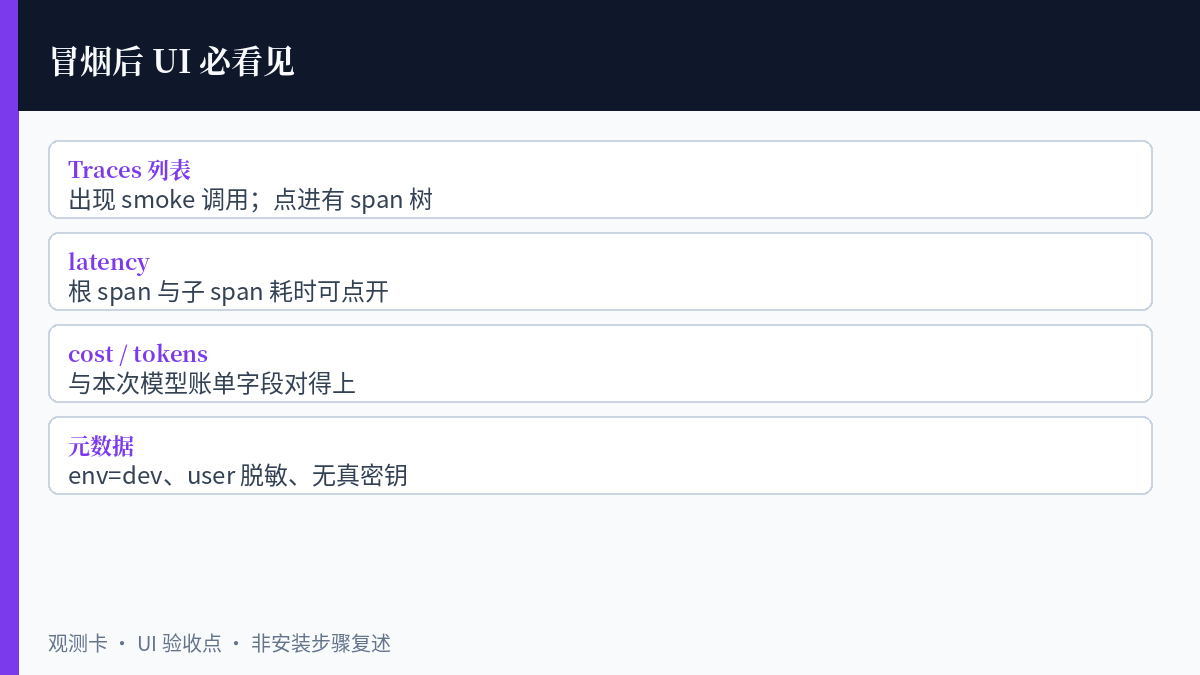
对照上图 UI 验收点:Traces 里能点进 span,再核对 latency 与 cost;对不上就停,先别接生产流量。第 4 步「看见 span」比「SDK 没报错」重要;第 5 步「cost 对得上」决定你能不能用它管账单。自托管团队直接跟官方 Self-hosting 文档走,注意数据库与点击屋类依赖的资源,别在笔记本电脑上承诺「给全公司用」。
今晚可做的动作:完成冒烟后,把 LANGFUSE_* 变量名写进仓库 .env.example(不含真密钥),并在内部 runbook 记一条:「如何按 session id 打开某次用户投诉」。写不出这条,说明 UI 还没真正跑通。
配置要点与翻车排查(第一周)
- 元数据约定先写一页:
user_id/session_id/feature/env四字段统一,否则 Cost 视图过滤会变成猜谜。 - 脱敏默认开:手机号、邮箱、证件号进 span 前打码;调试需要原文时走受控开关并设过期。
- 采样策略:全量 trace 在高 QPS 下又贵又吵。生产可按错误、高成本、或百分比采样;调试环境再拉满。
- 与网关分工:若已用 LiteLLM 等网关,明确「网关打支出、Langfuse 打链路」还是「只在一处记 cost」,避免双计。
- 密钥轮转:secret key 进密钥柜;人员离职即轮转;前端永远不放 secret。
翻车排查
- SDK 成功但 UI 空白:查 host 是否指错区域/自托管域名;查时钟与批量上报是否未 flush;查项目是否选错。
- 只有一代模型调用、没有工具 span:包装层没包到工具执行器。把工具函数也纳进同一 trace 上下文,而不是另起没有 parent 的日志。
- cost 全是零:模型名未映射到价表,或 token 用法未上报。先对官方价表核对模型名字符串,再谈「省钱」。
- 自托管磁盘被 trace 撑爆:设保留周期与导出策略;调试期的全量采样记得关。
- 把观测当成上线验收:trace 全绿只说明「有数据」,不说明「答案对」。上线仍看评测集与权限门禁。
接入顺序上我踩过一次反过来的坑:先把生产流量全打进未配脱敏的项目,再回头删 span。正确顺序是:空项目冒烟 → 定 metadata 与脱敏 → 影子流量(只写观测、不改用户路径)→ 抽样打开 → 全量或按错误采样。影子阶段至少留 48 小时,专门盯「有没有不该出现的原文」和「cost 是否双计」。双计一旦发生,财务对账会比调试 Agent 更折磨人。
和评测集的分工再钉一句:Langfuse 告诉你「这一步花了多少、慢在哪」;评测集告诉你「这一步该不该这样答」。我见过团队把 dashboard 的绿线当成上线标准,结果拒答样例全挂。观测再漂亮,也替不了那 50 条金标。若你同时在写深度文里的评测门禁,把失败 trace id 写进评测工单即可,不必第一周就上自动闭环。
权限与合规清单(第一周必须勾完):谁能看含用户原文的 trace;外部承包商是否只能看聚合报表;导出到仓库外的 CSV 是否走审批;删除用户数据时能否按 user_id 级联清理观测数据。勾不完其中任一条,就先把原文字段关掉,只留模型名、耗时、token、工具名。能定位烧钱,已经完成今天的主目标;好奇心往后排。
性能侧也留个底:SDK 上报失败时,业务请求必须仍成功。观测是旁路,不是主链路熔断器。官方与社区常见做法是异步批量上报;你要在 runbook 写清「上报队列堆积时怎么办」——丢弃旧调试 span、保留错误 span,而不是阻塞用户。把这条写进值班手册,比再加一块「可观测很重要」的幻灯片有用。
收尾再钉一次:Agent 烧钱 → 挂 trace → 按 span 看 latency/cost → 再决定是缩重试、修检索,还是换模型。Langfuse 把开源观测的轮子备好了;你要做的是今晚冒烟、第一周定元数据与脱敏。看不清哪一步贵,就不要先买更贵的模型。


评论列表 (0条):
加载更多评论 Loading...