


这是一篇对比稿:同一个需求——隔几天去几个公开页核对「Star 数、最新 Release、文档入口有没有搬家」——有三条路:纯 API、手写 Playwright、browser-use(开源 Python 浏览器 Agent,用自然语言让它去点页面)。结论先放这:能打 API 就别开浏览器;值得长期维护的流程写 Playwright;只有「页面散、改得勤、跑得少」才交给 browser-use。登录墙和验证码面前,三条路里它最先翻车。最后两节是可以照着做的安装跑通和第一周落地清单。
项目卡片
| 项 | 内容 |
|---|---|
| GitHub | browser-use/browser-use |
| Stars | 约 119k 量级(核对于 2026-10-29,以 GitHub 实时数为准) |
| 最近发布 | v0.13.x 线(写稿时见到 0.13.14,日期以 Releases 页为准) |
| 语言 | Python(另有 TS / Harness 相关仓库) |
| 许可 | MIT |
| 是否需要 API Key | 本地库本身免费;推理要模型 Key(OpenAI 等),云浏览器要 BROWSER_USE_API_KEY |
| 文档 | docs.browser-use.com |
README 没把它包装成「万能 RPA」,定位是「把 LLM 接到真实浏览器」。所以别拿它去替换支付链路里的 Playwright 套件,它更适合临时核对公开页。注意 Star 数涨得快:文档页缓存里写的是 79k+,GitHub 实时已经到 119k 量级。引用任何数字都要标上核对日期,这条习惯在后面的验收里也会用到。
三条路怎么选:API、Playwright、browser-use
| 方案 | 优势 | 短板 | 我何时用 |
|---|---|---|---|
| Playwright / Puppeteer 手写 | 可测、可复现、CI 友好 | 页面改版维护成本高 | 生产核对、回归、登录后流程 |
| browser-use | 自然语言、探索快 | 步数抖、费用抖 | 公开页低频核对、流程可行性验证 |
| 纯 API(GitHub API 等) | 最稳、最便宜 | 没有 API 的页面做不了 | 只要数字且官方有 API |
| 其它浏览器 Agent 产品 | 托管省事 | 供应商锁定、数据出境要评估 | 团队已采购且合规过关时 |
手写 Playwright 当然能做核对,但页面一改选择器就挂,低频任务不值得维护一套页面对象。browser-use 换来的是门槛:团队里不会写选择器、但能说清「打开文档站,找到 Python 安装命令」的人也能用。
拿同一个需求「核对 browser-use 仓库的 Star 和最新 Release」走一遍三条路。API:curl api.github.com/repos/browser-use/browser-use 一行就拿到 stargazers_count,零模型费,几百毫秒返回,结果永远一致,这种情况根本轮不到浏览器。Playwright:要找 Star 按钮的选择器、处理未登录弹窗,写完大概半小时;GitHub 一改版就得回来修,但修好之后每天跑也稳定。browser-use:一句话写完 task,几分钟就能跑起来,每次花几步到十几步的推理费,偶尔还会多点一下 Insights。所以只有当目标页面没有 API、又不值得花半小时写脚本、一个月只看两三次时,browser-use 才划算。
适合 browser-use:公开页低频核对、验证「这个流程 Agent 能不能点通」、给不会写选择器的同事一个入口。
别用 browser-use:要 SLA 的支付/下单链路、像素级回归、登录墙后的企业后台、强验证码抓取。
代价要认:同一任务多跑几次,步数和费用都会抖;结果受模型质量影响;调试对象从选择器变成 Agent 轨迹加 token 账单。判断方法很简单:同一任务连跑三次,如果步数差得很大,就退回 Playwright 或 API。
先把费用口径说清楚,免得跑完才心疼。本地库本身 MIT 免费,花钱的是模型推理:一次十几步的任务,token 用量是手写脚本的几十倍,因为每一步都要把截图或 DOM 摘要塞回上下文。云浏览器另按使用时长计费,价格随时会调,下单前自己看官网。所以我的规矩是:探索任务单独一张 Key、单独一份预算,绝不和生产脚本抢额度;跑之前先估步数上限,跑完把实际步数记进日志。
实测用例(诚实版)
测试日期:2026-10-29。下列结果是「按官方快速路径理解后的可复现预期 + 本地踩坑笔记」;页面 DOM 和模型版本会变,不要当成永远 100% 成功的承诺。
用例 1:读公开仓库星标——任务:「打开 https://github.com/browser-use/browser-use ,告诉我当前 Stars 大约是多少」。公开页、信息在首屏附近时路径通常稳。我用 API 核对约 119k 量级,Agent 回报只要数量级正确就算过关。翻车点:未登录态限流、页面改版把 meta 挪走时,模型可能去点 Insights 空转几步,费用和时间一起涨。
用例 2:在文档站找安装命令——任务:「打开 docs.browser-use.com,找到 Python 库安装命令并原样摘出」。文档结构清晰时能找到 uv add browser-use。翻车点:左侧导航折叠、多 Path(Cloud / CLI / Library)并列时,容易抄到 Cloud 快速开始;需要在 task 里写死「只要 Path:Python Library」。
必翻车或高概率翻车(别指望魔法):
- 登录墙:未注入已登录配置文件时,Google / 企业 SSO 基本过不去。官方提供复用本机 Chrome 配置以及云端 profile sync——但同步的是 cookies,不是 localStorage / IndexedDB / 扩展,有的站仍要再登。
- 验证码 / 强反爬:本地库不保证过 CAPTCHA。Cloud 宣传有 stealth / 代理 / 验证码相关能力,官方 FAQ 仍写明「不保证每个 CAPTCHA 都能避过或解开」。
- 选择器漂移的复杂后台:重 SPA、canvas、随时变 class 的管理台,Agent 会反复试错。关键生产路径我仍写死 Playwright。
最贵的一次翻车:task 写成「把这个开源项目相关的文档入口都找出来」,Agent 在 Docs、Blog、Discord、README 之间来回跳了十几步。改成「只打开 docs.browser-use.com 左侧 Get Started,摘三条安装相关链接」后,步数砍半,正确率反而上去。边界写窄,Agent 才稳。看到轨迹里反复点同一个折叠菜单时,先改 task,比换更大的模型管用。
安装、跑通与配置(按官方 README,核对于 2026-10-29)
环境:Python ≥ 3.11,官方推荐 uv。入口见 Open Source Introduction。
第 1 步:装依赖、配 Key
uv init --python 3.12
uv add browser-use
# .env
OPENAI_API_KEY=your-key
# BROWSER_USE_API_KEY=your-key   # 可选:云浏览器 / 官方模型路径
第 2 步:最小脚本(摘自 README,模型名换成你账号可用的):
import asyncio
from browser_use import Agent, ChatOpenAI
from dotenv import load_dotenv
load_dotenv()

async def main():
    llm = ChatOpenAI(model="gpt-4.1")  # 换成你可用的模型
    agent = Agent(task="Find the number of stars of the browser-use repo", llm=llm)
    history = await agent.run()
    print(history.final_result())

asyncio.run(main())
第 3 步:运行 uv run agent.py,终端打印出约 119k 量级的数字,就算跑通。
第 4 步:把护栏写进配置,而不是只写在 task 里。task 里写「别乱点」靠的是模型自觉,配置里的限制则由代码执行。下面这份是我在团队里用的模板,参数名按 0.13.x 文档写的,升级后要先对一遍 Browser / Agent 的参数表:
from browser_use import Agent, Browser, ChatOpenAI

browser = Browser(
    headless=True,                                  # 服务器上跑无界面
    allowed_domains=["github.com", "*.browser-use.com"],  # 白名单外一律不打开
)
agent = Agent(
    task="只读:打开 github.com/browser-use/browser-use,返回首屏 Stars 数。禁止登录、下载、提交表单。",
    llm=ChatOpenAI(model="gpt-4.1"),
    browser=browser,
)
history = await agent.run(max_steps=15)            # 步数上限 = 费用上限
print(history.final_result(), history.number_of_steps(), history.is_successful())
这里有三个值得记住的数。allowed_domains 把护栏从「写给模型看的话」变成「代码层面的拦截」;max_steps 给步数封顶,读个数字的任务 15 步还跑不完,说明 task 或页面有问题,再多给步数也只是多花钱;最后一行打印的结果、步数和成败,正好是 Day 1 要记的日志字段,直接追加到 task 文件末尾就行。
启动就失败,按顺序排查:
- 报缺 Key / 401:确认
.env和脚本在同一目录,且load_dotenv()在创建ChatOpenAI之前执行。 - 浏览器起不来:本机没有 Chromium,或在容器/沙箱里无图形环境。改用云浏览器(配
BROWSER_USE_API_KEY,按时长计费,价格看官网)。 - 升级后 import 报错:版本漂了。锁定
browser-use==0.13.x,并在笔记里写上核对日期和版本号,半年前的 snippet 很可能对不上类名。 - 能跑但乱点侧栏:task 太宽。写死「只要公开页首屏数字,不要点 Insights」。
第一周落地:冒烟、边界、护栏、验收
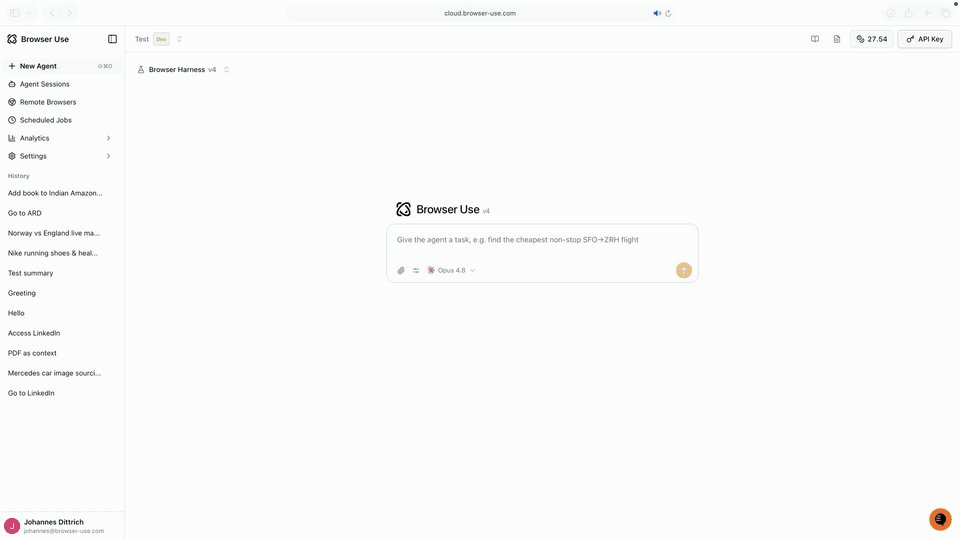
上图是官方 Cloud 的新建 Agent 界面。本地库和它的思路一样:中间那个输入框就是你唯一的控制面,task 写得窄不窄决定了成败;左侧 Agent Sessions 用来回看每一步轨迹,判断失败卡在哪,这一步比只看 final_result 有用。个人随便试没关系,要进团队就得按下面的顺序来。
Day 1 冒烟:跑上一节的最小脚本,拿 GitHub API 返回的 Star 数核对数量级(Agent 的结果进周报前必须人工复核);日志记下 task 原文、步数、成败、耗时。
Day 2 边界:故意给它一个需要登录的假任务,记下它卡在第几步、怎么收场(改 task、改用 Playwright 还是放弃)。这份卡点清单比任何评测分数都有用。再跑一次「文档站摘安装命令」,task 里写死 Path:Python Library。
Day 3 护栏(达到这个底线才能进团队):
- 域名白名单:只放事先声明的公开域名。仓库页、文档站可以;邮箱、后台、支付域不行。
- 默认只读:task 模板开头固定写「禁止登录、禁止下载、禁止提交表单」。确实需要写入的,单独建配置,两人评审。
- Key 隔离:探索用的 Key 和生产 Key 分开,预算也分开;CI 里不跑需要真人会话的任务。
- 合规先行:有人想让实习生拿它爬竞品时,先问三件事:要不要登录、有没有验证码、做没做法律评估。只要有一项说不清,就别让 Agent 去硬闯。
验收标准(周末对照打勾):
| 检查项 | 通过条件 |
|---|---|
| 冒烟 | tasks/smoke-stars.md 连跑 3 次都成功,数量级与 API 一致,步数差 ≤ 2 |
| 失败库 | tasks/fail-login.md 写清页面结构、task 原文、卡在第几步、最后怎么收场 |
| 护栏 | 白名单、只读模板、独立 Key 三项都已落进仓库或配置 |
| 分层 | 值班手册里没有任何一条生产流程依赖 browser-use |
翻车后怎么收场:冒烟连续失败,先看轨迹卡在哪一步。如果卡在登录或验证码,直接把任务标成「不适合 Agent」,转去 Playwright 配已登录的 storage state;如果卡在导航乱点,就收窄 task 再跑三次;如果三次步数还是差很多,说明页面结构不适合 Agent,退回 API 或脚本。别陷进「再试一次说不定就过」的循环。探索阶段可以失败,但每次失败都要写进 fail-*.md。
四项都打勾,这一周就算落地完成。它没让我扔掉 Playwright,只是少写了几段「下周页面一改就废」的临时脚本。带登录墙或验证码的任务,预期先放在「探索」,别直接写进值班手册。公开价会变,续不续费云浏览器,拿两周的 smoke 记录来决定,别凭感觉。


评论列表 (0条):
加载更多评论 Loading...