


AI DAILY BRIEF / 2026.11.22
OpenAI披露,内部测试中推理提取的平均攻击成功率从原版防护GPT-6 Astra的54%降至新版Astra的0.2%,属跨版本比较,不等于部署拦截率。对API开发者,改写历史消息会丢弃后续受保护推理,工具调用参数也纳入输出检查。
本期还关注可灵商业制图、AI数学证明核验、算力建设、药物化学评测和本地模型:内部成绩、项目规划与实际可用效果,需要分别看待。
OpenAI更新反蒸馏防护,API对话改写受影响
OpenAI披露了GPT-6.2 Astra和Sol的反蒸馏防护更新,重点保护模型内部推理。在其内部自适应黑盒测试中,提取此前请求推理的平均攻击成功率,从采用原版防护的GPT-6 Astra的54%,降至新版Astra的0.2%。
这一比较涉及不同版本,结果仅适用于所述内部测试,不能视为实际部署中已经杜绝推理泄露。
对API开发者,更直接的变化是推理与对话历史的绑定:改写早先消息,会丢弃后续受保护推理;输出检查也覆盖工具调用参数。涉及历史消息编辑和工具调用的应用,需要据此检查交互流程,尤其要关注改写消息后推理被丢弃的情况。
OpenAI的内部研究还显示,完整推理轨迹可能比推理摘要传递更多网络安全能力。这为保护内部推理提供了研究依据,但并不意味着上述攻击成功率可以解释为蒸馏检测准确率。
开发团队当前最值得核对的是对话改写与工具调用流程;防护在真实部署中的效果,仍需后续证据验证。
在同一轮研究公告中,OpenAI提出的风险是:蒸馏可以复制强大的AI能力,却未必保留围绕这些能力建立的防护措施。研究聚焦如何对抗针对其模型的蒸馏、能力如何转移,以及如何检测并干扰有组织的蒸馏尝试。
我们的判断:公司称,研究发现正用于加强自身防御,但这则帖文没有披露检测准确率或拦截成效。对采用蒸馏模型的团队,合理的做法是分别检查能力表现与安全边界;这项风险判断不能扩展为所有蒸馏行为都不安全或违规。
可灵新图像模型提高文字容量,商品信息仍需核对
可灵推出Kling Image 4.0,把文字生成和编辑控制作为商业制图的升级重点。官方称,模型支持原生8K、单图最多2000字、一次最多生成10张连贯图片,还可选中已有文字修改,内置70多款预设字体。
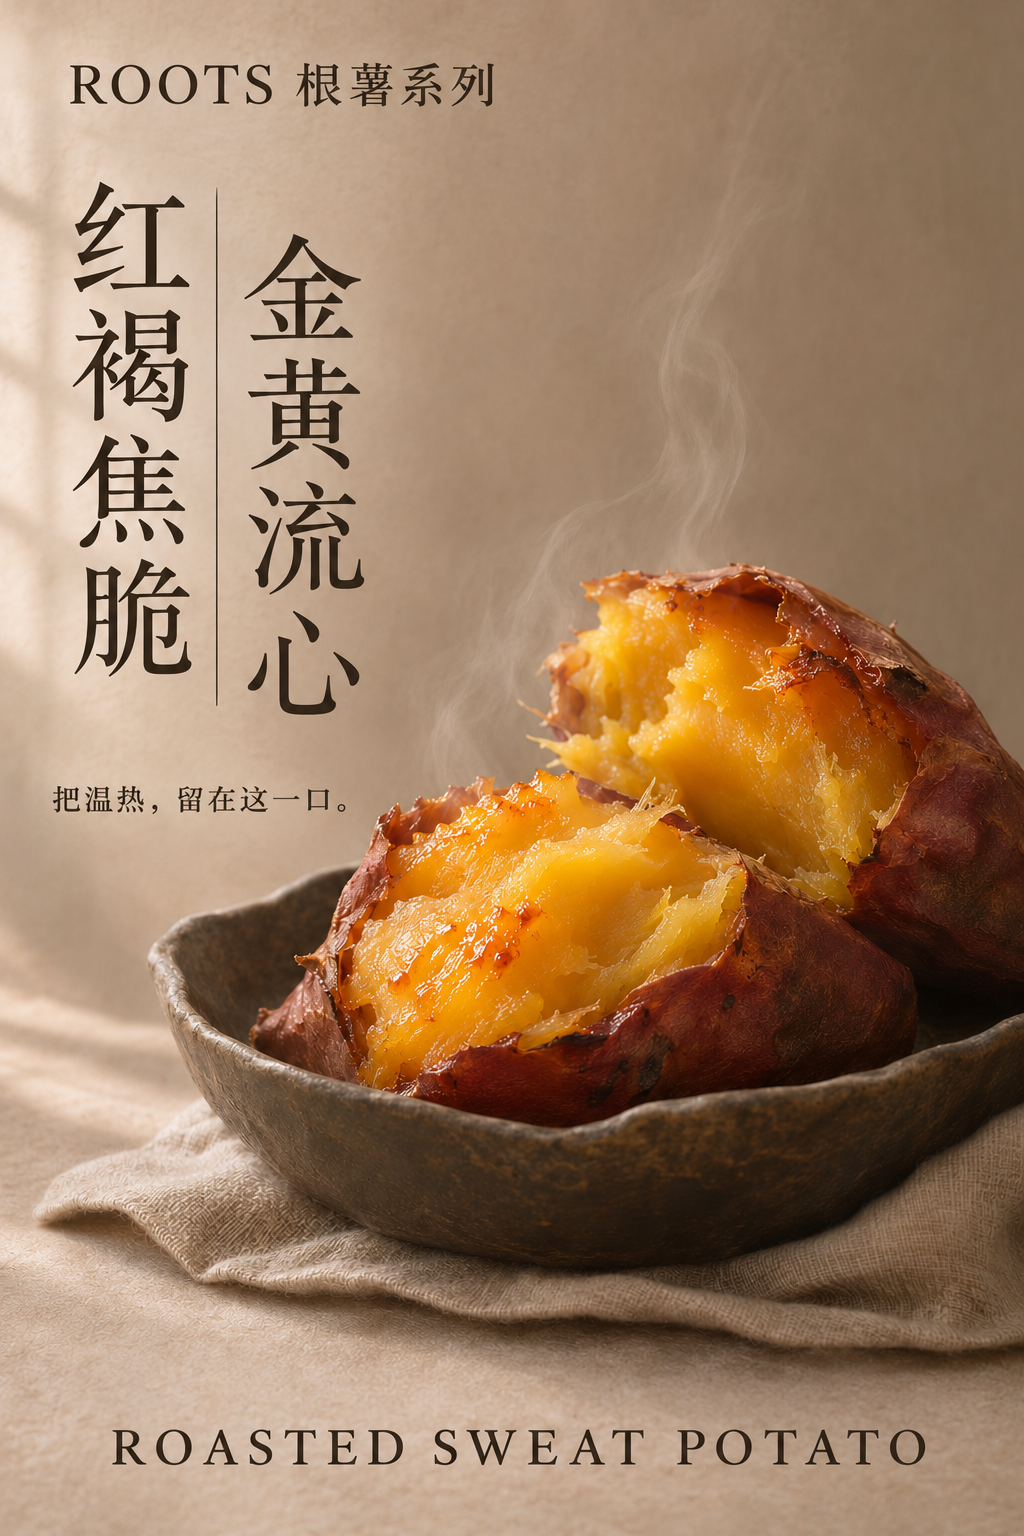
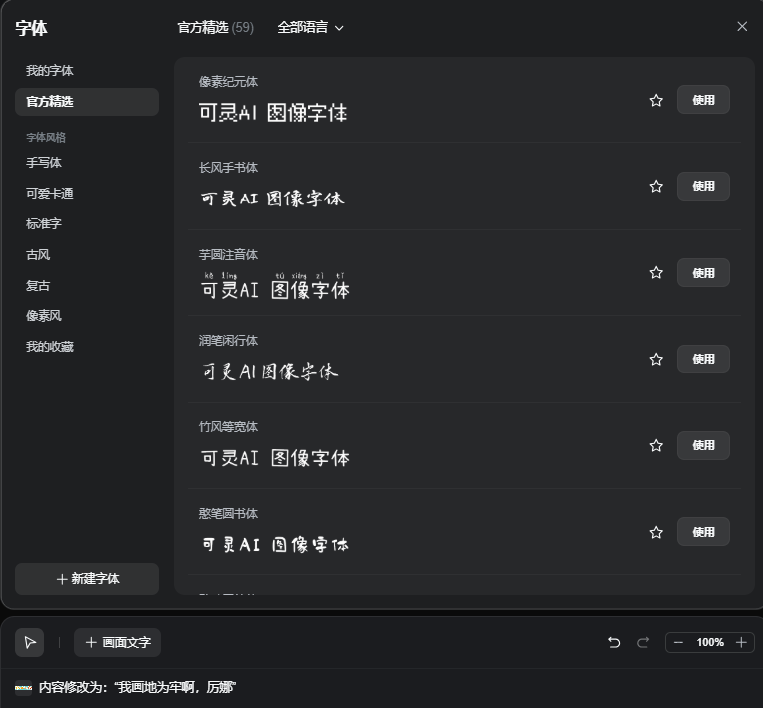
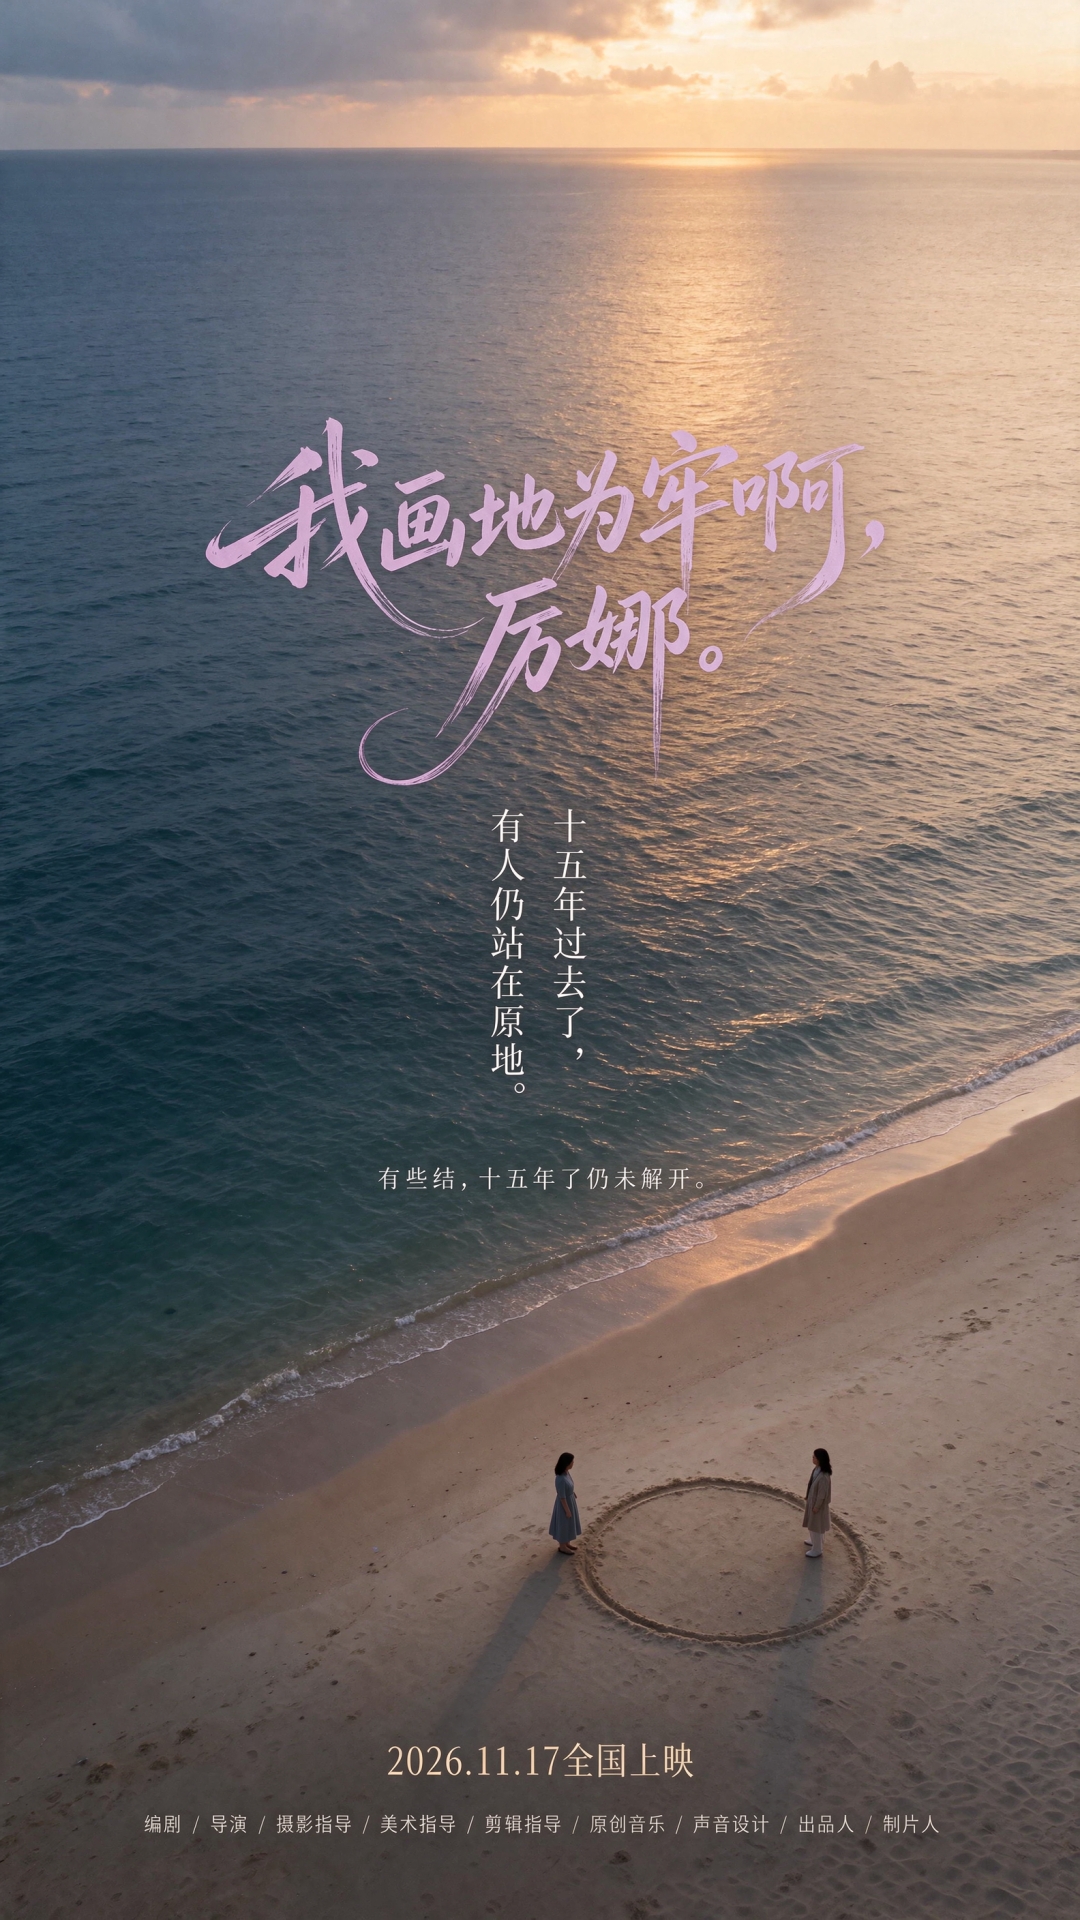
雷峰网实测中,模型根据一张烤红薯照片和简短要求,生成了包含品牌名、广告语及食用场景的电商视觉方案;修改海报文案时,也保留了其余画面。不过,部分说明性小字不够清晰,模型自行补充的产地和产品信息可能不准确。
我们的判断:对小商家和运营团队,它可以成为方案制作工具;文字容量和分辨率并不等于交付质量,发布前仍要逐项核对商品描述与小字清晰度。
研究者称与Claude证明黎曼猜想,成果尚待核验
据报道,Anthropic数学家Levent Alpöge声称与Claude合作找到了黎曼猜想及广义黎曼猜想的证明;这一重大主张仍待严格核验,不能视为已经确认的突破。
Alpöge称,成果目前以Lean代码发布,拆为14个数据包;起始命题是否被准确翻译成代码,仍需专家核对。
随后,斯坦福教授Ravi Vakil公开了Alessandro Masullo的纯人工竞争草稿,约八小时后又更新称,有人在不同AI模型辅助下发现其中的问题。
竞争草稿被指出问题,不能反过来证明Claude协作版本成立;两份论证都需要接受各自的核查。
关于同一项证明主张,另一则报道补充称,Alpöge公开了4页说明及分成14个压缩包的Lean形式化证明文件,成果尚未经过独立验证。他称Claude提出的变换链长度调整方案是推进证明的关键思路之一,并计划整理人类可读证明。
据报道,陶哲轩回应称,理解这份规模庞大、以Lean代码呈现的成果仍需时间;这一回应不代表认可证明。后续应追踪两个具体问题:文件能否独立通过校验,形式化定理是否准确对应黎曼猜想。公开文件只是核验入口,尚不能替代核验结果。
注意:以上为原文披露要点,落地范围以官方材料为准。
蔚山数据中心计划2027年投运,施工人才也是约束
SK集团与亚马逊云科技共同开发的蔚山数据中心,计划于2027年下半年投运,到2029年预计总投资7万亿韩元。按SK此前介绍,首期容量预计到2029年达到103MW,后续还计划扩容近900MW;这些都是建设目标,并非当前可用容量。
韩国总统李在明视察项目时,提出培养数据中心建设工人的需求。报道提到,现场约900人施工,仍面临高端设施建设工人短缺问题。对关注算力供给的团队,投资额和容量规划之外,施工人才及投运进度同样决定资源何时能够使用。
注意:以上为原文披露要点,落地范围以官方材料为准。
清昴发起万卡Token工厂计划,拟2027年推进
清昴智能联合华为昇腾生态及产业伙伴,发起昇腾950DT万卡级Token工厂联合运营计划,拟于2027年推进。计划将分散的国产算力统一调度,按有效Token产出和服务质量交付;清昴负责模型适配、推理优化、调度与计量。
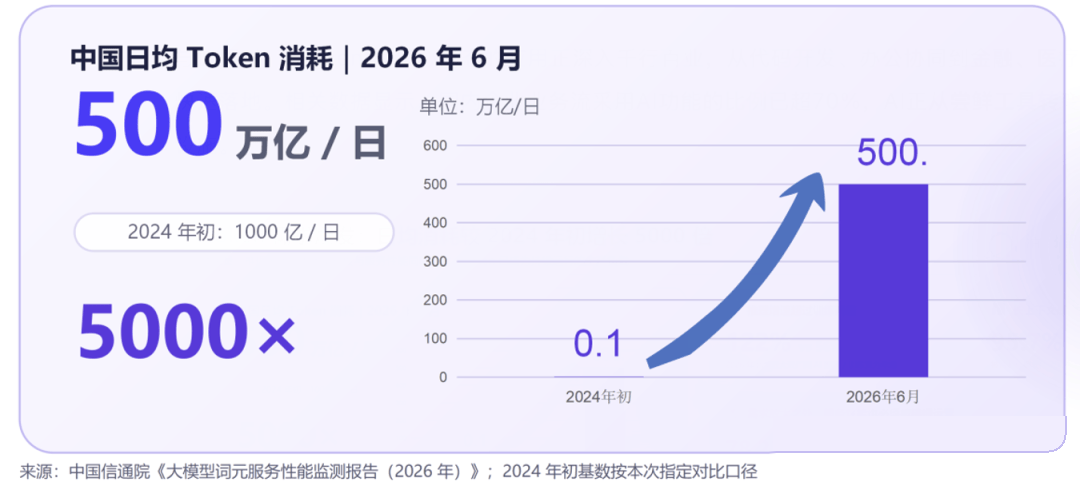
清昴还提出五年扩至十万卡网络,但万卡计划本身仍待推进。对模型和Agent团队,采购判断应落在吞吐、响应时延、稳定性及每百万有效Token成本上;规划卡数不能替代交付验收,跨芯片、跨地域的实际交付效率仍是后续检验重点。
注意:以上为原文披露要点,落地范围以官方材料为准。
OpenAI公布MedChemBench药化基准
OpenAI在X上公布药物化学评测基准MedChemBench,用于衡量AI辅助科学家识别潜在候选药物的能力。公司称,评测显示其前沿模型在这一方向已有进展,这是发布方对结果的判断。
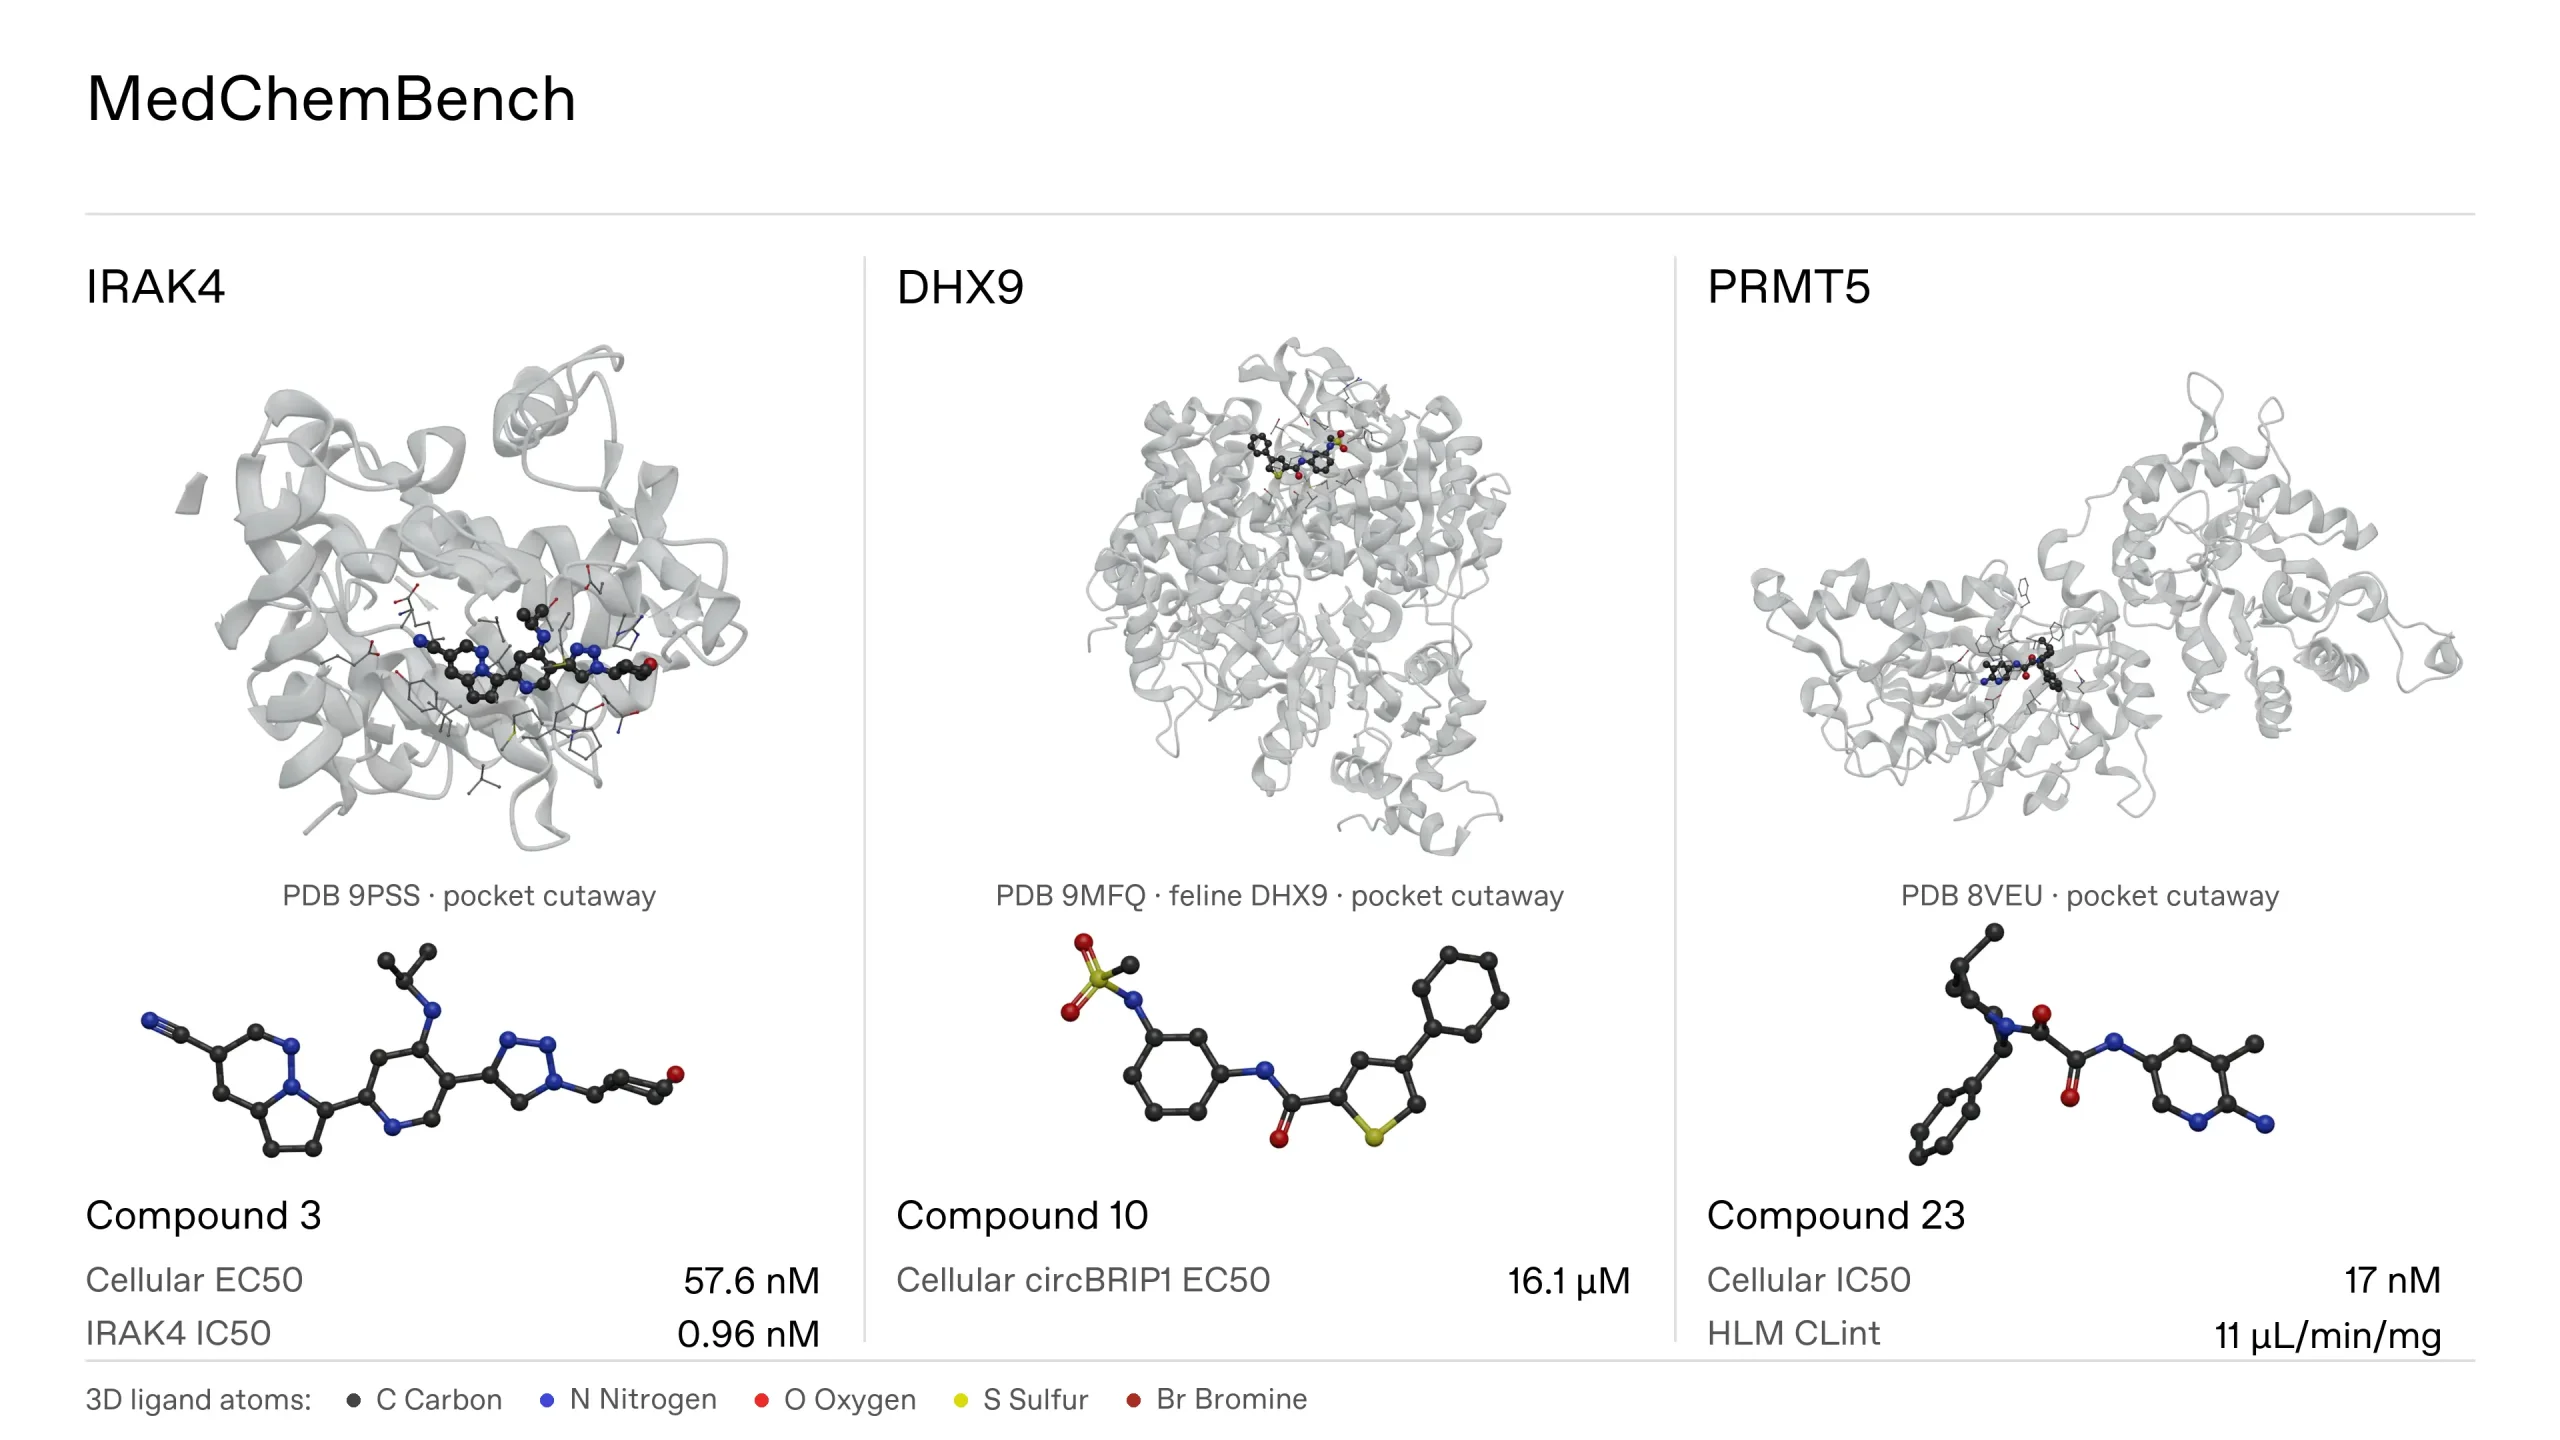
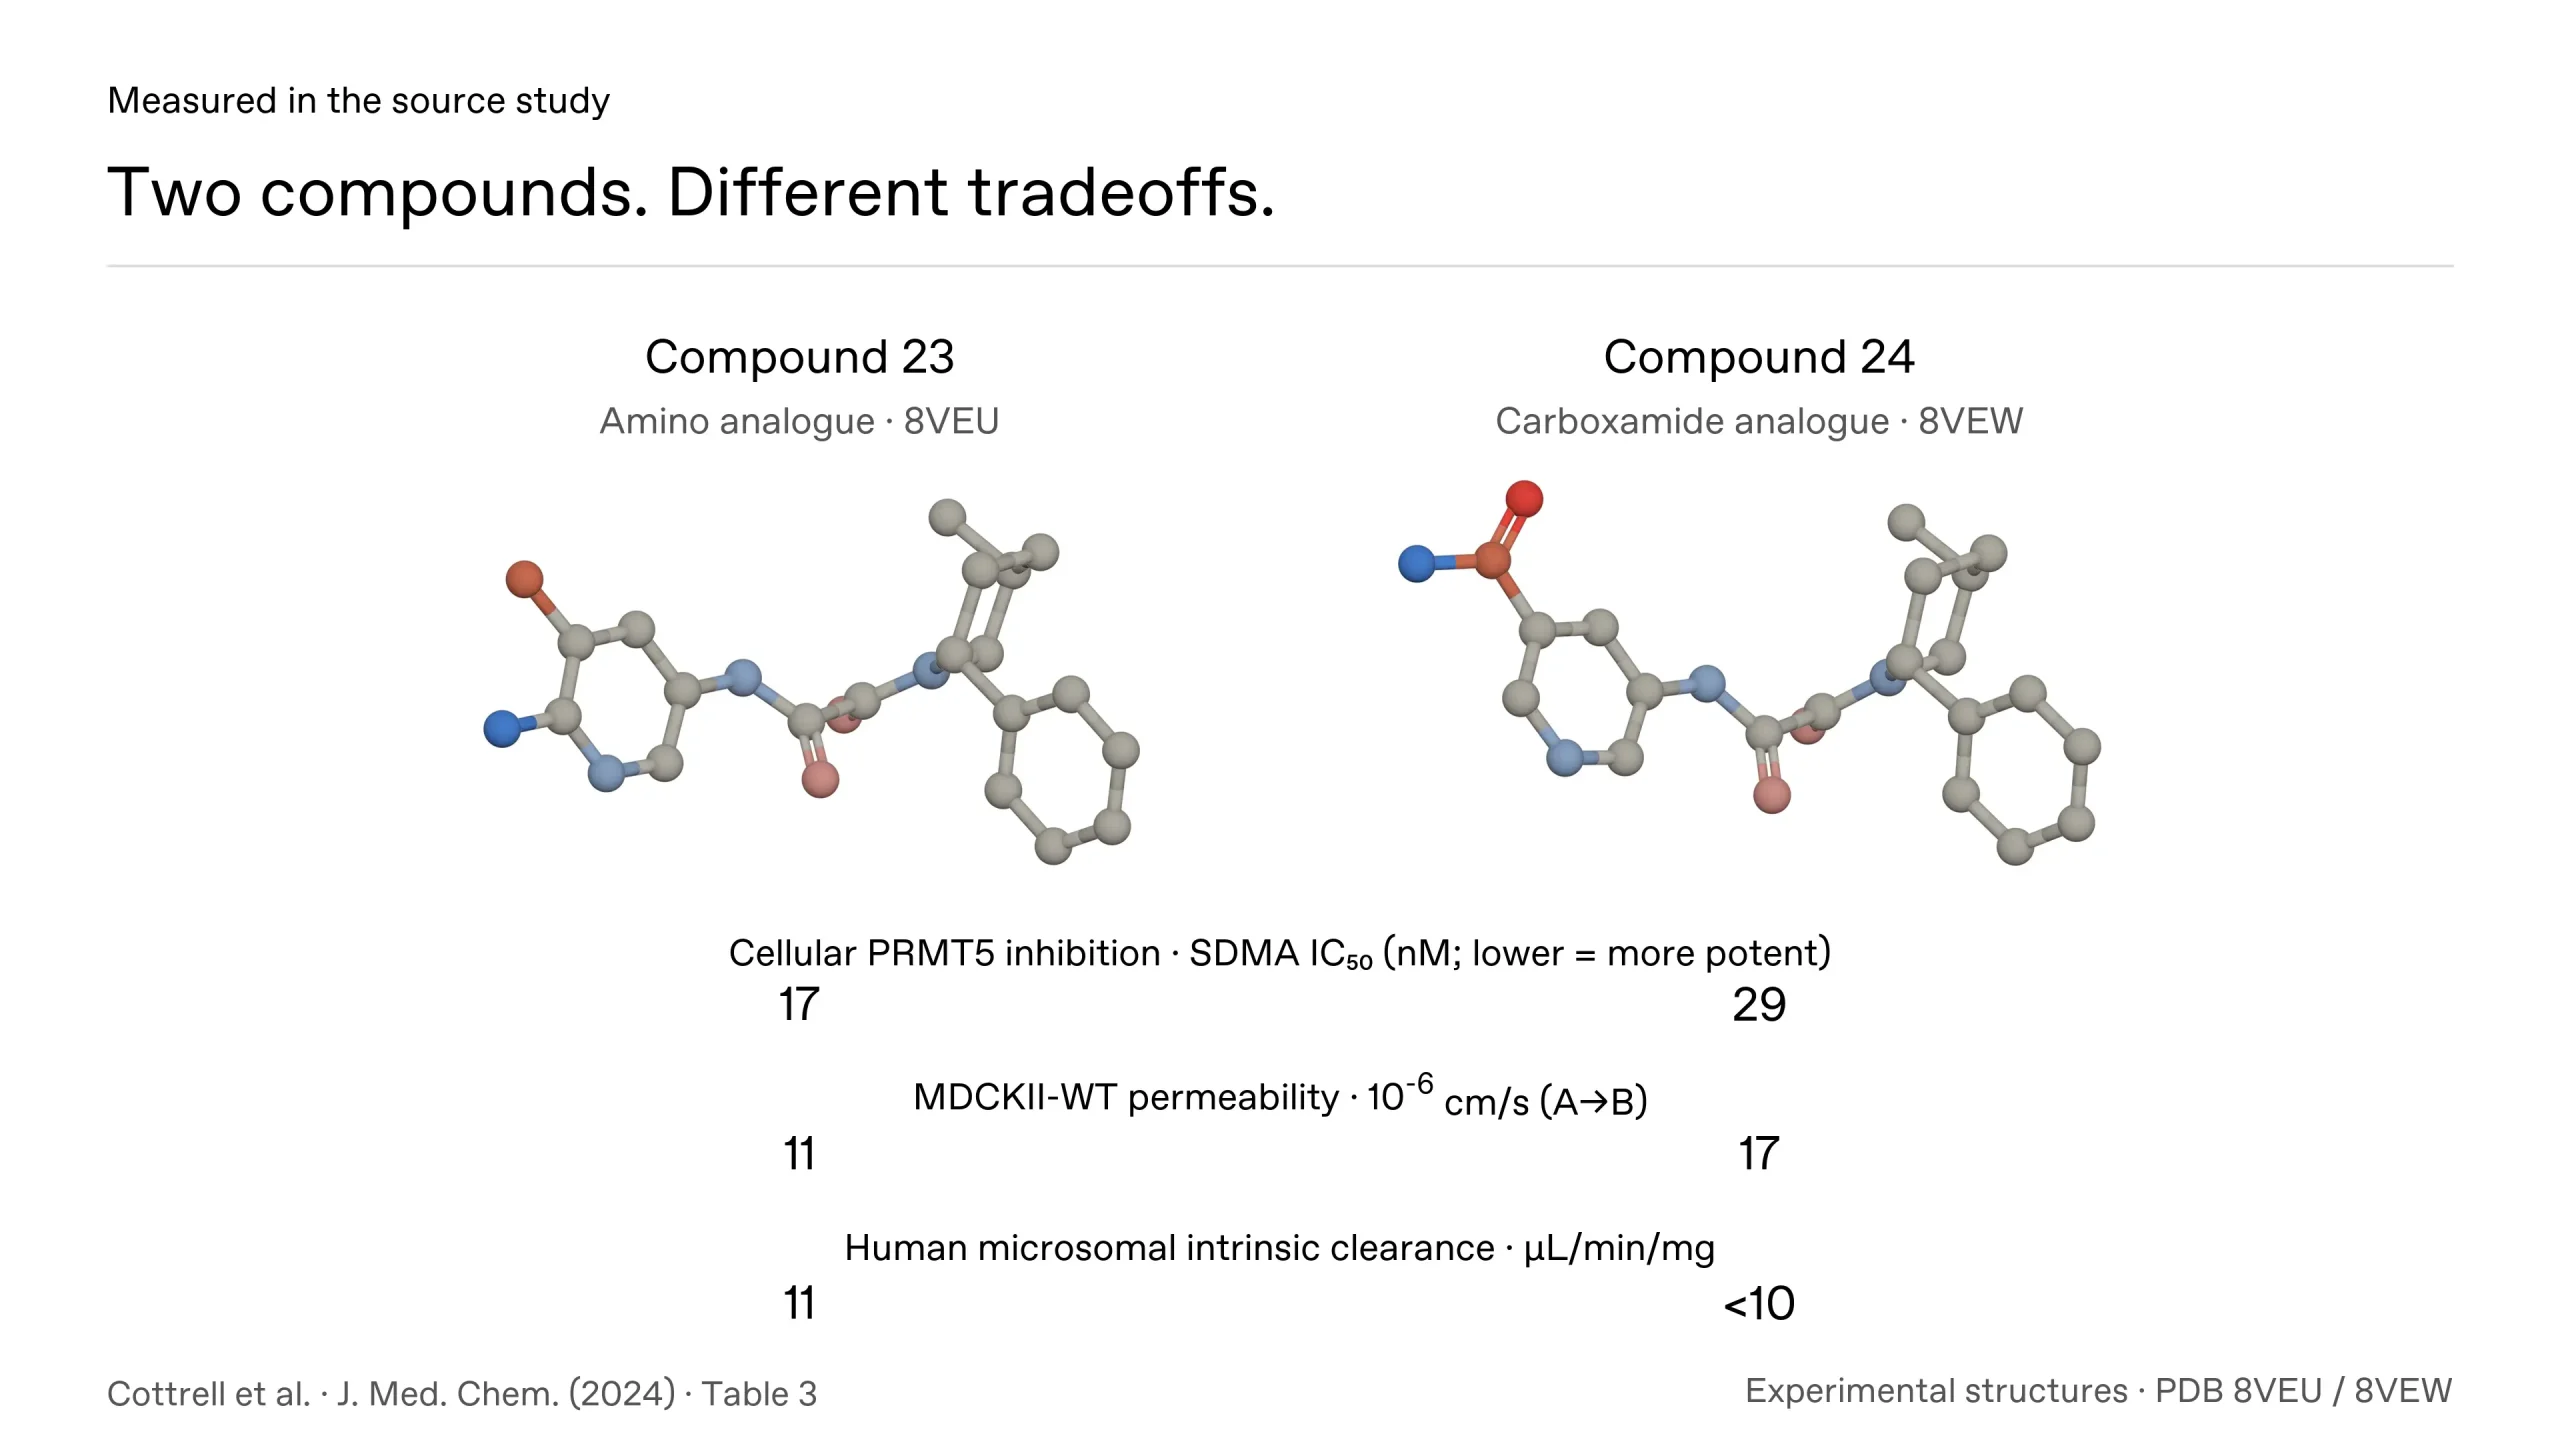
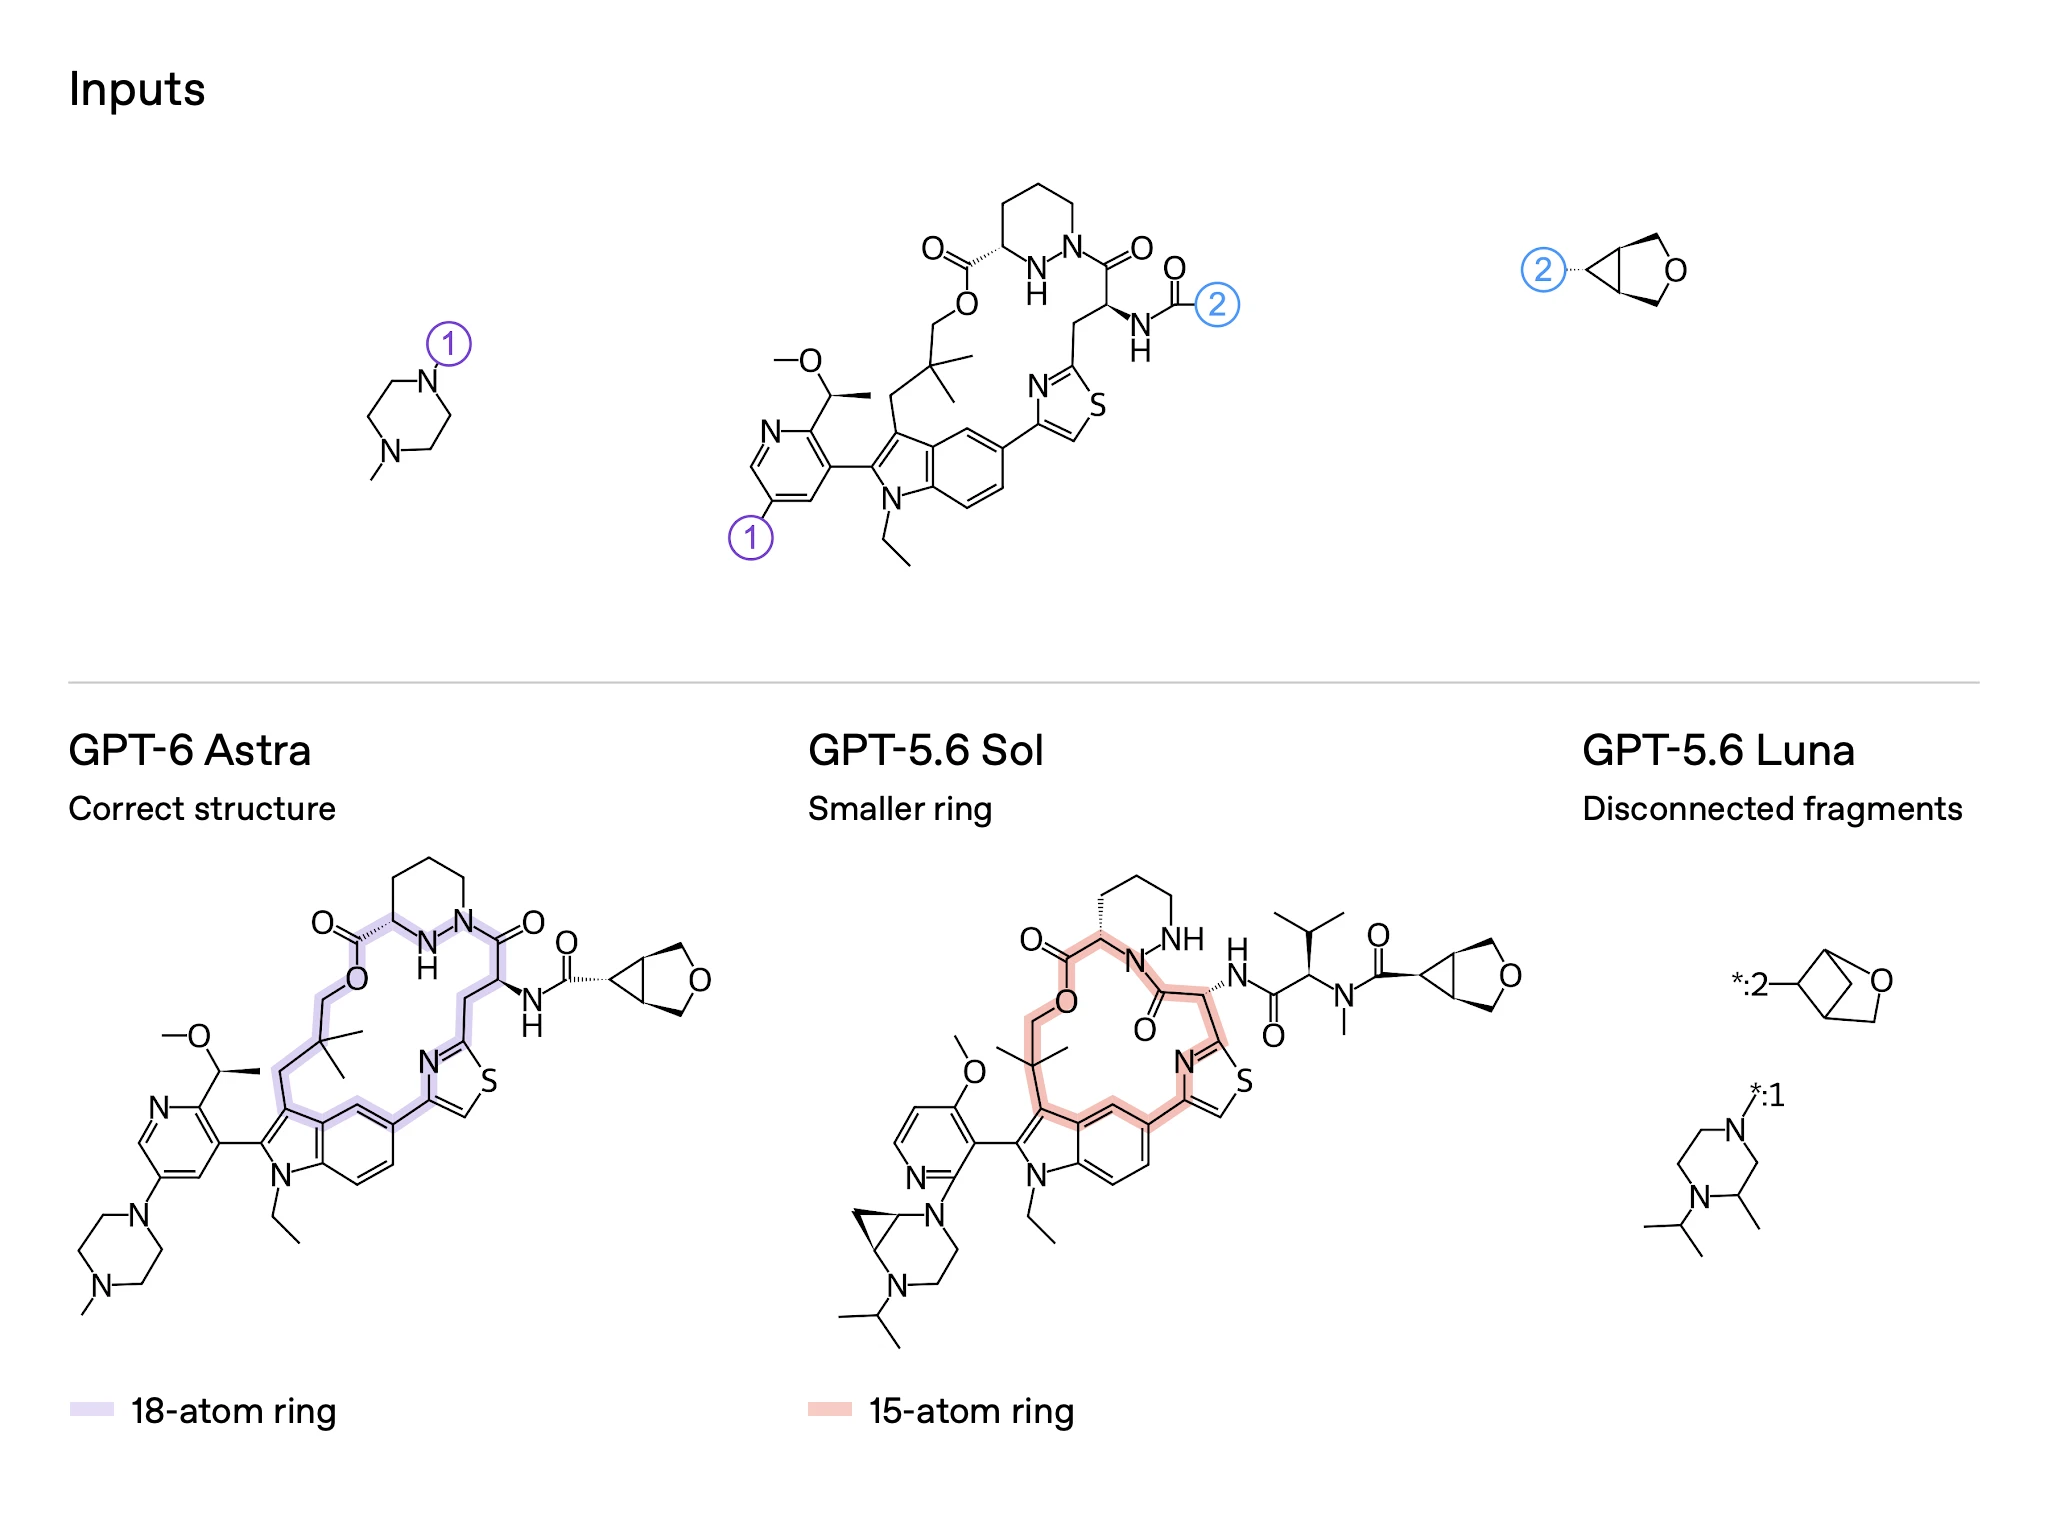
这则帖文仅概述目标,未列出参评模型、具体分数和对比基线,不能单凭公告判断进步幅度。药研团队评估这项基准时,首先需要确认题目是否对应自身研发环节,再判断分数的参考价值;相关任务与成绩在下一条展开。
同一基准的详细介绍显示,MedChemBench从117篇论文和专利中提取99道题,涉及761种分子结构,测试模型结合结构与实验数据解释结果、筛选化合物及预测性质的能力。
OpenAI报告,GPT-6.2 Astra在xhigh推理设置下获得84.5%的分数。
另一模型GPT-6 Astra的结构重建得分为95.4%,但在化合物选择和数值性质预测上仅拿到约一半分数。这组子任务结果不能与GPT-6.2 Astra的总体得分混为一谈,也提示识别结构与选对候选物需要分别评估。
测试基于历史资料,无法排除模型此前接触过来源;每题仅作答一次,未使用工具、反馈或新实验。这些成绩展示了基准任务表现,尚不能证明模型能够发现新药或改善真实实验决策。
注意:以上为原文披露要点,落地范围以官方材料为准。
Inkling 2 Mini开放权重,可本地试用
Thinking Machines发布开放模型Inkling 2 Mini,将24层中的12层连续运行三遍。公司称,这种内部循环计算能延长内部推理而不增加生成文本,减少解题所需的输出token。
据报道,模型总参数264亿,支持文本与图像输入、百万token上下文,采用Apache 2.0许可。
开发者可从Hugging Face下载权重及可调整循环次数的研究版本。Artificial Analysis给出的智能指数为20分,与Qwen3.8 27B持平;按该评测口径,成本约为后者的六分之一、速度约为四倍。
开放权重提供了试用入口,是否适合业务仍取决于本机性能与任务表现。
注意:报道给出的本地运行条件是至少配备32GB内存的Mac,实际速度与资源占用仍需按具体设备验证;上述评测成本与速度不能据此推导本地部署总成本。
参考链接
- OpenAI:OpenAI更新反蒸馏防护,API对话改写也受影响
- X:主线补充:复制能力,未必保留安全防护
- 雷峰网:Kling Image 4.0提高文字容量,商品信息仍需核对
- THE DECODER:研究者声称与Claude证明黎曼猜想,成果尚待核验
- 爱范儿:核验补充:Lean文件公开之后,还要检查它证明了什么
- IT之家:蔚山数据中心计划2027年投运,施工人才也是约束
- 量子位:清昴发起万卡Token工厂计划,拟于2027年推进
- X:OpenAI公布MedChemBench,评测药物化学推理
- OpenAI:评测细节:84.5%得分尚不能推出新药发现成效
- THE DECODER:Inkling 2 Mini开放权重,32GB内存Mac可本地试用


Список комментариев (0 записей):
Показать ещё отзывы Загрузка...