


本文是聚合推荐:把 Open WebUI 放进「本地聊 + 云端备用」「制度 PDF 知识库问答」两条真实路径里看,结论先说——它适合 3–20 人、愿意自己管 Docker 卷的小团队做统一 AI 入口;坑不在安装,而在默认能力面太宽。文末给能照抄的安装、跑通、配置、翻车与验收清单。
项目定位:自托管 AI 工作台,不是玩具聊天页
Open WebUI 把多模型入口、对话、知识库、用户与权限揉进一个 Web 应用。它解决的是「团队里同时有本地模型和云端模型,却不想维护两套聊天页、两套账号」这件事。
不适合三类人:只要一条请求调接口的,直接用官方 SDK 更干净;要把前端交互改到换壳程度的,fork 维护成本会追着你跑,不如自研薄壳;合规要求必须接企业身份源、而你短期确认不了当前版本认证能力的,先别承诺「下周全员上线」。
项目卡片
- 仓库:open-webui/open-webui;文档:docs.openwebui.com
- 形态:Web 前端 + Python 后端,官方镜像在 ghcr.io;常配 Ollama 或任意兼容 OpenAI 协议的接口
- 我关心的能力:统一模型入口、知识库检索带引用、用户组权限、数据全在一个卷里
- 许可:上线前自己去仓库核对当前版本的许可条款与品牌要求,别凭印象
为何我会用到它
我们的处境很典型:涉及客户资料的草稿必须留在本地模型,难题又需要云端大模型兜底;行政想把几十份制度 PDF 变成可问答的助手,但财务制度不能让全员看到。三件事分开做,要两个聊天前端、一套检索服务、一套权限,运维量翻倍。Open WebUI 把它们缝在一起,代价也很明确:卷、密钥、升级、权限都归你自己管,出了事没有厂商兜底。
用例一:Ollama 本地聊 + 云端备用
Ollama 在宿主机跑本地模型,Open WebUI 当前端,再在管理面板里加一个云端连接作备用,用户在下拉框里切换。真正要花心思的不是接线,而是规矩:本地模型答案质量波动大,不写约定,大家会凭感觉切来切去,敏感内容迟早漏到云端。
我们写进团队问答的三条:草稿、内部术语解释走本地;需要强推理或长上下文的难题切云端;含身份证号、未脱敏合同的内容一律禁止进云端模型。配套动作是模型白名单——未审批的模型在用户下拉框里直接隐藏,而不是靠自觉。Ollama 侧先拉一个能在现有显卡上流畅跑的小模型把链路跑通,量化与换卡等跑通之后再谈。
云端备用的接法:Admin Panel › Settings › Connections 里新增一个兼容 OpenAI 协议的连接,填接口地址和密钥。接上后该连接下的所有模型会一股脑出现在列表里,所以紧接着去 Models 把不需要的全部隐藏,只留一个审批过的云端模型,并在模型设置里限定只有「编辑」组可见。这样新同事默认只能用本地模型,敏感内容进云端多了一道人为门槛。成本也要盯:云端按量计费,给这个密钥在服务商后台设月度额度上限,比事后查账单管用。
用例二:制度 PDF 进知识库问答
在 Workspace 的 Knowledge 里建库、上传制度文件、限定可见用户组,对话时用 # 引用该库提问,答案下方会列出来源片段。这条路的成败几乎全由入库材料决定:扫描件识别质量差、表格被拆成碎行,检索就会命中错段落,模型再一本正经地胡说。
我们的入库规矩:只收有文字层的 PDF 或清洗过的 Markdown;扫描件先单独做文字识别,人工抽检表格;按部门可见性拆成多个库,禁止「全公司一个超级库」;每条答案必须能点开来源核对;每周固定抽五个问题复测,引用对不上原文就回头洗语料,而不是调提示词。
检索参数在 Admin Panel › Settings › Documents。三个值最影响效果:分块大小、分块重叠、嵌入模型。制度条款普遍短,分块切得太大,一块里塞进三条规定,答案就会张冠李戴;切得太小,条款和它的例外说明被拆开,答案只说一半。我的做法是先用默认值,拿那五个复测问题跑一遍,命中错位再调小分块、加大重叠,每次只改一个值。注意两点:更换嵌入模型后,已入库的文件要重新处理,旧向量不会自动重算;中文材料优先选对中文友好的嵌入模型,默认模型对中文的召回未必够用。条件允许可以打开混合检索与重排序,对条款编号、专有名词类提问命中率提升明显,代价是每次问答更慢。
权限还有一个容易漏的口子:在 Workspace › Models 里可以做一个「挂了知识库的自定义模型」,比如「财务制度助手」。如果这个模型的可见性设成所有人,那么没有知识库权限的人,也能通过这个模型间接问出财务库里的内容。所以检查权限不能只看知识库本身,还要逐个看挂了知识库的自定义模型分享给了谁。我的规矩是:自定义模型的可见范围永远不大于它所挂知识库的可见范围,上线前拿一个只读账号逐个试问,问得出不该看的内容就是配错了。
优点、缺点与替代
| 需求 | 选 Open WebUI? | 更合适的替代 |
|---|---|---|
| 自托管统一入口 + 轻量知识库 | 是,甜区 | — |
| 只在本机和本地模型聊 | 偏重 | Ollama 自带客户端或轻量桌面前端 |
| 程序里调模型 | 否 | 官方 SDK |
| 强审计、单点登录、上百人 | 先评估 | 企业门户或自研网关 |
优点:统一入口上手快;知识库加用户组权限对小团队够用;社区活跃,接新模型快。缺点:功能面宽、默认开得多,误配成本高;版本迭代快,升级可能改动设置项与数据结构;插件与工具的安全边界要自己把关。一句话:超出甜区硬撑,升级与权限会吃掉你的周末。
今晚装上并收窄默认能力面
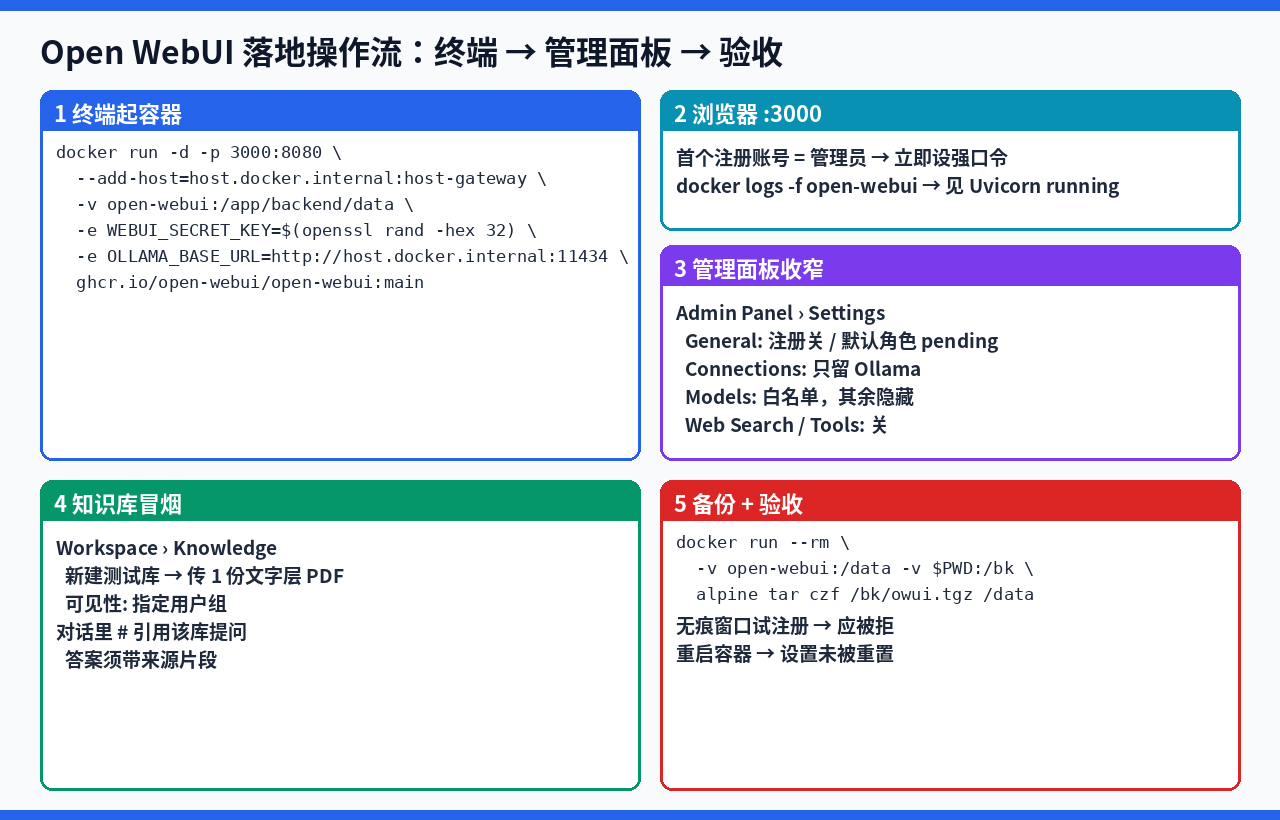
下面五步按顺序做,每步都有能看见的结果,做不出结果就停在那一步排查,别往下堆。
① 安装
Linux 宿主机,Ollama 已在本机运行。生产环境建议把 main 换成发布页上的具体版本标签,升级才可回滚:
docker run -d -p 3000:8080 \
  --add-host=host.docker.internal:host-gateway \
  -v open-webui:/app/backend/data \
  -e WEBUI_SECRET_KEY="$(openssl rand -hex 32)" \
  -e OLLAMA_BASE_URL=http://host.docker.internal:11434 \
  --restart always --name open-webui \
  ghcr.io/open-webui/open-webui:main
密钥生成后记进密码管理器,下次重建容器沿用同一个值,否则已登录的会话会全部失效。任何密钥都不写进镜像、不提交到 git。
② 跑通
docker logs -f open-webui 看到服务启动日志后,执行 curl -s localhost:3000/health 应返回状态为真的结果。浏览器打开 3000 端口,第一个注册的账号就是管理员——所以装完立刻自己注册,别把地址先发群里。然后在模型下拉框选本地模型,发一句话,能回就算链路通。
③ 配置:收窄默认能力面
- Admin Panel › Settings › General:关闭新用户注册,或保持开启但默认角色设为 pending(待审批)。
- Connections:今晚只留 Ollama 一个连接,云端连接明天审批后再加。
- Models:只放行审批过的模型,其余隐藏。
- 联网搜索、代码执行、工具与函数:全部关闭,以后按工单逐个开,并记录会不会把数据带出内网。
- Users › Groups:建「只读」「编辑」两个组,新同事默认进只读,培训后再升级。
- Workspace › Knowledge:建一个测试库,只传一份已清洗的制度 PDF,可见性设为指定用户组;用 # 引用提一个原文里有答案的问题,确认来源片段对得上。
④ 翻车点
- 没挂卷:数据写在容器可写层,删容器升级后对话、账号、知识库全丢。命令里的
-v一个字都不能省。 - 连不上 Ollama:Ollama 默认只监听 127.0.0.1,容器经 host.docker.internal 访问会被拒。给 Ollama 设
OLLAMA_HOST=0.0.0.0后重启,再用防火墙挡住 11434 的外网访问。 - 改环境变量不生效:不少设置首次启动后会存进数据库,之后以管理面板里的值为准。改配置优先去管理面板,别反复重建容器碰运气。
- 默认全开:测试同学随手开了联网搜索,制度问答里混进公网噪声,还被当成内部规定转发。这就是第③步要和安装同级对待的原因。
- 升级重置:大版本升级后要复查注册开关、模型白名单和知识库可见性,别默认它们还在。
⑤ 验收
先备份,再验收:
docker run --rm -v open-webui:/data -v "$PWD":/bk \
  alpine tar czf /bk/owui-$(date +%F).tgz -C /data .
六项全勾才对全员开放:本地模型能聊;知识库答案带可核对的来源;无痕窗口试注册被拒或进入待审批;只读账号不能上传、不能改设置;docker restart open-webui 后以上设置都还在;备份包已存到另一台机器,密钥不在任何仓库里。以后每次升级,先在演练环境用同一份备份恢复、升级、跑五问复测,通过了再动生产。
升级与恢复各留一条命令在运维笔记里。升级:docker pull 新镜像,docker stop 并 docker rm 旧容器,再用第①步同一条命令、同一个卷、同一个密钥启动——卷还在,数据就还在。恢复:先停容器,再用 alpine 容器把备份包解压回 open-webui 卷,最后启动。恢复至少演练一次,没演练过的备份等于没有备份。
最后是人的部分。开放前给团队做一次三十分钟培训,只讲四件事:怎么选模型、什么内容禁止贴进云端模型、怎么点开来源核对答案、发现胡答去哪里上报。胡答上报收集到一个表里,每周复测时一起过,这张表就是你下一轮洗语料和调参数的需求清单。


Список комментариев (0 записей):
Показать ещё отзывы Загрузка...