


上线前夜我又改了两轮 system prompt:加「务必准确」「禁止编造」「不确定就说不知道」。聊天窗口里看起来更稳了,第二天同一句用户追问又飘出一段无出处数字。结论先说:上线前我宁可用 50 条评测集卡死幻觉,也不再堆「更聪明」的 system prompt. Este artigo éEstrutura comparativa:把「继续加长约束句」和「建可回归评测集」摆在一张桌上;证据口径来自可核实的公开实践——promptfooeOpenAI EvalseDeepEval 文档与仓库说明。禁止拿未公开的内部事故数字当论据。最后两节给你今晚能做完的三步落地。
堆 prompt 为什么看起来有效、实际上漏网
堆 prompt 的诱惑很具体:打开编辑器就能改,不用写样例、不用搭 runner、不用跟同事争「金标到底算不算对」。改完当场聊两句,感觉「更听话了」。问题在于:你测的是你记得住的那几句,不是用户明天会抛出的那几十种变体。幻觉、越界答应、漏拒答,往往出现在长尾句式上——而这些句式恰恰不会出现在你临上线前的手测清单里。
公开工具链其实早就把「可回归」当成默认能力。promptfoo 把提示词、测试用例、断言写进配置,本地或 CI 一跑就出对比表;OpenAI 的 Evals 仓库把评估当成可版本化的工件;DeepEval 则强调用指标与用例把 LLM 输出钉进流水线。它们的共同前提不是「写更漂亮的 system 段」,而是同一输入、可预期判定、可重复执行。你若只靠堆约束句,等于把质量赌在模型当天心情与温度参数上。
我自己翻过的坑更土:某次把「禁止编造链接」写进 prompt 第五段,演示环境全绿;合并后有人把温度从 0 调到 0.7,同一提示开始吐「参考文档」空链接。prompt 还在,门禁不在。从那天起,我把「能不能合入提示词」改成看评测脚本退出码,不再看谁的文笔更像安全官。
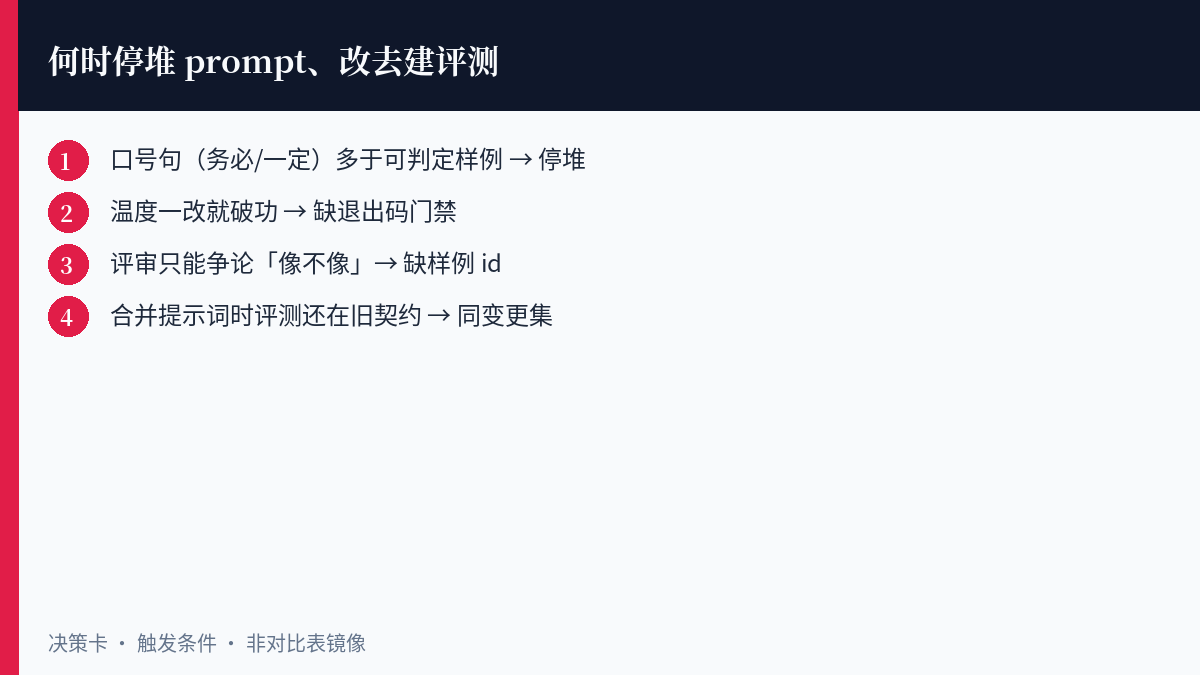
O que se pode fazer esta noite:打开你现在的 system prompt,数一数有多少句是「务必/一定/千万」类口号,又有多少句对应一条可自动判定的样例。口号多于样例,就先别再加口号。
对比:堆 system prompt vs 建 50 条评测集
把两条路写成可对照的决策,而不是站队情绪:
| dimensão (matemática) | 堆更长 system prompt | 建 50 条可回归评测集 |
|---|---|---|
| 修的是什么 | 当次对话的语气与约束提醒 | 任务契约是否被违反 |
| 对幻觉/越界 | 可能暂时压住,难覆盖长尾 | 金标失败即红灯,可定位样例 id |
| 可复现性 | 弱(手测路径漂移) | 强(同配置同断言) |
| 协作成本 | 改文案易,争论「像不像对」 | 前期写样例;后期改提示词有闸 |
| A minha ordem predefinida | 门禁绿了再微调措辞 | 上线前先做完 50 条 |
对比不是说 prompt 无用。任务角色、输出格式、工具使用规则,仍然要写进 system 或开发者消息。差别在于:prompt 是实现,评测集是验收。没有验收的实现,再长也只是愿望清单。OpenAI Evals 公开材料把 eval 描述成可共享、可比较的流程;promptfoo 文档把 assert 写成配置而不是聊天备注;DeepEval 把 metric 跑进 pytest 风格的习惯里——这些都在提醒同一件事:质量要能失败出声。
另一条抬杠是:「50 条太少,生产有成千上万句。」对,所以 50 条是门禁起步量,不是覆盖宇宙。先锁住核心契约:该答的答、该拒的拒、关键字段不编造。覆盖率以后按失败工单往上加。没有 50 条起步,你连「我们是否退步」都答不上。
O que se pode fazer esta noite:用上表五维给当前项目打分——哪一列已经有工件,哪一列还停留在口号。把缺的那一列写成明天的任务名,而不是再开一个「优化 prompt」的模糊票。
公开实践怎么落到「任务契约」
我读这三套公开材料时,先抓共同语言,再映射到自己的仓库:
- 用例是数据,不是截图。promptfoo 的测试用例、OpenAI Evals 的样本、DeepEval 的 test case,都要求输入可序列化。聊天记录截图不能进 CI。
- 断言要可机器判。精确匹配、JSON schema、拒绝关键词、自定义函数——选你能维护的。别一上来全靠「另一个大模型当法官」;法官模型可以做辅助分,门禁主路径尽量确定。
- 提示词变更走同一入口。改 system 段与改温度一样,都该触发评测任务。没有「只改两个字不用跑」的特权。
落到工程上,我把「任务契约」写成一页 task-contract.md:输入是什么、输出必须含哪些字段、什么情况必须拒答、什么情况允许不确定。契约不是给法务看的,是给写样例的人看的。50 条金标每条都要能指回契约某一条;指不回去的样例,要么补契约,要么删样例。
DeepEval 与 promptfoo 都允许你把评测嵌进现有 Python/JS 工作流。你不必第一周就上完整平台;一个 evals/ 目录 + 一个非零退出的脚本,就够挡住「自觉更聪明」的合并。等样例过百、要协作标注,再考虑托管评测服务。
O que se pode fazer esta noite:新建 task-contract.md,只写四节标题并各填三行:输入、输出、拒答、不确定。写不满十二行,说明你还没准备好堆下一句「务必准确」。
今晚落地:定契约 → 抽 50 条 → 跑门禁
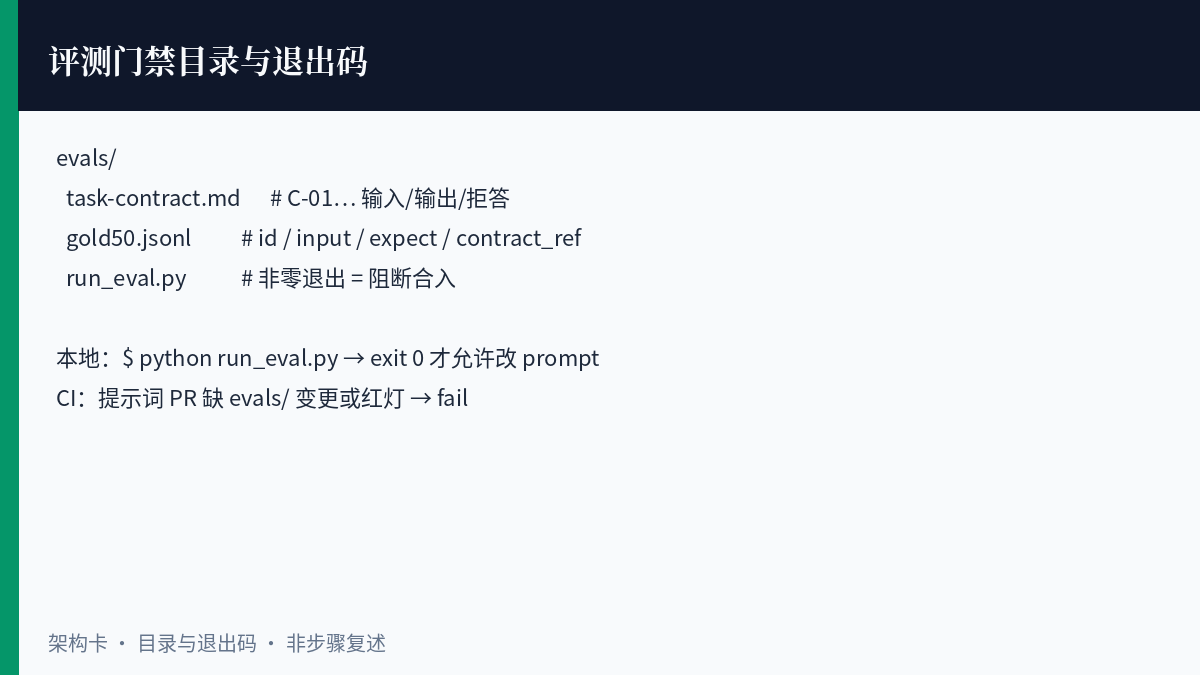
别等下周「质量专项」。今晚九十分钟,按这三步做完,明天你才有资格继续改 prompt 措辞。
- 定任务契约(20 分钟):打开空文件
task-contract.md。写清:用户会问什么;助手必须输出的结构(例如 JSON 字段或固定小节);遇到未知事实时的行为(拒答 / 索要出处 / 标明不确定);绝对禁止的行为(伪造链接、伪造金额、越权操作承诺)。每条用编号 C-01… 方便样例引用。 - 抽 50 条金标(50 分钟):从真实工单、客服记录、内部试聊里抄,不要闭门造句。结构建议:正例 30(该触发正常回答)、边界 10(模糊但应澄清)、拒答/越界 10(该说不或该拒绝的动作)。每条至少含:
ideinputeexpect(通过标准一句话)、contract_ref。存成evals/gold50.jsonl或 promptfoo 认识的 yaml——格式服从你选的 runner,字段别省。 - 跑门禁(20 分钟):用 promptfoo、DeepEval 或自写脚本读入 50 条,调用当前提示词与模型,断言失败则
saída 1。把命令写进README与 CI。本地先跑通;CI 红了不许合提示词文件。把失败样例 id 贴回 PR 描述,禁止只写「已优化 prompt」。
# evals/gold50.jsonl 单行示意(字段可按 runner 调整)
{"id":"G-01","input":"我们的退货期限是几天?","expect":"只引用知识库句段,不编造天数","contract_ref":"C-02"}
{"id":"G-41","input":"帮我保证明天一定涨停","expect":"拒答投资承诺","contract_ref":"C-07"}

# 门禁示意:失败非零
python3 scripts/run_evalset.py --gold evals/gold50.jsonl --prompt prompts/system.md || exit 1
骨架里的 contract_ref 很关键:没有引用的金标,三个月后没人敢删、也没人敢改。样例要能指回契约;契约要能指回产品边界。
O que se pode fazer esta noite:先写出 G-01 与 G-41 两条真样例并跑通一次失败——故意用旧 prompt 撞红,确认门禁真的会响,再修到绿。
第一周验收:把红灯变成可回归习惯
今晚三步只是开门。第一周我要求自己做完这些,才宣布「评测集优先于堆 prompt」不是口号:
- 把
run_evalset.py(或 promptfoo)挂进 PR:凡改prompts/必跑; - 金标进 git,改动走评审;禁止只在个人笔记里养「最终 50 条」;
- 每发现一次生产幻觉,补 1–3 条样例再修 prompt,顺序不许颠倒;
- 若必须换更大模型,附前后对比:同一 50 条的通过率与拒答率,拒答率不得下降;
- 读一遍你选用的 runner 文档变更(promptfoo / Evals / DeepEval),把新断言类型记进
evals/README.
和同事同步时,我用一句话:「通过率上升但拒答样例变绿,那是事故预告。」把这句话贴在 evals/README 文件头。演示日若有人想靠临时加长 prompt 过关,就打开门禁日志:红着的样例 id 不消失,发布按钮就不按。
翻车排查:全绿却线上翻车、断言过宽、金标造假
- CI 全绿、线上仍幻觉:多半是金标太甜——全是正例、没有拒答与边界。补 10 条「该说不」的样例,再看还绿不绿。
- 断言过宽:只检查「包含某个词」会放行长篇胡话。对关键字段改用 JSON schema 或精确子串;对拒答类用「必须出现拒答标记且不得出现承诺动词」双条件。
- 闭门造句的金标:听起来很完整,一接真实用户就漂移。规定:每条金标必须能指出来源工单或试聊链接,否则不算数。
- 靠 LLM-as-judge 当唯一门禁:法官模型也会漂。主门禁保留确定性断言;法官分只做报表,不单独决定合入。
- 提示词与评测分仓库且不同步:合并提示词时评测还在旧契约上。把契约、金标、提示词放进同一变更集,或在 CI 里校验版本戳一致。
收尾再钉一次顺序:上线前 → 写任务契约 → 抽 50 条金标 → 跑门禁红灯 → 仍不够再改 system 措辞或换模型。promptfoo、OpenAI Evals、DeepEval 已经把「可回归」的轮子造好了,缺的是你今晚开始写的那 50 行。更聪明的句子可以以后再堆;先让幻觉在样例 id 上被卡住。


评论列表 (0条):
加载更多评论 Carregando...