


本文是同输入横评:同一份中文扫描《差旅与报销制度》PDF,分别丢给 MarkItDowneDoclingeUnstructured,看转出来的 Markdown 能不能直接喂检索。结论先说:离线快转优先 MarkItDown;复杂表和扫描件 Docling 更扛;已有企业解析流水线再上 Unstructured。前半讲怎么测与谁适合什么场景;文末是选定后的命令、文件级路由与验收——少神话,不把一次样本写成永久排行榜。
怎么测
测试件约四十页,含合并单元格薪资补助表、盖章页、页眉页脚。选它不是因为「代表全世界文档」,而是因为它够脏:既有可抽的条款句,也有一碰就散的表。验收题固定十条,全部来自同事真实口语,例如「过夜费上限」「跨城交通能否报网约车」「发票丢失怎么办」「补助表里实习生有没有夜班补贴」。评分只看三件事:条款能否被检索命中、表格数字是否错位、标题层级是否乱到无法引用。
环境都在同一台笔记本电脑本地跑,尽量跟官方 README 的默认安装走,不专门给某一家开小灶调参。版本会变,所以本文不锁死次要版本号;你复现时以各仓库当前文档为准。测完我只保留「默认路径下的体感」,不把它写成实验室排行榜。为了减少自己骗自己,十条题在转换前就写进表格,转换后只许填命中与否,不许改题干。
另外约定:不测云端 SaaS 专属增强,不测付费 OCR 插件。要比就比开源默认能力,否则苹果和火箭没法放一张表。时间记录只做参考:我更关心「第一次装完到跑出第一份 MD」的摩擦,而不是压测吞吐量——个人选型阶段,摩擦才是真实成本。原始打分表留在项目笔记里,横向比较时只引用同一天的那次跑分,避免「印象分」混进来。
横评结果
| dimensão (matemática) | MarkItDown | Docling | Unstructured |
|---|---|---|---|
| 安装与上手 | 轻,pip 后能转 | 稍重,文档清晰 | 组件多,流水线味浓 |
| 纯文本条款 | 够用,命中率高 | 稳 | 稳,偏分片 |
| 扫描合并表 | 易散、数字错位 | 结构保留更好 | 可,看策略与模型 |
| 速度体感 | 快 | médio | 随管道变化大 |
| 适合角色 | 个人快转喂 LLM | 文档理解/难表 | 已有解析中台 |
十条验收题上,MarkItDown 在纯条款类命中 8/10,栽在两道表内数字题;Docling 表题明显好于前者,总命中 9/10;Unstructured 在我默认分区策略下条款命中尚可,但要达到同样表结构,我花在策略配置上的时间更长。数字仅描述本次样本,换一份医疗影像报告或工程图纸,结论可能对调。
还有一个不进总分、但我很在意的观察:MarkItDown 的输出最容易被同事直接打开阅读;Docling 更适合进后续结构化处理;Unstructured 的分片结果更像「给管道的中间态」。面向人读和面向机器管道,不是同一需求。和开源专栏那篇 MarkItDown 实测的分工:专栏讲安装与用例细节;本篇只做同输入横评。两篇可对照读,但不要把横评分数当成对某一仓库的永久盖章——上游一周一个版本是常态。
三家各自适合谁(按场景聚合)
MarkItDown(microsoft/markitdown):目标很明确——把杂格式变成给 LLM 吃的 Markdown。办公 docx/pptx/xlsx 很香,扫描大表别硬扛。适合「先看见模型读什么」,再决定要不要升级工具链。对我这种经常要在当天给出可读样例的人,它是默认第一站。
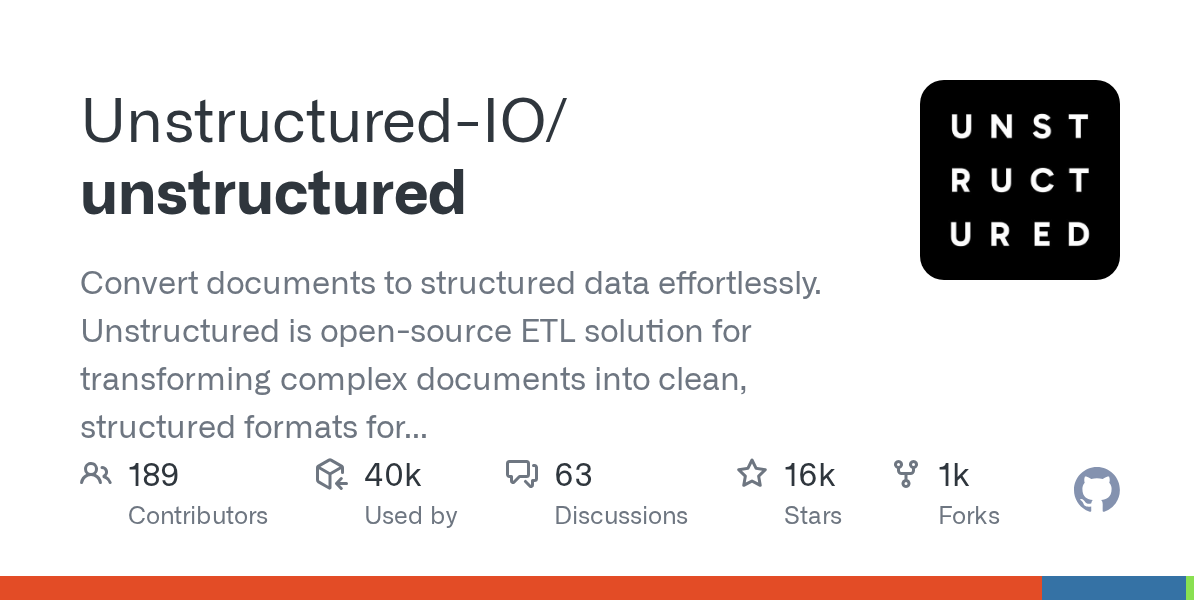
Docling:更像文档理解流水线,版面、表、阅读顺序是一等公民。官方文档里的 processing 示意图也能看出它不是「转一下就走」。代价是环境和耗时都更重一点。我的用法是:MarkItDown 失败的文件名单进 Docling,而不是一上来全量重型。路由比信仰省钱。
Unstructured:生态大,分区、分片、与下游 RAG 组件的连接多。若团队已经在用它的管道,为了横评再换栈不划算。若你是一个人从零开始,先别把它当第一站——配置自由度会吞掉你的试水周。自由度数过高时,默认路径的意义就是:承认自己还没资格调参。
三家都不是「文档理解终结者」。真实工作里你要的是一张失败文件名单和一条升级路径。选型口诀只有一句:先看失败文件比例,再看团队会不会维护管道。工具榜单分数解决不了「谁值夜班改配置」。若客户只要「能搜到条款」,我会在报价里写清:转换层验收过了才进入对话层。转换没过关就做聊天窗,等于花钱买自信的胡话。
选定后怎么落地:命令、路由、验收
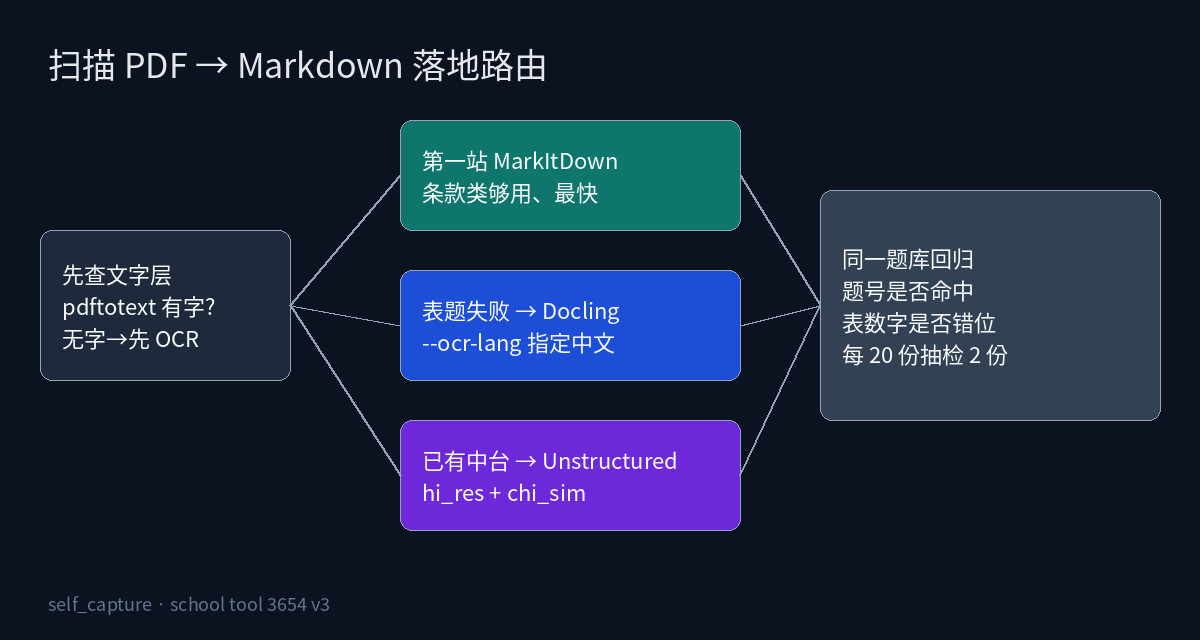
这一节是正文重心。对照路由图:先查文字层;第一站 MarkItDown;表题失败升级 Docling;已有中台跟 Unstructured;三条路都回归同一题库,只记命中与错位。
1)最小命令(以各仓库当前 README 为准)
mkdir -p out/markitdown out/docling out/unstructured

# MarkItDown
pip install "markitdown[all]"
markitdown 差旅制度.pdf -o out/markitdown/差旅制度.md

# 0. 先查文字层:输出为空说明是纯图片扫描件
pdftotext 差旅制度.pdf - | head -20
ocrmypdf -l chi_sim 差旅制度.pdf 差旅制度.ocr.pdf   # 无字时先补文字层(需装 tesseract 中文包)

# Docling(文档理解向,扫描件指定中文 OCR)
pip install docling
docling 差旅制度.pdf --to md --ocr-lang ch_sim --output out/docling/

# Unstructured(已有中台时跟组织配置;单机试跑如下)
pip install "unstructured[pdf]"
python -c "from unstructured.partition.pdf import partition_pdf; els = partition_pdf('差旅制度.pdf', strategy='hi_res', languages=['chi_sim']); open('out/unstructured/差旅制度.md','w').write('\n\n'.join(e.text for e in els))"
落地时我会把命令写成 Makefile 或小脚本,文件名带工具名:out/markitdown/差旅制度.md。对比时用 diff 看标题层级,用检索脚本跑同一题库。人肉左右开两扇窗口盯着看,十分钟后就会开始「觉得都差不多」——一觉得差不多,实验就死了。
2)文件级路由(别堆不可维护的 if-else)
- 日常制度、会议纪要、培训 PPT:走 MarkItDown。
- 扫描合同附件、工资补贴表、多栏排版,或 MarkItDown 表题失败:走 Docling。
- 公司已经指定 Unstructured 且有人维护管道:跟组织走,把验收题带进 CI,而不是私下再养一套。
切块策略也要跟着工具走,别一套参数通吃。MarkItDown 的输出标题层级较平,我按二级标题加固定字数切块,再把条款编号拼进每块开头,检索时才不会只命中半句话。Docling 保留了表格结构,我会把整张表单独作为一块,并在块首补一句表名和所在章节,避免模型把补助表里的数字和正文条款混在一起回答。Unstructured 本身已经按元素分区,我只做合并相邻短元素这一步,不再二次重切。这些后处理都写进同一个脚本,按工具名分支,改动时三家一起回归那十道题。
3)验收清单与三个真坑
- 准备同一扫描 PDF、十道口语题、三份空目录、一张表记录「题号 / 是否命中 / 表数字是否错位 / 备注」。跑的时候不要边看边改提示词——那是另一场实验。
- 坑一:用电子版 PDF 的好结果外推扫描件。验收表强制包含至少两道「表内数字」题。另一个常见翻车是纯图片扫描件没有文字层,MarkItDown 只吐出空壳或几行页眉,于是有人误判「工具不行」;先用 pdftotext 看一眼,没字就补 OCR 层再比。
- 坑二:为了追表结构,把三种工具的后处理写成不可维护 if-else。改成文件级路由后,后处理只做脱敏和目录规范化。
- 坑三:在横评群里贴截图吵架。截图没有题号、没有是否命中,只有「你看这表多整齐」。整齐和可检索不是一回事。
我还建议把「人工抽检」写进流程:每二十份自动转换抽两份,打开 Markdown,用眼睛对一下盖章页附近的关键句和表头。机器分数再好看,盖章页附近的扭曲最容易被漏。抽检发现系统性问题,就回滚路由规则,而不是默默给单份文件开特例——特例一多,团队就没有公共知识了。
按天铺开(别周末通宵堆环境):第一天只装 MarkItDown,跑十道题;第二天再装 Docling,只重跑失败题;第三天若公司已有 Unstructured,再把它纳入同一题库。安全提醒:扫描制度里常有身份证与账号,本地跑完再决定是否上传任何云解析。许可证与商业使用条款以各仓库 LICENSE 与官网说明为准,接入客户项目前进法务或自行阅读。对采购或老板的说法可以更短:我们不买「万能解析」,我们买「失败可升级的路径」。预算应当主要花在难例集和抽检工时,而不是再买一个 Logo 很酷的转换器。工具会过时,难例集和验收题不会。你明天就能做的复现:同一 PDF、同一题库、三家默认路径、只记命中与错位——把那张表贴进团队 wiki,比再读一篇评测有用。
样本偏差也要写进团队共识:我的制度 PDF 偏行政,法律意见书、工程图纸、手写附件可能让名次重排。所以内部要维护难例集,每月加三份新失败文件,而不是永远炫耀第一周的那份差旅制度。难例集比任何外部评测都更接近你们真实的文件分布。
和 CI 的最小结合:对样本目录跑转换,断言输出行数大于阈值、不含明显乱码替换字符、关键标题字符串仍在。这比「看起来像 MD」更接近工程。等团队大了,再把 Docling 路由测也加进去。一步步加,比第一周就上完美平台现实。写到这里,横评的意义其实已经说完了——剩下的是你愿不愿意花半天跑那十道题。跑完之前,任何「我听说某某更强」都只是社交货币;跑完之后,你才有资格在评审会上把表格拍到桌上。


评论列表 (0条):
加载更多评论 Carregando...