


AI DAILY BRIEF / 2026.11.07
METR 判断,Anthropic 在目标明确任务上的模型能力进步速度可能已接近此前的两倍,但这不等于研发团队的生产率翻倍,关键证据删减也让外界难以复核加速来源。产品侧,Inkling 2 Small 的任务表现与消耗同步上升,豆包工作、Meta 和 Perplexity 则分别调整了额度、交互与长期任务处理方式。
METR 的“约翻倍”,不能直接换算成研发生产率
这一判断需要与指数测量分开理解。公开转述称,自 2025 年 10 月起,模型综合能力指数 AECI 的增速约为此前的 1.9 倍,统计包含三个未发布的内部模型。换用不同统计假设,结果会在 1.1 至 2.9 倍之间变化:只保留“约两倍”,会掩盖估计对统计条件的依赖。
能力指数、研发过程和团队生产率也不是同一个指标。按转述口径,AI 目前仍主要充当助手,模型训练的关键环节尚不能完全自主完成。因此,这份评估并不能证明 AI 已能独立完成模型研发,也不能证明某个开发团队会获得同等幅度的提效。
更大的限制在证据层面:Anthropic 以保密为由删去了大量关键证据,外界难以独立核查加速究竟来自哪里。对研发负责人而言,这份评估值得关注的信号是模型能力进步可能正在加快;要据此调整预算、人员或交付周期,仍需要自己任务中的可比测量。
注意:模型进步加快,不等于研发团队可以把交付计划压缩一半。METR 的「约两倍」是带不确定性的评估判断,不能直接换成人力或排期承诺。
加速有多少来自 AI,公开证据仍难复核
围绕同一份评估,The Decoder 的报道进一步转述:Anthropic 可能早在 2026 年 7 月 15 日,就触及了其自身设定的 AI 研发加速预警线。“可能”和“自身设定”是这里的关键限定,不能把它写成已经确认触发的通用行业标准。
报道还转述 METR 的估计,约 80% 的提速来自内部使用 AI,而非训练算力增长加快。这是归因估计,不是已证实的因果比例。该报道给出的加速倍数区间为 1.3 至 3 倍,上一节转述的 1.1–2.9 倍区间与这里的 1.3–3 倍应分别保留,不能拼成一个更确定的结论。
据报道,多数被 METR 评为最有信息量的证据遭到删减,算力分配审计也被中途取消。本稿未见 METR 原报告全文;The Decoder 与 X 转述也不构成两项独立研究。后续更值得追踪的是:哪些证据能够补充公开,公众能否据此复核研发提速及安全投入,而不只是继续传播一个倍数。
注意:以上が原文の開示要点です。適用範囲については、公式資料を基準とします。
Inkling 2 Small 任务得分上升,权重尚未开放
Thinking Machines 发布 Inkling 2 Small,面向需要微调模型的开发者,支持图文输入和可调思考深度。公司披露,其 AutomationBench-AA 智能体任务测试得分从 5% 升至 46%。模型目前通过 Tinker 平台提供;按报道摘录,权重计划在外部安全测试完成后以 Apache 2.0 许可发布,尚不能视为已经开放下载。
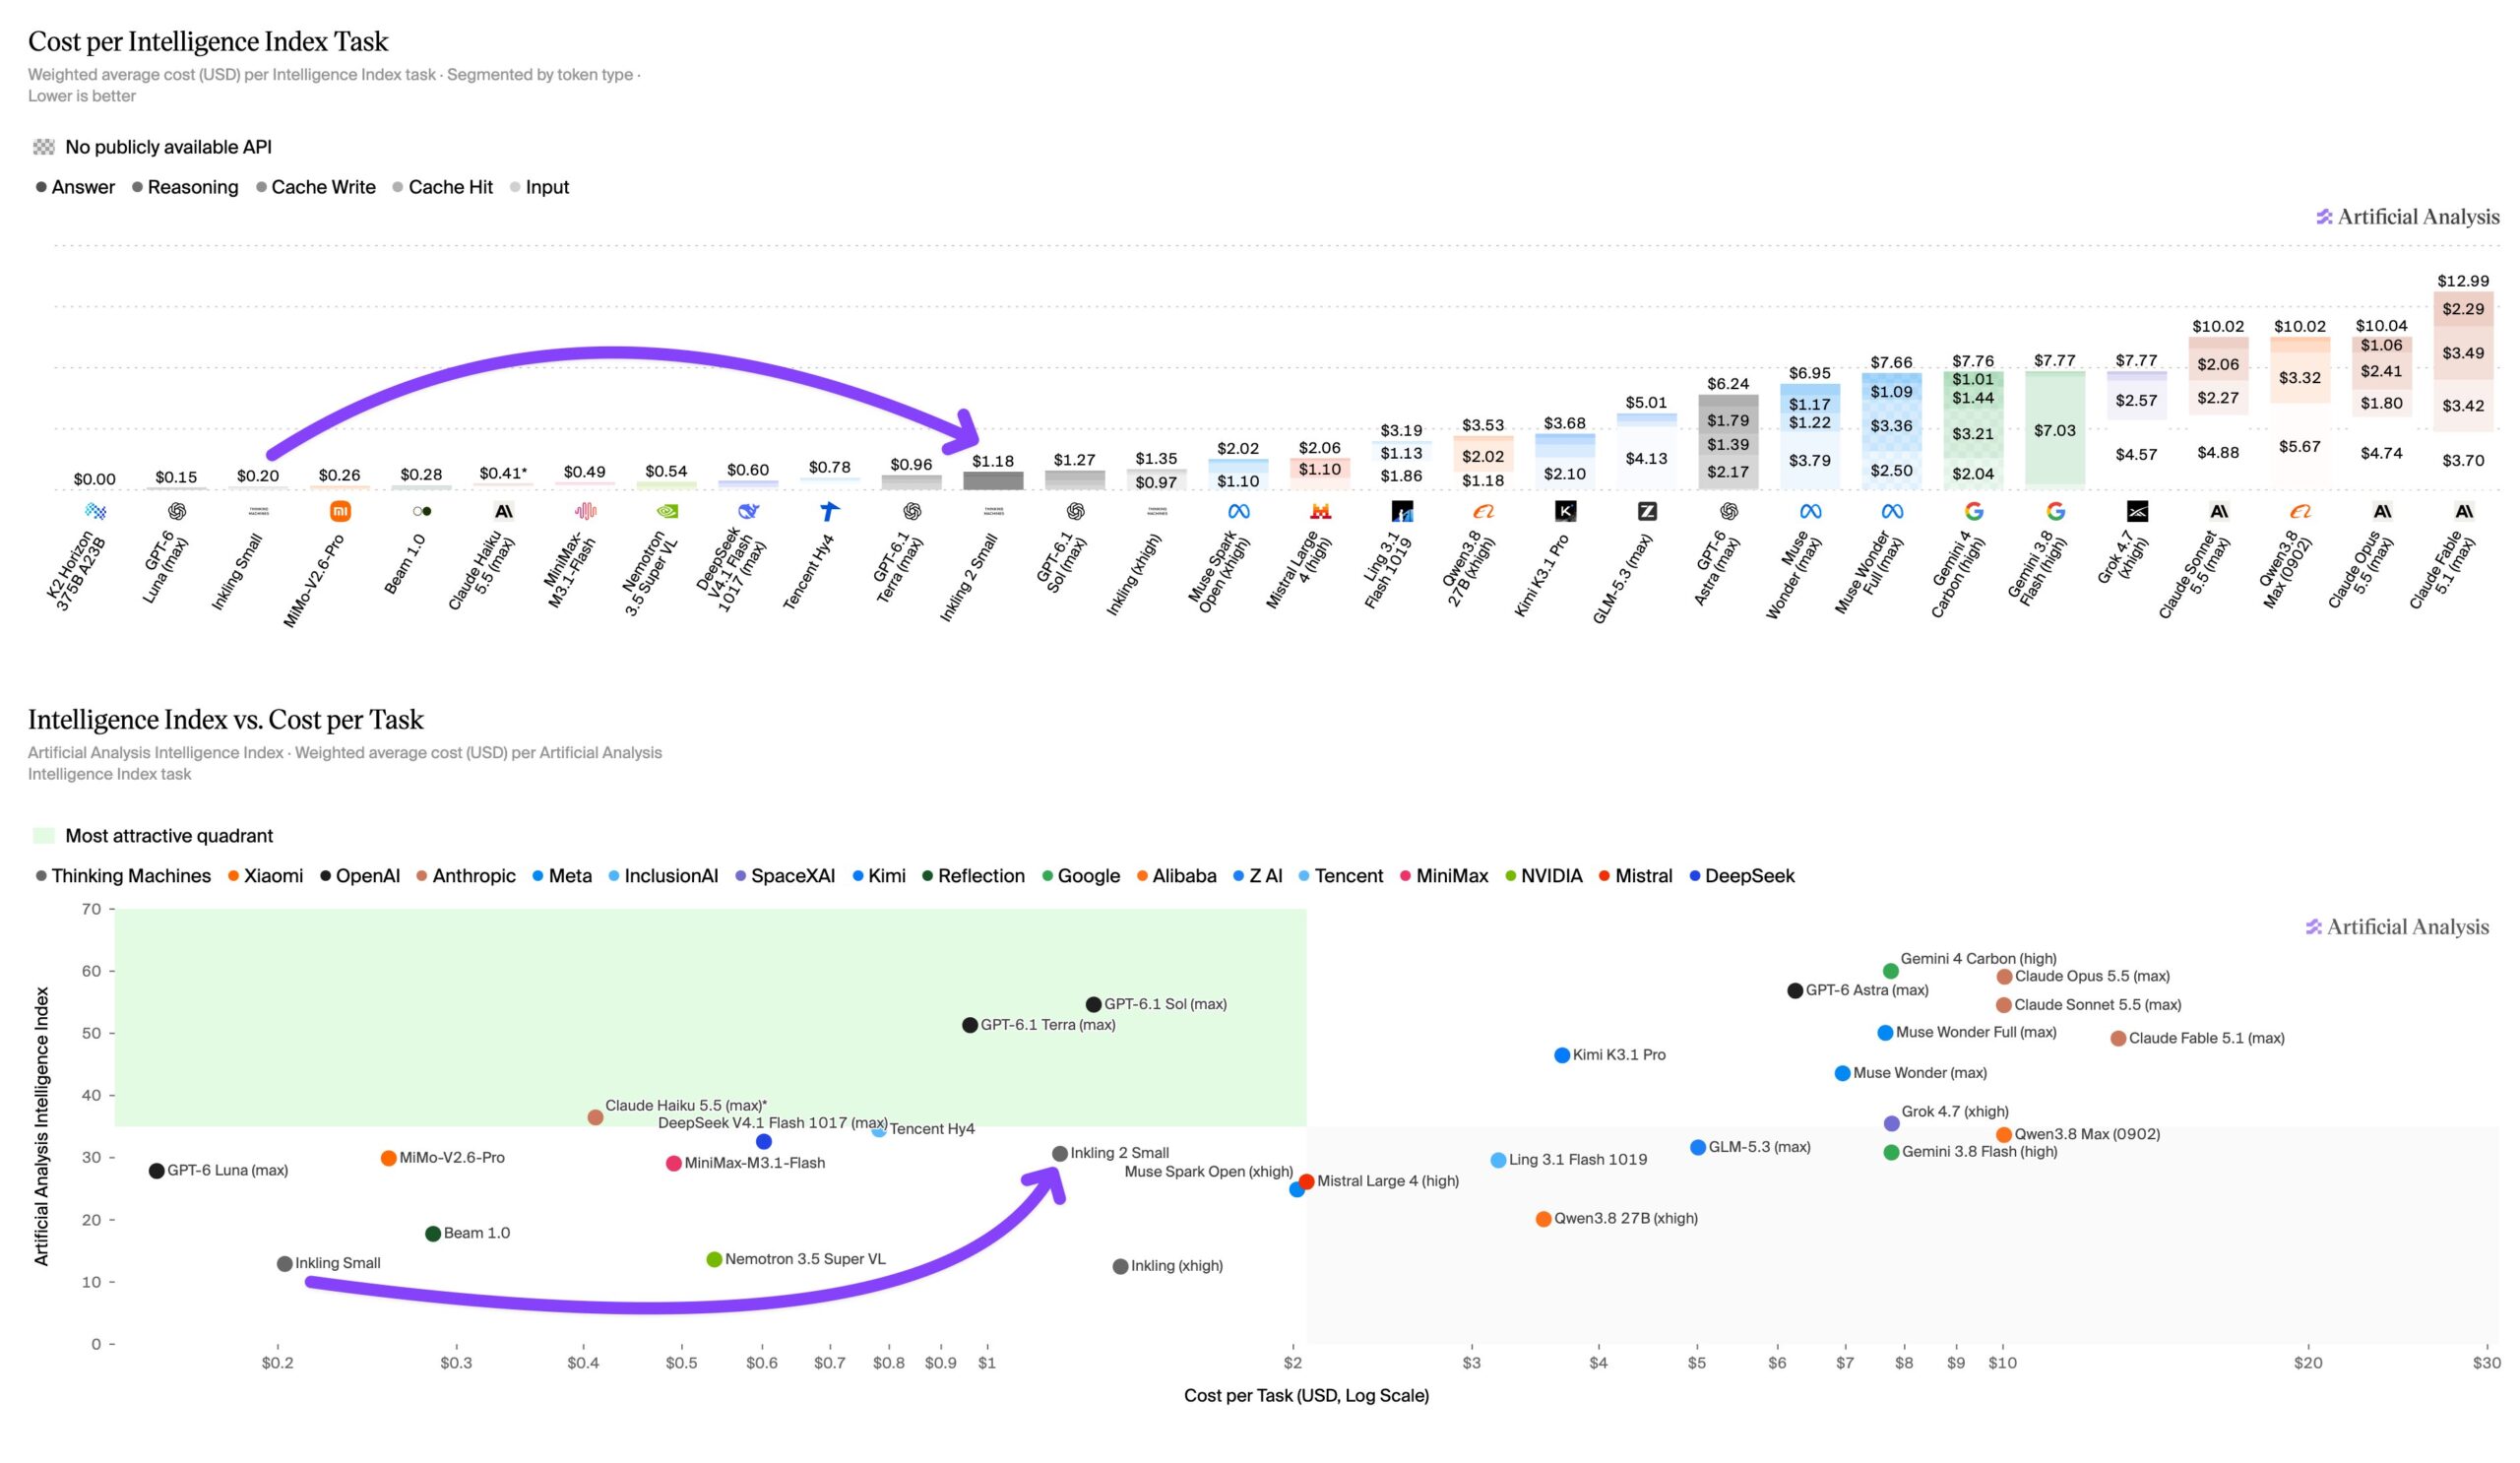
表现改善也伴随成本和回答覆盖率的变化。报道转述 Artificial Analysis 的测量,单任务成本为 1.18 美元,接近前代的六倍,仅适用于对应测试;幻觉率从 61% 降至 27% 的同时,回答率也从 77% 降至 53%。对定制开发团队来说,任务得分、回答覆盖率和权重获取状态需要一起核对,不能只凭幻觉率下降认定全面可靠性提升。
注意:以上が原文の開示要点です。適用範囲については、公式資料を基準とします。
Inkling 的长任务成本,要连同输出量一起看
极客公园的报道为同一款模型补充了参数与任务消耗信息:TML 于 11 月 5 日发布 Inkling 2 Small,重点面向长程编程和办公任务,总参数为 5940 亿、推理激活参数为 170 亿,支持百万上下文。这些规格说明了模型形态,但不足以单独判断部署门槛或一次任务的费用。
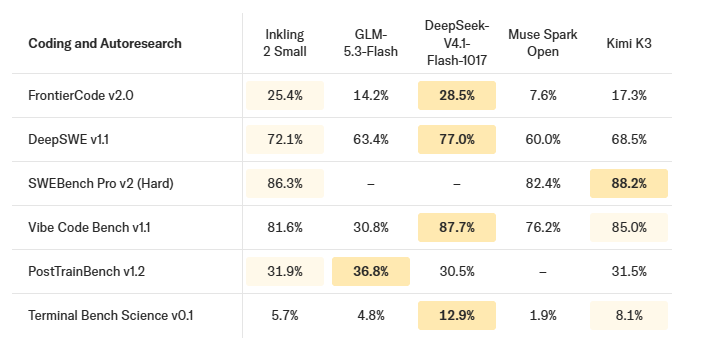
该报道转述的 AA 测试中,每项任务平均输出约 15 万 token,单项成本为 1.18 美元;报道同时指出,其编程表现并非全面领先。因此,选型时应把任务长度、输出规模与完成效果放在一起比较,不能用激活参数或单项智能体得分替代实际任务评估,也不能把测试成本直接当成业务账单。
注意:以上が原文の開示要点です。適用範囲については、公式資料を基準とします。
豆包工作取消 5 小时限制,周额度仍按套餐执行
自 11 月 6 日起,豆包工作个人版取消 5 小时短周期额度限制。此前采用 5 小时、7 天双周期额度管理,用户即使还有周额度,也可能先触及短周期上限;调整后,可以在剩余周额度内集中整理资料、撰写内容和多轮修改。
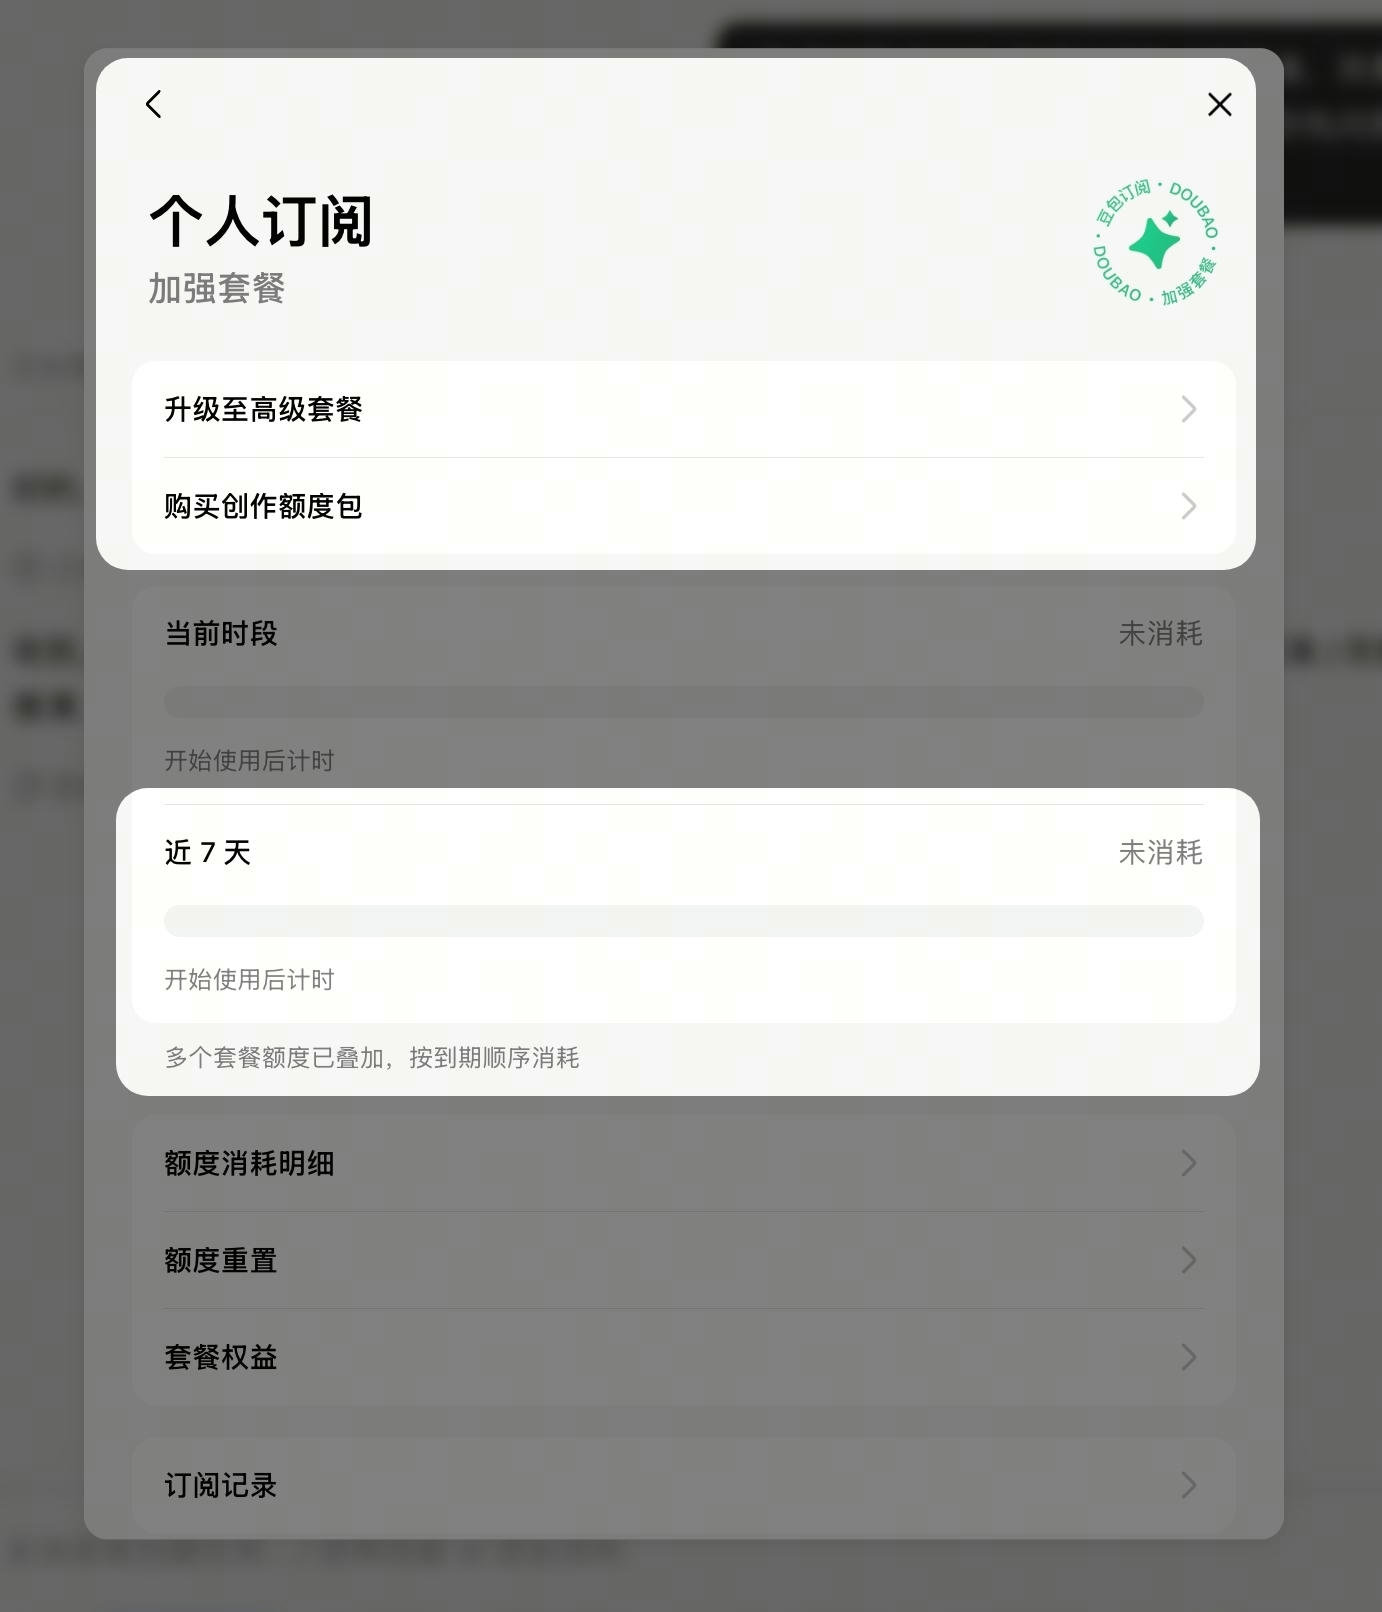
这次改变的是额度使用节奏,不能据此认定套餐总量增加,更不意味着无限使用。周额度及其他规则仍按对应套餐执行,可在“设置—订阅与额度管理”查看。对赶方案、修改演示文稿或做长篇研究的用户,少一道等待限制有实际价值,但集中处理任务时仍需留意本周余量。
注意:以上が原文の開示要点です。適用範囲については、公式資料を基準とします。
Meta spaces 将聊天需求变成可编辑空间
据 The Verge 报道,Meta 正向所有 Muse 用户推送 spaces:用户描述需求后,可以创建购物中心、学校事务看板或音乐追踪器,并在空间中勾选事项、添加笔记和直接编辑,也能继续通过对话调整。空间还可以放入侧边栏或主标签页,并安排展示时间。
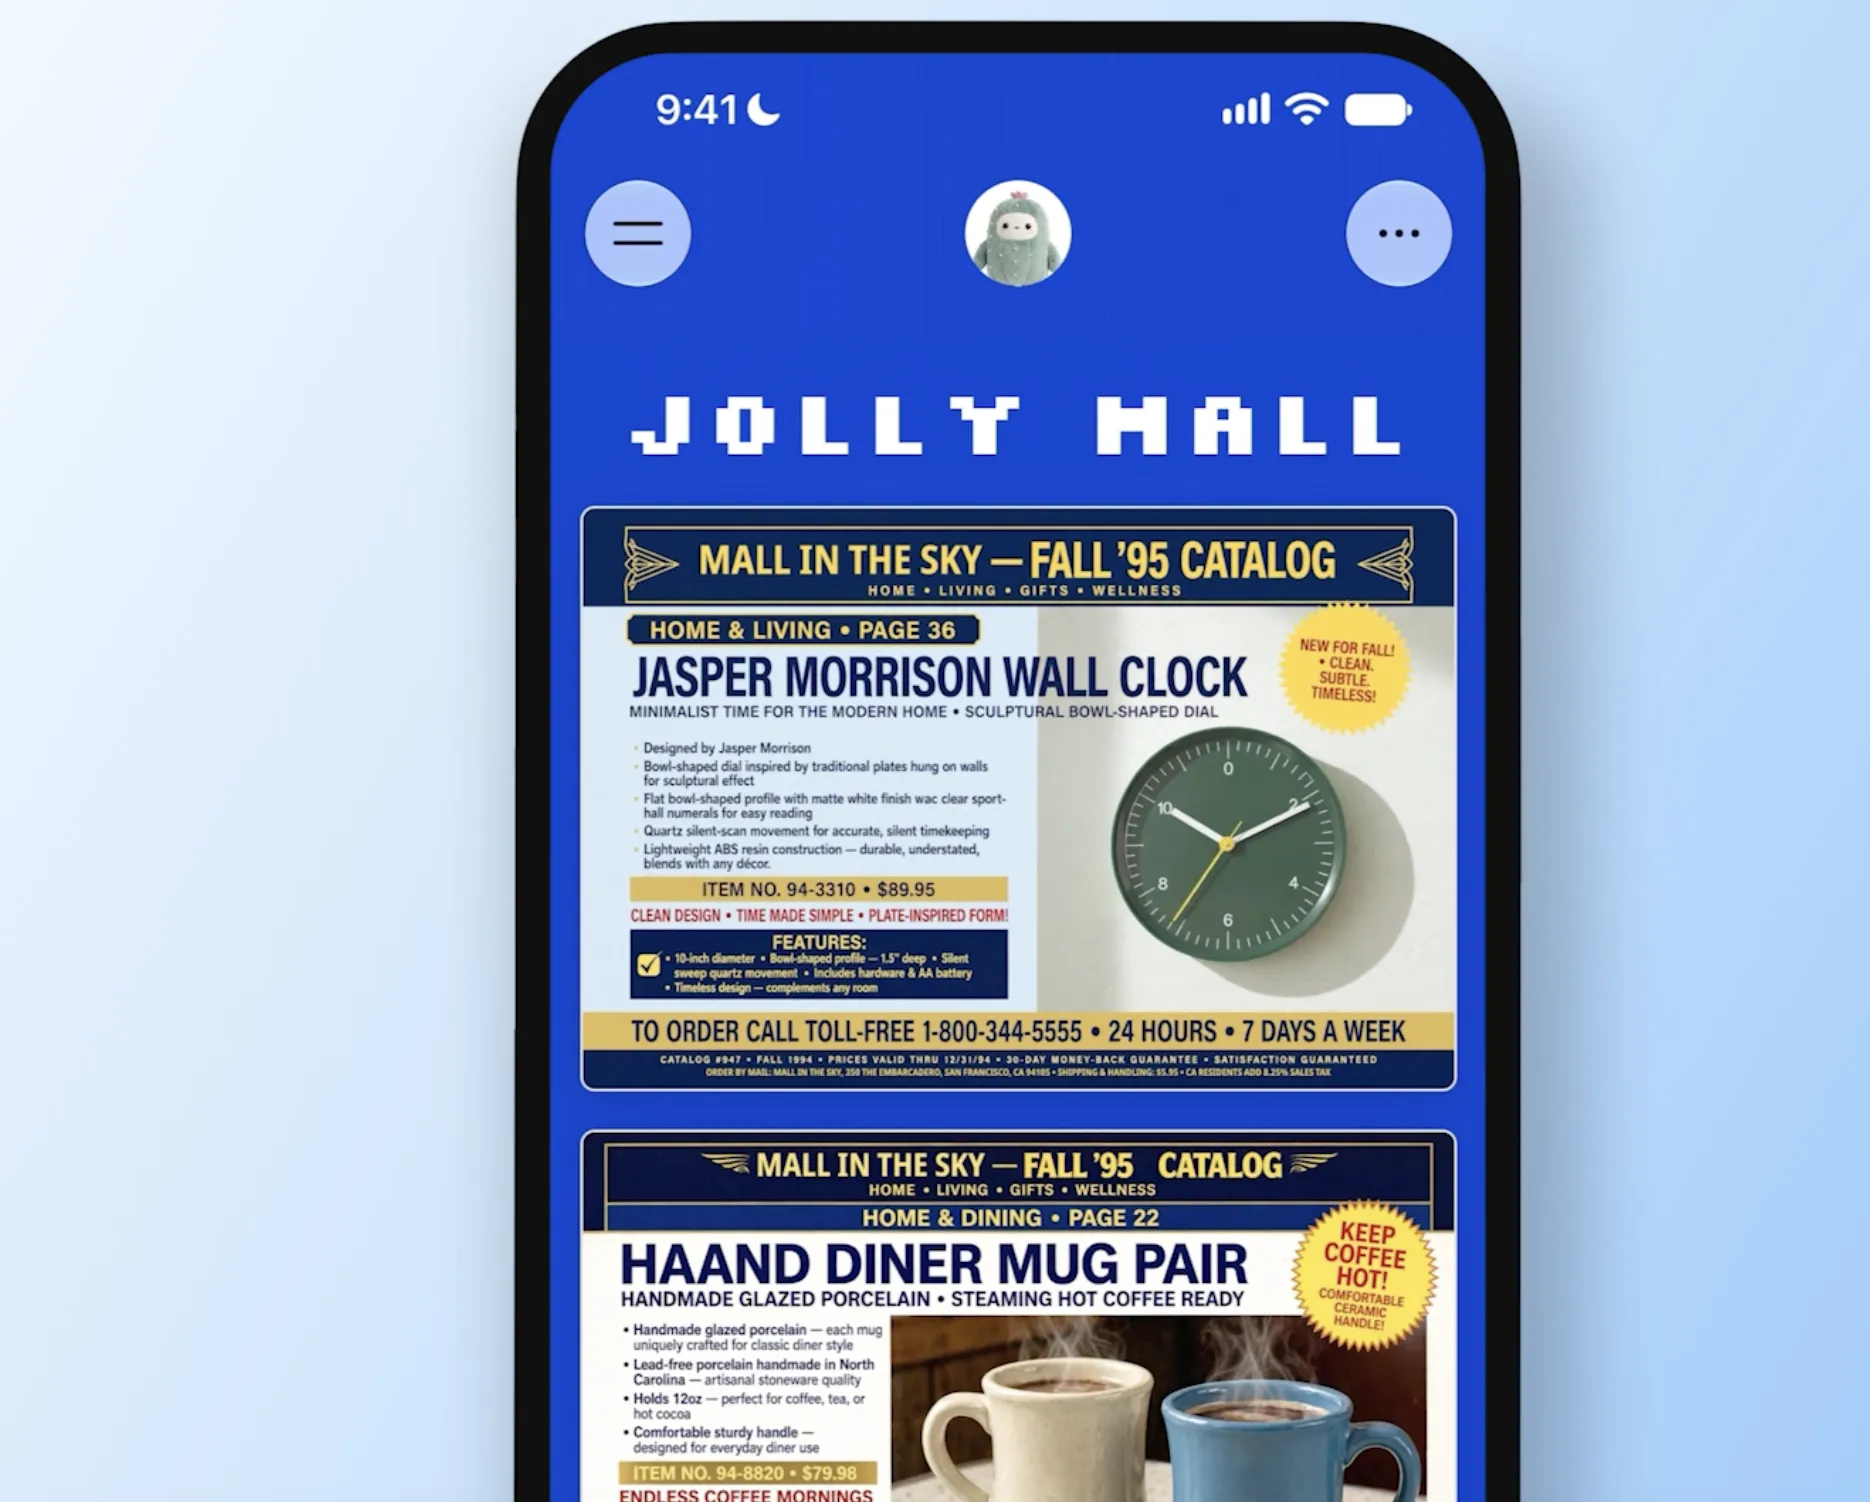
后台信息更新有前提:连接相关应用后,Muse 才能更新价格、日期等内容。空间分享和多人协作仍在探索中,不能算作已上线能力。对产品团队而言,这次变化值得关注的是,聊天结果开始成为可持续使用和修改的界面;其协作价值还需要看后续功能落地。
注意:以上が原文の開示要点です。適用範囲については、公式資料を基準とします。
Perplexity 推出 Teammates,Max 套餐为使用门槛
Perplexity 推出 Teammates,定位是全天候运行、持续跟进长期项目。每个 Teammate 运行在独立虚拟机上,配有桌面和浏览器;用户可以在 Perplexity 应用的专属会话中查看进度,也能通过 Slack 与其交互。
定位上,Teammates 更接近「长期值守的代理」,而不是单次问答窗口。公开材料把它写成可在独立环境里持续推进项目,并把进度带回应用内会话或 Slack;这改变了任务组织方式,但仍不等于已经验证的无人值守交付。
注意:使用门槛是每月 200 美元的 Max 套餐;公开摘录未给出完整额度、地区范围及额外计费条件,这一价格不能直接理解为全部运行费用。采购侧仍要核对任务额度与完成质量,产品定位本身不证明长期可靠性。
微短剧专项治理覆盖 AI“盗脸偷声”与推广环节
据报道,国家广播电视总局部署的本轮微短剧低俗化同质化专项治理,时间为 2026 年 11 月 1 日至 12 月底。创作端涉及低俗不良内容、特殊题材备案审核,以及 AI“盗脸”“偷声”等问题。
传播端同样在治理范围内,包括片名、宣推素材、弹幕评论、引流片段,以及更换片名或主角姓名后重复播出、首页与榜单推荐同质化等情况。对 AI 内容创作者和平台运营者,检查范围需要覆盖正片、推广素材与分发环节,仅审核最终剧集并不足以覆盖报道列出的治理事项。
注意:以上が原文の開示要点です。適用範囲については、公式資料を基準とします。
参考リンク
- X:METR 的“约翻倍”,不能直接换算成研发生产率
- THE DECODER:加速有多少来自 AI,公开证据仍难复核
- THE DECODER:Inkling 2 Small 任务得分上升,权重尚未开放
- geekpark.net:Inkling 的长任务成本,要连同输出量一起看
- leiphone.com:豆包工作取消 5 小时限制,周额度仍按套餐执行
- The Verge:Meta spaces 将聊天需求变成可编辑空间
- THE DECODER:Perplexity 推出 Teammates,Max 套餐为使用门槛
- ithome.com:微短剧专项治理覆盖 AI“盗脸偷声”与推广环节


评论列表 (0条):
加载更多评论 読み込み中...