


BLOG / 2026.11.07
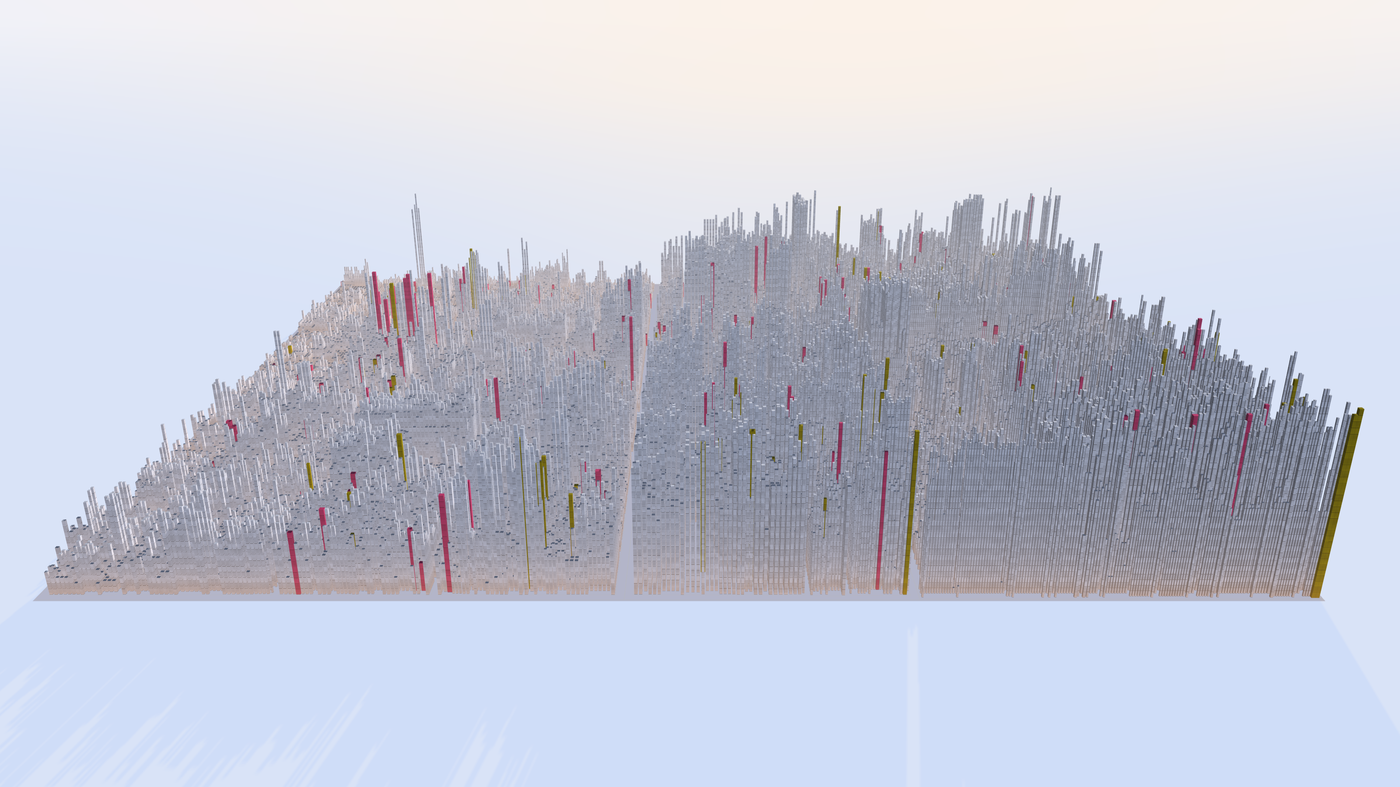
约 7500 页的代数几何圣经 Stacks Project,被 Axiom 用 AI agent 集群翻成约 1600 万行 Lean 代码,并在 11 月 4 日开源。官网原话把它叫作「有史以来最大的一体化、可复用形式化数学库」。
数字够炸。但若只把标题读成「AI 写完了数学」,会漏掉更重要的工程现实:机器核验通过,不等于人类已经逐行审完;上游维护者甚至明确要求,先别把 AI 生成的评论和 PR 直接砸进原版 Stacks 仓库。
1600 万行是体量;StacksCore / StacksFrontier 分层,才是可信度刻度。
Stacks 为什么值得被形式化
Stacks Project 由哥伦比亚大学数学家 Johan de Jong 于 2005 年发起,用永久四字符 tag 组织定义、引理与定理,目标是把代数几何基础写成可协作的开源参考。它不是一道题的证明,而是一整座可复用基础设施——方案、层、上同调、代数栈……现代证明常常要先爬完这座塔。
Axiom 强调:在 Lean / Mathlib 已经覆盖较好的领域,新结果可以较快形式化;代数几何却长期缺「能直接 import 的地基」。把 Stacks 整库形式化,等于给人类与 AI agent 共同提供一条机器检查过的引用链。
1600 万行之外的分层
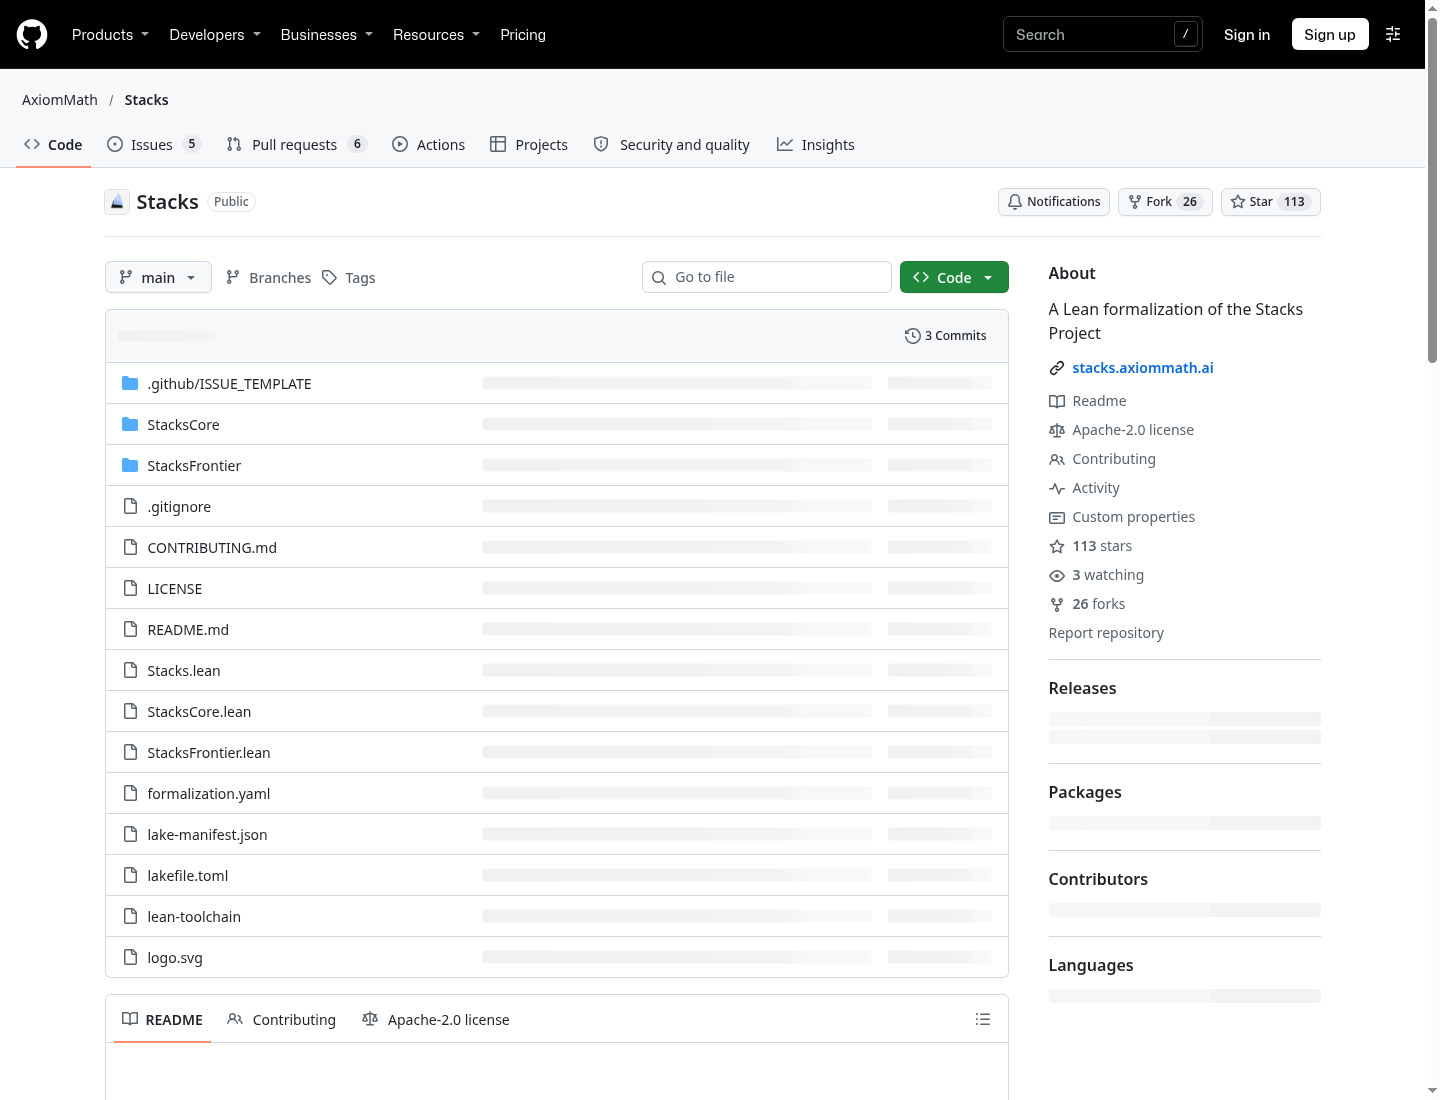
GitHub 仓库 AxiomMath/Stacks 基于 Lean 4 与 Mathlib,许可证 Apache-2.0。README 写明:Lean 内核检查每个证明,没有 sorry,也没有 native_decide。这解决的是「证明是否被核接受」,不是「写法是否已达 Mathlib 人工风格」。
因此仓库拆成两层:
- StacksCore:人类已审,对齐 Stacks 文本并尽量贴近 Mathlib 命名与通用性。
- StacksFrontier:AI agent 写的覆盖面扩张区——增长最快,也最需要审阅后才能晋级 Core。
「约 1600 万行」来自 Axiom 公告口径;第三方评论也提醒:行数会被生成风格拉长,更公允的指标是 tag 覆盖率与 Core 晋级比例。本稿未克隆全库自行 wc -l,数字引用官方与公开转述。
形式化发现了什么,边界在哪
Axiom 称,形式化过程暴露了原文中需要局部修正的陈述:缺假设、正特征边角、过于一般的断言等;agent 会构造反例,并尝试修补以便下游章节继续依赖。对照站提供原文与 Lean 并排、依赖图与反例入口——这比只丢一个巨型 zip 更像「可被数学家检查的工作区」。
同时有一条冷水:2026 年 10 月 21 日,de Jong 公开要求暂时不要把 AI 生成的评论与 PR 直接提交到上游 Stacks 仓库。Axiom 明确其 Lean 库是独立项目,反例与修正留在自己的仓库,供社区按需取用。尊重边界,本身就是这条新闻的一部分。
对 AI 圈,它和「又一个刷榜模型」不同:价值在于把不可手检的生成规模,接到可机器检查的核上。对数学圈,争议点会落在 Frontier 占比、陈述忠实性、以及 AI 修正是否被领域专家接受。两边都别用「开源了就等于真理库」偷懒。
若你做的是自动定理证明或科研 Agent,短期可操作的是:把对照站当导航,先引用 Core 中已审声明;把 Frontier 当覆盖地图与审阅队列,而不是生产依赖的唯一真相源。行数可以上热搜,晋级率才决定它能不能进你的证明供应链。
再补一句产品时间线:Axiom 10 月 27 日刚发过有限单群分类(CFSG)的 Lean 形式化;11 月 4 日这条 Stacks 库是另一类工程——不是一座「定理纪念碑」,而是一片「可 import 的地基」。两者都大,但验收标准不同。
形式化工程的难点,Axiom 写得很系统:数千 agent 并行时,若定义稍有不一致,Lean 内核仍可能分别接受两份「各自正确却无法组合」的文件。他们用层级职责与协调协议,逼所有接口在整库尺度对齐;陈述忠实性靠多 agent 审计、与原文语义交叉检查、以及「必须被下游定理成功引用」来约束。失败的证明尝试被用来定位原文缺口,而不是只会报错退出。
这对「AI 写数学」叙事是一次纠偏:高潮不是模型突然懂代数几何,而是软件工程把生成规模接进可组合的库架构。CFSG 形式化更像一座定理纪念碑;Stacks 形式化更像把标准库补齐。你若只转发行数,会把两类成就揉成同一种热搜。
开放协作的现实温度也值得写进正文:对照站邀请数学家、Lean 开发者与 AI agent 一起检查与 refinement;同时上游 Stacks 维持人类编辑主权。两条轨道并行——独立 Lean 库可以激进试错,原版百科继续按社区节奏生长。谁先把 Frontier 晋级成可被广泛引用的 Core,谁才真正改变日常证明工作流。
数字之外,Axiom 还提到每个 Lean 声明尽量回链 Stacks tag,并映射到 EGA/SGA 相关条目。对研究者,这意味着「从熟悉的纸质标签跳到机器检查声明」的路径被铺了出来。路径是否好走,仍取决于文档、构建时间与审阅进度,而不是发布会当天的截图。
当社の判断:1600 万行 Lean 是真爆点,但标题之外更关键的是 Core/Frontier 分层与上游「拒收 AI PR」的边界。机器验过 ≠ 人类审完;把它当可引用基础设施,先看晋级与对照,而不是只看行数。
参考リンク
- Axiom:The Stacks Project, formalized in Lean
- 对照站 stacks.axiommath.ai
- GitHub:AxiomMath/Stacks
- 上游 Stacks Project


评论列表 (0条):
加载更多评论 読み込み中...