


本文是对比:同一批网页 URL,分别走 Jina Reader、Firecrawl、Trafilatura,看谁适合哪种页。不是品牌软文。结论先放:已有 HTML 或静态页用 Trafilatura 本地抽,强 JS 和整站才上 Firecrawl,Jina Reader 只当探针。读完应能选定默认刀,并今晚把抽正文接到 Markdown 流水线。
测试怎么设:同一批 URL、同一套打分
我固定 12 个 URL:静态博客 4、文档站 3、强 JS 营销页 3、需登录墙外的公开难页 2。打分只看四项:正文完整度、噪声(导航/页脚)、表格/代码块保留、人工可编辑 Markdown。每条 0–2 分,总分排序,不搞「体感冠军」。
打分表落盘建议 bench/web2md_scores.csv,列:url, tool, completeness, noise, structure, editable, notes。每人打分前先对 2 个样例对齐标准:导航进正文算噪声;页脚版权算噪声;代码块丢缩进扣 structure。没有对齐会打出「体感冠军」。
URL 池要冻结版本:把 12 个 URL 与抓取日期写进 bench/urls.txt,评测日网页变了就换备用 URL,并在 notes 标明。否则你比的是网页漂移,不是工具。
四项的 0–2 分要写成可执行的判据,否则两个人打出来差一分就吵不清:
- 完整度:2=正文段落全在;1=缺一段以上或尾部被截;0=只剩标题或空。
- 噪声:2=零导航零页脚;1=混入一两行侧栏或「相关推荐」;0=导航占比肉眼可见。
- 结构:2=标题层级、表格、代码块缩进都在;1=表格变成散行或代码块丢缩进;0=全部糊成一段。
- 可编辑:2=拿来就能改;1=要手动删十行以内;0=重写比修快。
判据里最容易被忽略的是结构。喂 LLM 做检索时,表格糊成散行比多几行导航更伤:模型能忽略噪声,但没法凭空还原行列关系。所以同分时我优先保结构的那把刀。
另外记一条:同一 URL 隔天再抽,结果可能不一样。电商页会轮换推荐位,新闻页会插广告。所以冻结 URL 之外还要冻「期望输出」——人工认可的那版 Markdown 存成 bench/golden/,回归时和它比差异行数,比只断言非空严格得多。难页里若遇到反爬拦截、三家都抽残,把它移出评测分母单独记,否则会误判工具不行。
Jina Reader:最快上手的「URL 变 Markdown」
适合:原型抽查、快速确认某页能不能抽。调用门槛低,适合「先看一眼」。不适合:整站爬、强登录、要细控渲染预算。把它当探针,不当生产唯一入口。
用法就是在原 URL 前加前缀:curl https://r.jina.ai/https://目标页面,返回的就是 Markdown。它的价值在于零安装,产品、运营也能自己试。但要记住两件事:一是请求经过第三方服务,内网文档、带客户数据的页面别往里扔;二是不带 key 时有速率限制,批量跑会被限流。需要长期用就看它的开源仓库自建,但到那一步通常已经该换成本地抽取了。
最小探针(示意):把 URL 交给 Jina Reader 公共或自建入口,拿到 Markdown 后人工看噪声。适合开会对着投屏「这页能不能抽」。配额与延迟要记进笔记——原型阶段可接受,流水线高峰期可能不够稳。若某页 Jina 都抽残,先别急着上 Trafilatura,可能是页本身反爬或强登录。
Firecrawl:要渲染、要爬站、要结构化时
适合:JS 渲染重、要跟站内链接扩抓、要结构化字段。成本与配额要算进流水线。不适合:已有干净 HTML、只想本地离线抽正文——杀鸡用牛刀。
Firecrawl 我用在两类页:① 强 JS,curl 下来几乎空壳;② 需要跟站内链接扩抓的文档站。接法上坚持「抓取与抽取拆开」:Firecrawl 负责拿到可用 HTML/DOM 或结构化字段,Markdown 规范化仍可回落到 Trafilatura 或自写清洗。账单与并发限制写进 README,避免某人随手全站爬把月配额打穿。
它的两个核心动作要分清:scrape 是单页抓取并返回 Markdown 或结构化字段,crawl 是从入口页沿站内链接扩抓。绝大多数团队真正需要的只是对少数强 JS 页做 scrape,crawl 一开就是成百上千次计费调用,必须先设深度和页数上限。另外它也能自建部署,数据不出内网的场景可以考虑,但运维的是一整套浏览器渲染服务,别低估这块成本。
Trafilatura:已有 HTML 时我的默认本地刀
适合:静态页、文档镜像、批量本地。依赖少,可进 CI。不适合:必须浏览器渲染才能出正文的页——先抓 HTML 再喂它,或换 Firecrawl。
我把它定为默认刀,理由很朴素:纯 Python、无浏览器依赖、离线可跑,能进 CI 做回归;同一份 HTML 每次抽出来的结果稳定,出问题能复现。云服务做不到这一点,因为你控制不了对方哪天改了抽取策略。
本地默认刀命令(trafilatura 2.3.1 实测):
pip install trafilatura
# 单页 URL → Markdown 打到标准输出
trafilatura -u "https://www.trafilatura.org/" --markdown > out/post.md
# 已落盘的 HTML:走 stdin,不要用 -i
cat raw/page.html | trafilatura --markdown > out/page.md
两个坑先说:--output-format md 会直接报 invalid choice,只认 markdown 或简写 --markdown. ;-i 读的是「每行一个 URL 的列表文件」,把 HTML 文件塞给它只会得到一句 Discarding URL。
CI 断言示例思路:输出文件非空;不含固定噪声词(如「首页|登录|版权所有」按站点改);表格行数不低于人工基线。断言失败先人工看是网站改版还是抽取回归。
对照表:我怎么选
| prendre | 默认 | 备选 |
|---|---|---|
| 静态正文批量 | Trafilatura | Jina 抽查 |
| 强 JS / 整站 | Firecrawl | 自建 Playwright+抽取 |
| 五分钟验证单页 | Jina Reader | Trafilatura |
| 内网 / 含敏感数据 | Trafilatura | 自建 Firecrawl |
| CI 离线回归 | Trafilatura | 无(云服务不进 CI) |
抓取与抽取请拆开:谁负责拿 HTML/DOM,谁负责变 Markdown。混在一个黑盒里,出了噪声你不知道该换哪一层。
说得更直白一点:三者不是同一层的竞品。Jina 和 Firecrawl 同时做了抓取和抽取,Trafilatura 主要做抽取,抓取只是附带能力。所以真正的选型问题不是「谁最好」,而是「抓取层要不要浏览器渲染、抽取层要不要离线可控」。想清楚这两个问题,表格里的选择是自然推出来的。成本也随之清楚:本地抽取的边际成本接近零,云端按调用或渲染计费,所以默认路径必须是便宜的那条,贵的只在满足升级条件时走。
网上常见的「哪个工具更强」其实比错了维度。云服务迭代快,今天的结论半年后可能就翻篇;而你的升级条件、噪声词表、golden 基线沉淀在自己仓库里,换刀时不用重来。这也是我把评测脚本和打分表看得比榜单更重的原因。
补充决策树(一句话):先问「我手里是 URL 还是 HTML」。已有 HTML → Trafilatura;只有 URL 且静态 → 可 Jina 抽查或自行抓取再 Trafilatura;URL 且强 JS/整站 → Firecrawl(或 Playwright)再抽取。永远把「默认刀」写进 README,新人不要每次重新选美。
今晚怎么接进流水线
一句话结论:默认走 Trafilatura 本地抽取,强 JS 或整站才升级 Firecrawl,Jina 只做探针;升级条件写进 README。下面按安装、跑通、配置、翻车、验收五步走,一晚能完。
1. 安装
mkdir -p web2md/{raw,out,bench} && cd web2md
python -m venv .venv && . .venv/bin/activate
pip install trafilatura        # 我实测 2.3.1
python -c "import trafilatura; print(trafilatura.__version__)"
抓取层单独装:requests/httpx 落静态 HTML;强 JS 页用 Firecrawl 或 Playwright 先拿到渲染后的 HTML,也落进 raw/。抽取层只认 raw/*.html,这就是「抓取与抽取拆开」的落地形态。
2. 跑通
scripts run_static.py:逐个读 raw/*.html,抽 Markdown,按文件名哈希落 out/,顺手做噪声断言,有一页不过就退出码 1,CI 直接能用。
import hashlib, sys
from pathlib import Path
from trafilatura import extract

noise = [w for w in Path("bench/noise_words.txt").read_text(encoding="utf-8").split() if w]
Path("out").mkdir(exist_ok=True)
bad = 0
for p in sorted(Path("raw").glob("*.html")):
    md = extract(p.read_bytes(), output_format="markdown", include_tables=True) or ""
    name = hashlib.sha1(p.name.encode()).hexdigest()[:10] + ".md"
    Path("out", name).write_text(md, encoding="utf-8")
    hits = [w for w in noise if w in md]
    ok = bool(md.strip()) and not hits
    bad += not ok
    print(f"{'OK  ' if ok else 'FAIL'} {p.name} -> out/{name} chars={len(md)} noise={hits}")
sys.exit(1 if bad else 0)
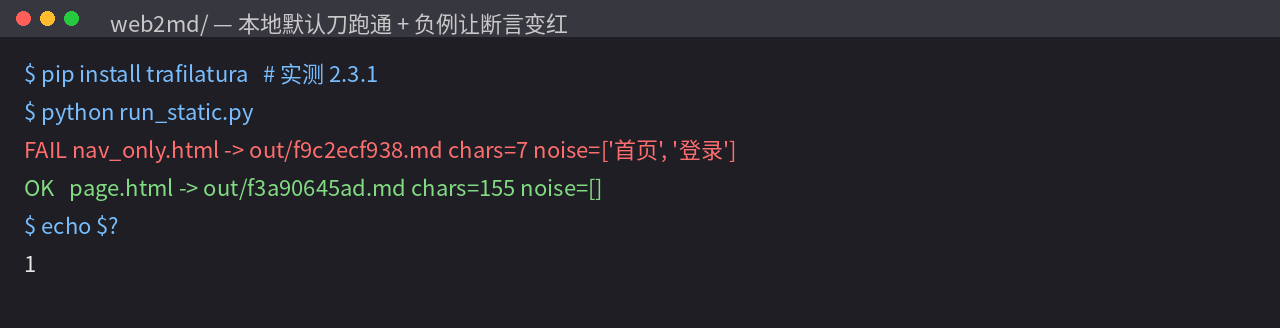
我放了一篇正常文章和一个故意只有导航、正文靠 JS 渲染的空壳页。正常页抽出 155 字符、表格保留成 Markdown 表;空壳页只剩 7 个字符,全是「首页」「登录」,断言变红,退出码 1。这正是你想要的:空壳页不该悄悄进库,而该被打回去走渲染路径。
空壳页怎么补:用 Playwright 渲染后把 DOM 落盘,再交给同一个脚本,抽取层一行不改。
pip install playwright && playwright install chromium
python - <<'EOF'
from playwright.sync_api import sync_playwright
with sync_playwright() as p:
    b = p.chromium.launch(); pg = b.new_page()
    pg.goto("https://目标强JS页", wait_until="networkidle")
    open("raw/js_page.html", "w", encoding="utf-8").write(pg.content())
    b.close()
EOF
python run_static.py
3. 配置
bench/noise_words.txt:每行一个噪声词,起步写「首页、登录、版权所有」,按站点增补。抽 2 页人工对照后再定,不要凭空拍。bench/url_map.csv:url, sha, out_path, fetched_at。输出用哈希命名,不维护映射表就对不上源。- 抽取参数:噪声多就加
favor_precision=True(CLI 为--precision),正文被截就换favor_recall=True;表格默认保留,不想要用--no-tables. - 需要保留正文里的超链接(文档站互相引用很常见)就加
include_links=True(CLI 为--links),默认是丢掉链接只留文字。 - 喂检索库时加
with_metadata=True,标题、日期、作者会写进 Markdown 头部,后面做时间过滤和引用溯源都靠它。 - README 写死三行:默认刀=Trafilatura;难页=渲染后再抽;探针=Jina。另写升级条件,比如「curl 下来正文少于 200 字才走 Firecrawl」,并注明月配额上限。
4. 翻车
--output-format md报 invalid choice:只认markdown.trafilatura -i page.html只打出 Discarding URL:-i是 URL 列表,本地 HTML 用 stdin 或 Python 的extract().--input-dir raw -o out输出的是随机名 .txt,对不上源文件,所以批量我用上面的脚本自己命名。- 输出几乎为空:多半是强 JS 空壳,不是 Trafilatura 坏了,换渲染抓取再喂回
raw/. - 断言从没红过:故意留一个负例页(含「版权所有」或空壳),从未红过的断言等于没写。
- 中文老站乱码:别用
read_text(encoding="utf-8")硬读 GBK 页面,直接把read_bytes()交给extract(),让它自己识别编码。 - 云端账单暴涨:有人对整站直接上 Firecrawl。同域限速、重试带抖动,并发与配额写进 README。
5. 验收
- 真实 URL 池前 5 页里至少 4 页人工可读,导航和页脚不进正文。
bench/noise_words.txt非空,负例页能让python run_static.py返回 1。- README 写明默认刀和升级条件。
- 至少 1 个强 JS 页走通「渲染 → raw/ → 抽取」,并记下耗时与是否值得进默认路径。
五页里有三页强 JS 都失败,说明样本池偏了:先换静态页把管线跑通,再单开难页分支。登录墙、验证码不在本周范围。
入库前还有一步容易被跳过:按 Markdown 标题切块。拿 ##et### 做切分边界,每块控制在几百字,块首补上页面标题和 URL,检索命中后模型才知道这段话出自哪页。按固定字数硬切会把一张表格劈成两半,比不切还糟。
和检索入库的衔接只守一条线:run_static.py 返回 0 的页才进库。导航残留进了向量库,检索时会反复召回「首页、登录」这类片段,答案总往首页上引,这比少抽一页更难排查。


评论列表 (0条):
加载更多评论 Chargement...