


AI DAILY BRIEF / 2026.11.20
Perplexity 的 Decider v1.3 把同一份文档上的多项判断放进一次前向计算,并新增原文定位能力:分类、审核不一定需要先生成一段文字,但共享计算也不代表准确率和总成本已有保证。
其他值得关注的变化包括 Gemini 4 Neon 的接入与成本边界、ChatGPT 实时听写,以及 Anthropic 上市报道背后的交付和治理问题。
Decider v1.3:多题共享,可定位原文
同一份长文档需要做多项分类,不必每次都重新调用大模型、等待生成文本,再解析答案。据雷峰网报道,Perplexity 推出的 Decider v1.3 可以在一次前向计算中输出各题的选项概率。
对于反复处理同一份材料的内容审核或 Agent 评估流程,这提供了一条减少重复编码和生成开销的路径。
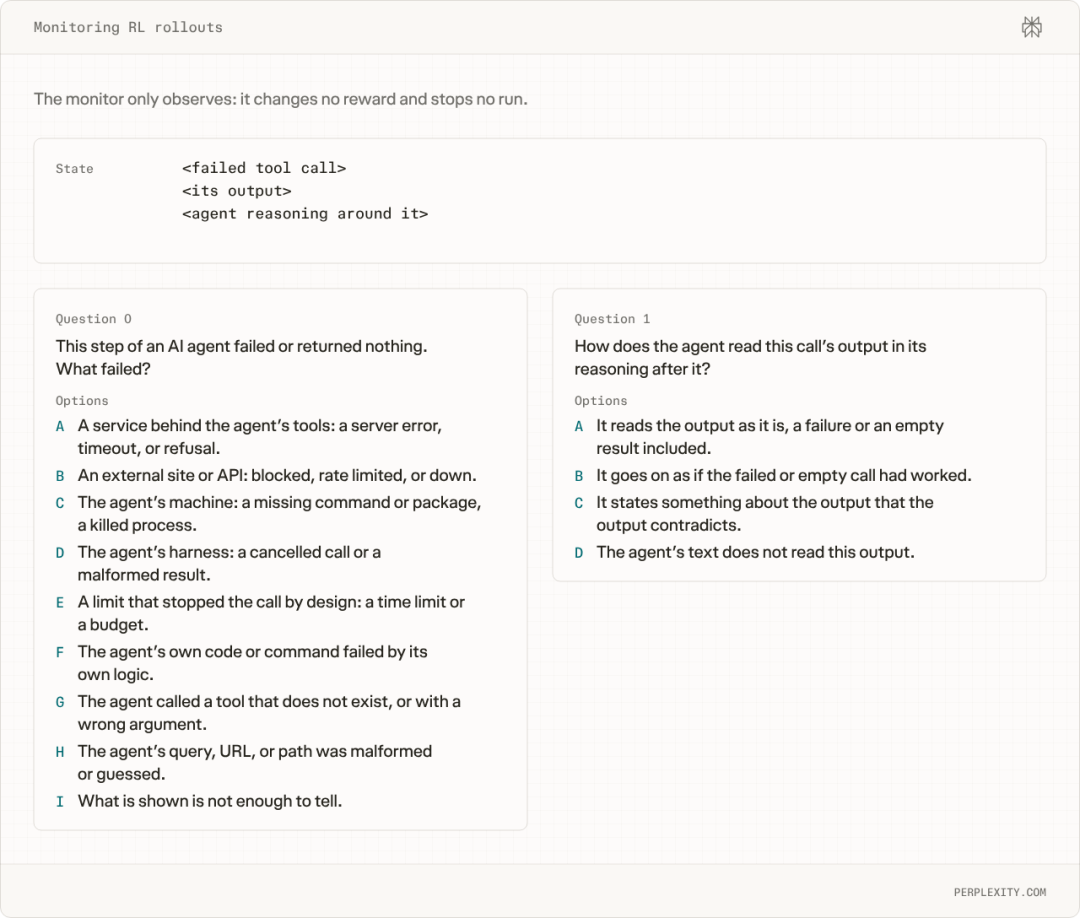
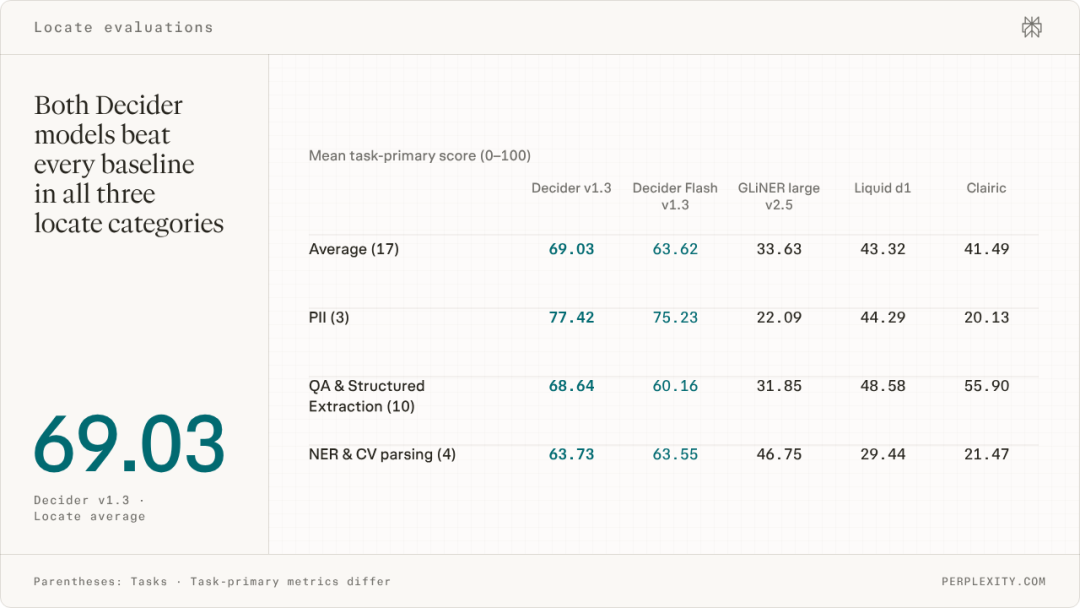
报道所引评测显示,Decider v1.3 在 63 项分类任务上的平均准确率为 91.6%,比 Perplexity 原有生产分类器高 6.54 个百分点。
这是特定任务集合上的结果,不能外推为所有业务场景都能达到同样准确率,也不能据此判断它全面优于通用模型。
值得试用的场景,是对长文档反复进行多项分类,而不是所有生成任务。新增问题仍会增加计算量,实际收益取决于文本长度和并行问题数;上线前,应把业务正确率和计算收益一起验证,而不是只看一次请求能塞进多少问题。
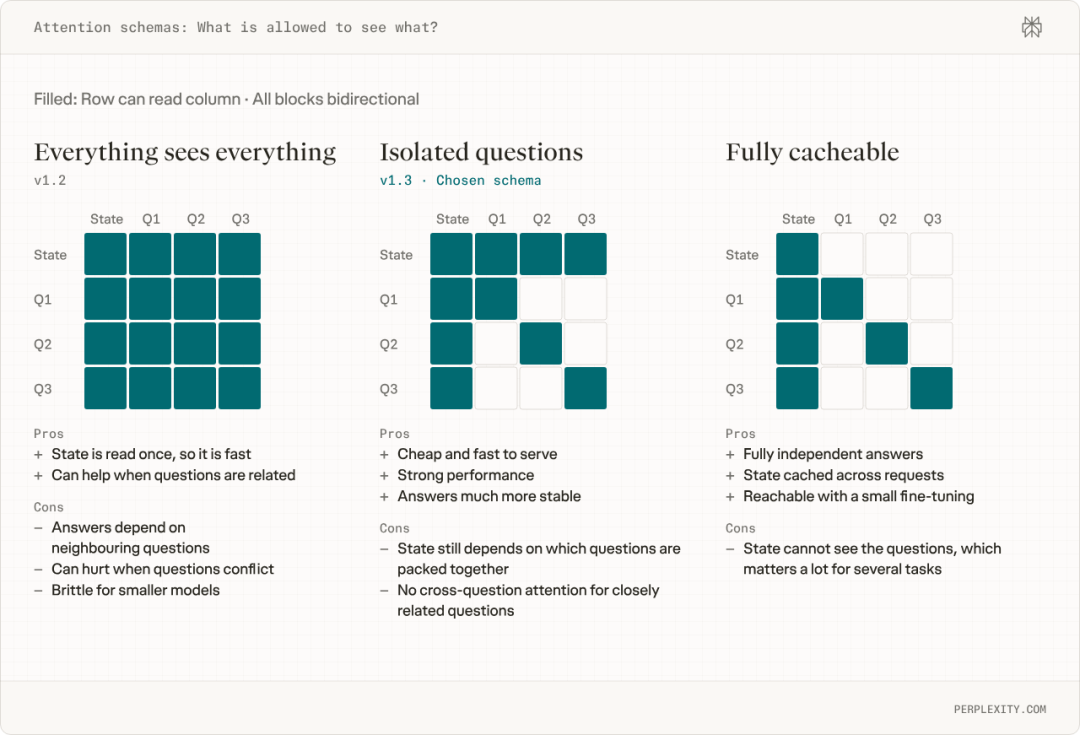
Nota:新版调整了注意力机制,让多个问题共享上下文,但不能直接读取彼此的信息。这个设计不能直接等同于“问题之间完全互不干扰”。新增的 Locate 则按字段描述返回原文字符区间,下游程序可以据此提取文本,把分类判断与原文提取衔接起来。
Gemini Decision 1:千项独立判断
另一条相近的产品路线来自 Gemini Decision 1。据雷峰网报道,它支持文本、图像、音频、视频和 PDF 混合输入,单次请求最多并行处理 1000 项独立判断,直接返回候选项概率和置信度,免收输出 Token 费用。
这里最重要的限定词是“独立”:前一项结果决定后一项怎么判断的任务,仍需分轮提交。
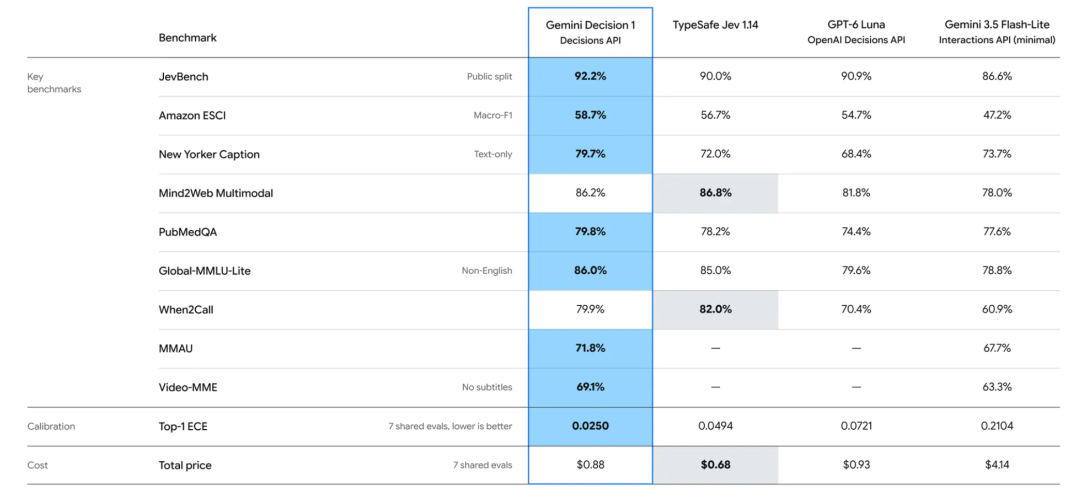
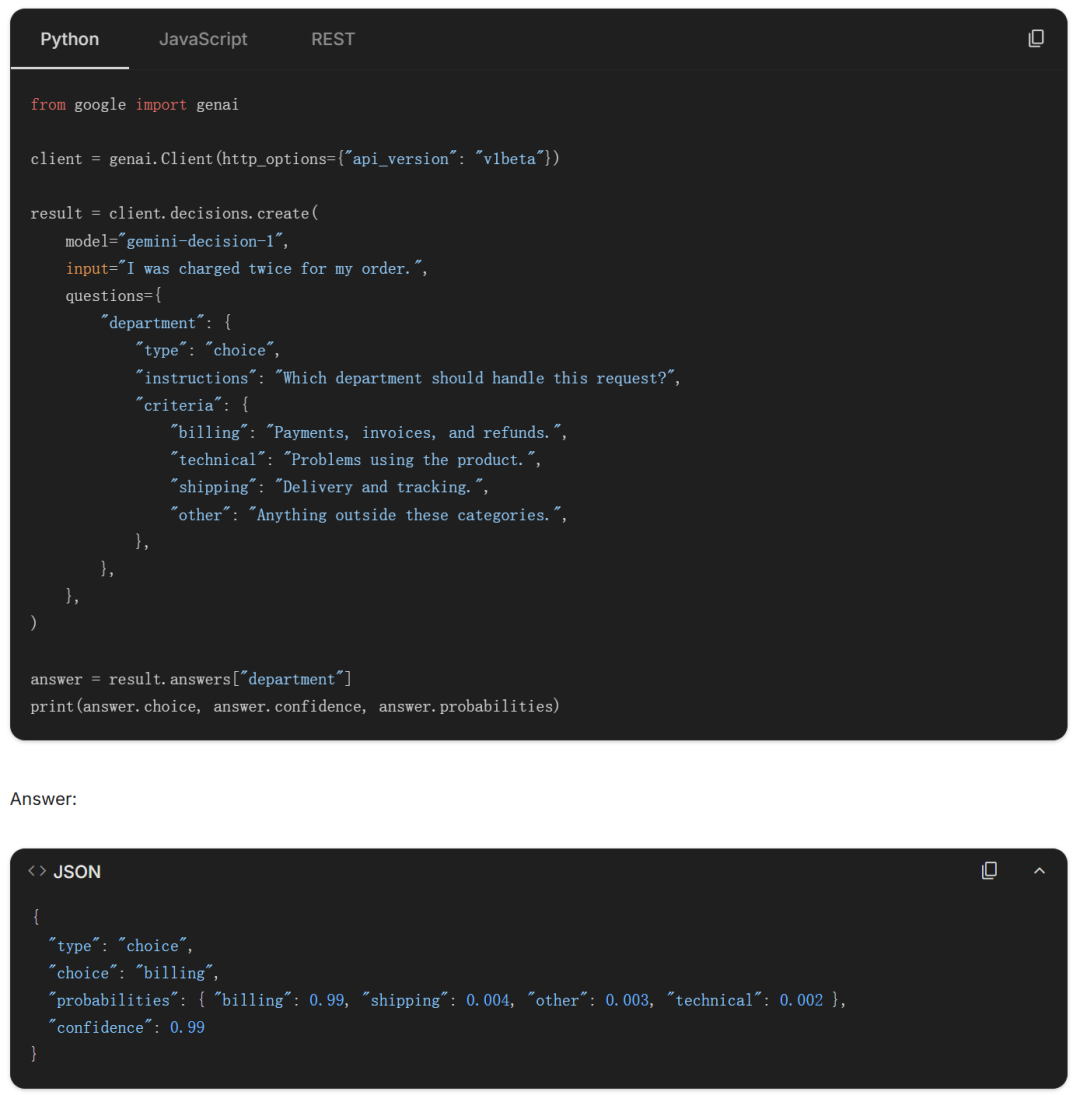
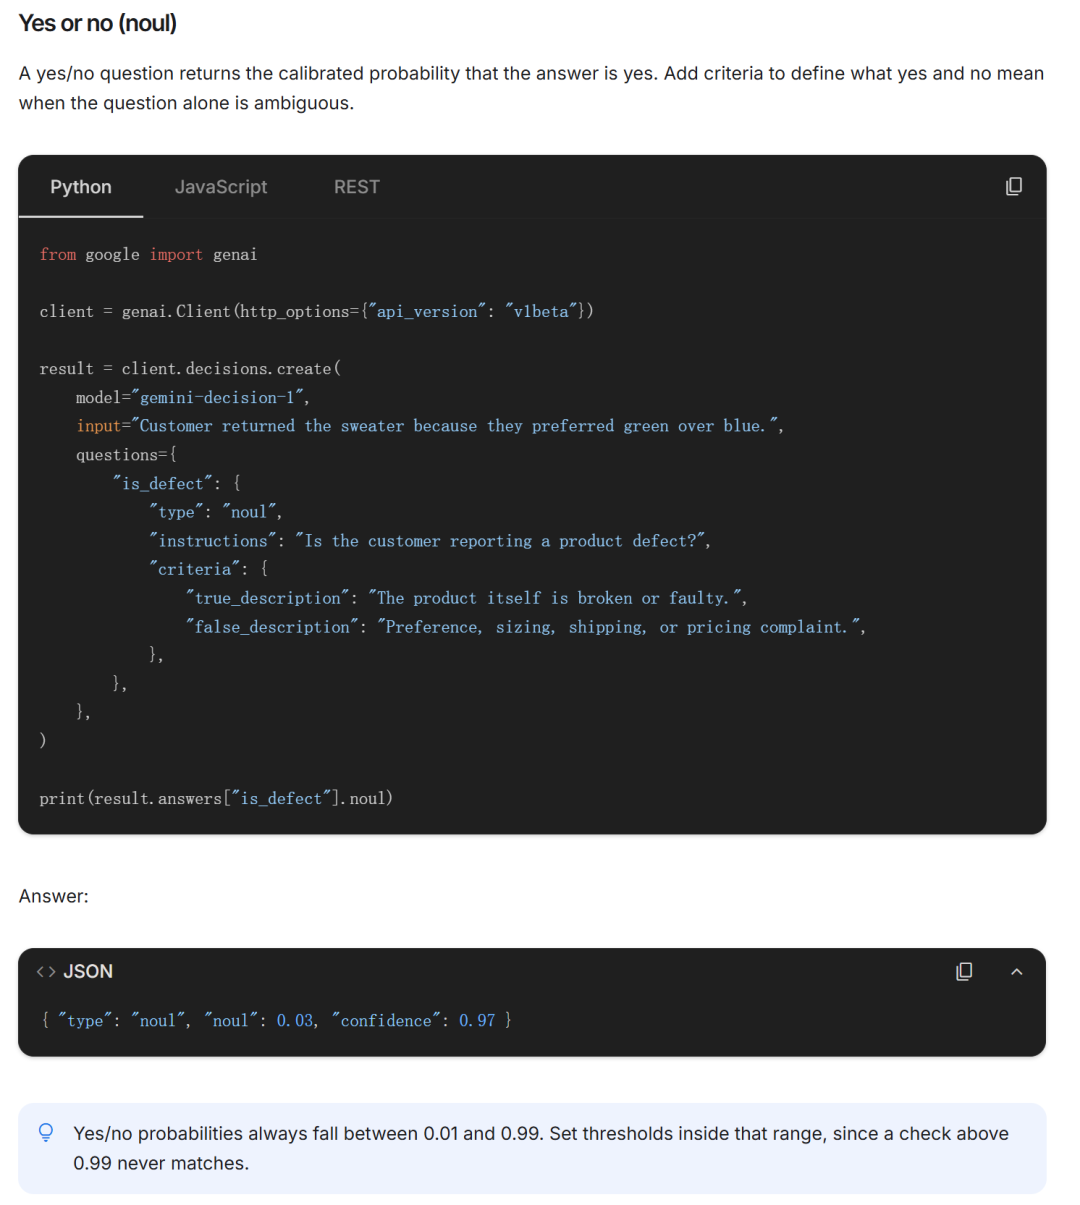
计费也不能简单理解为“批量就免费”。共享材料只计费一次,各项判断仍按自身指令和标准额外计费。报道还称,其输入单价约为 Jev 的 2.38 倍,因此批量调用能否省钱,取决于同一份材料能复用多少次。
性能比较同样需要保留边界:报道中的谷歌 7 项共同基准有 5 项由 Gemini 获胜,但第三方 Artificial Analysis 综合榜上的相对结果不同。
对文档审核或设备巡检团队,更实用的判断顺序是先拆清任务依赖,再估算材料复用量,最后用自己的数据测准确率;目前这些信息不足以支持全面领先的结论。
Nota:Lo anterior son los puntos clave del texto original; el alcance de su aplicación se regirá por los documentos oficiales.
Neon 上线多个入口,多模态只输入不生成
据爱范儿报道,Gemini 4 Neon 发布当天即上线 AI Studio、Gemini App、企业 API 和编程环境 Antigravity,开发者无需排队申请。
它支持 100 万 Token 上下文,每百万输入、输出 Token 分别收费 3 美元和 15 美元;相对 Carbon 标准价低 25%,但高于 Carbon 的限时促销价,不能概括为全面降价。
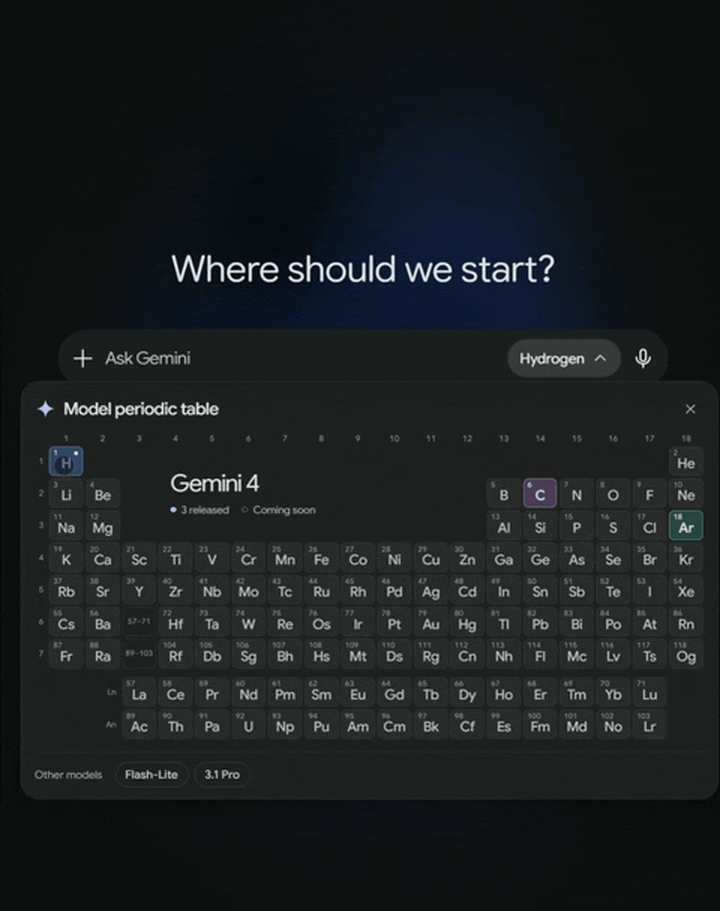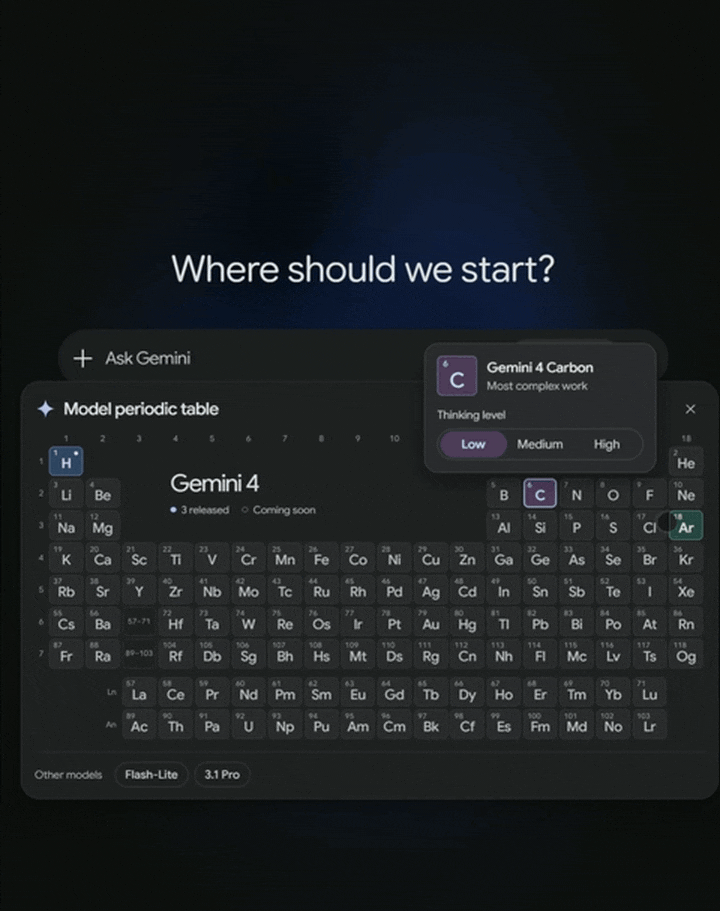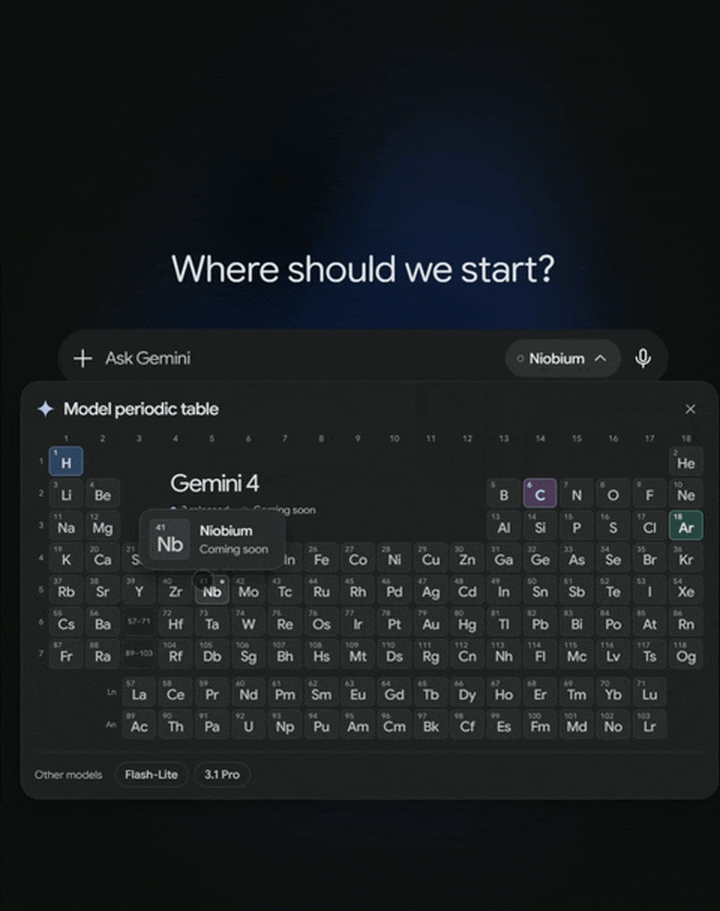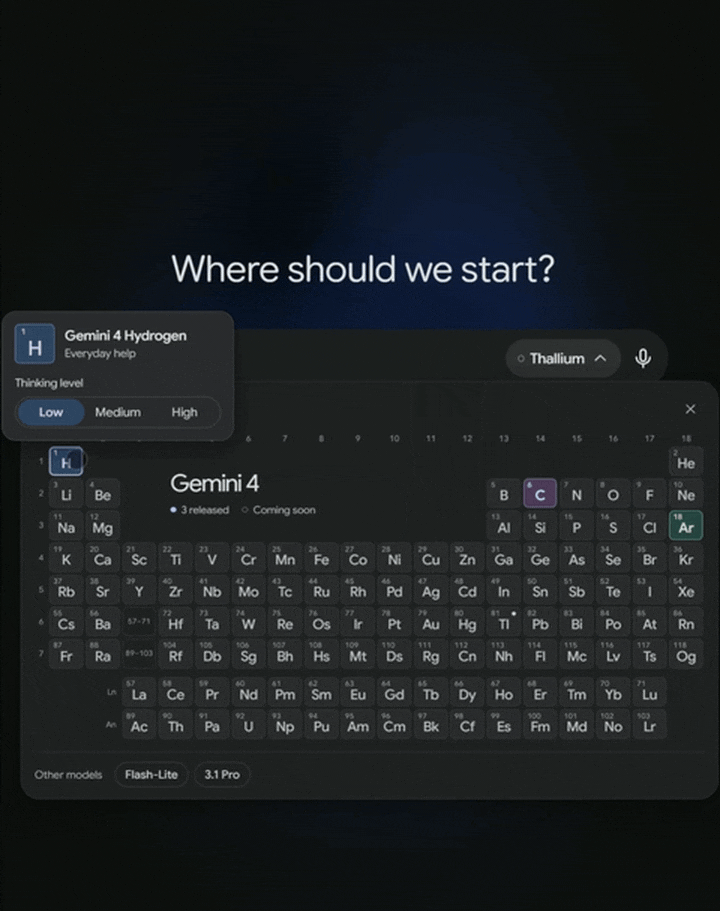
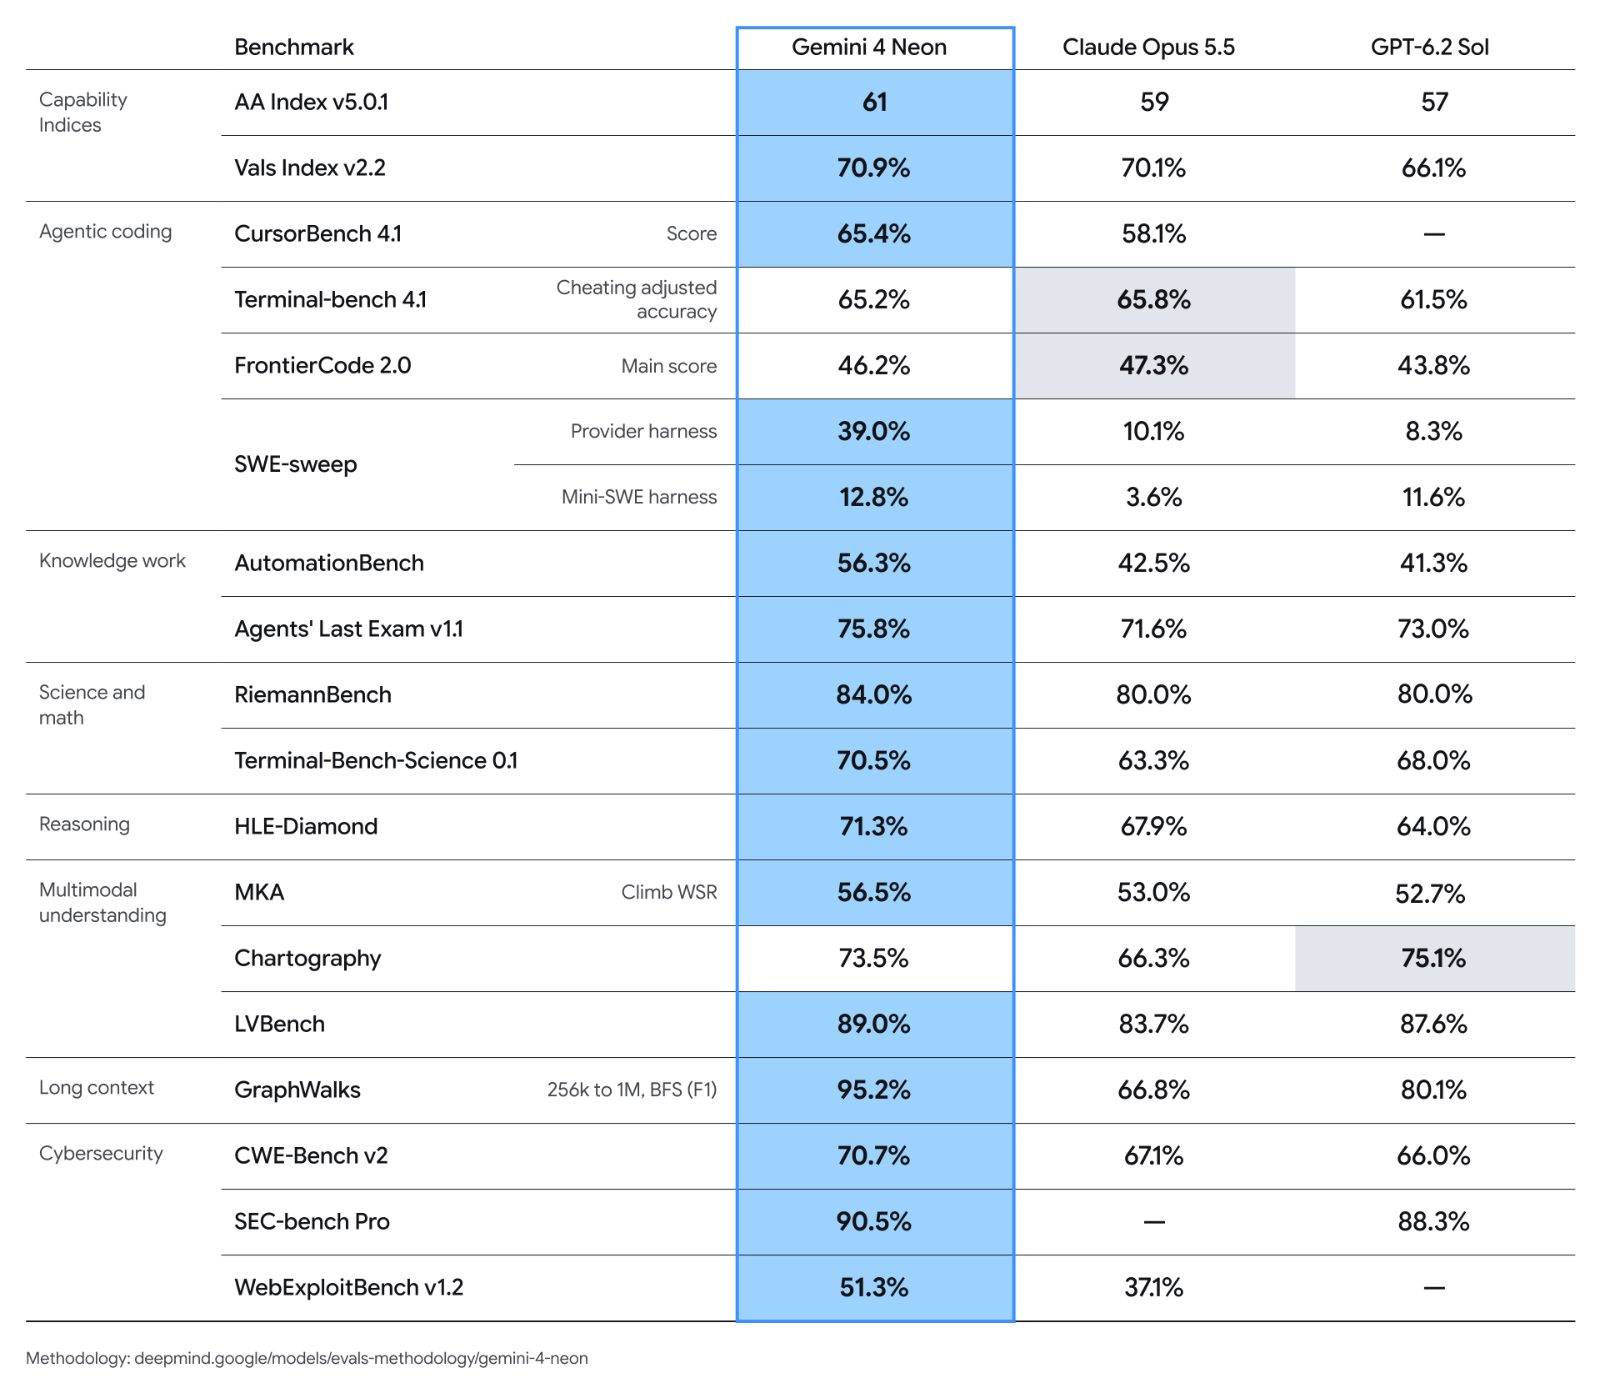
谷歌公布的测试中,Neon 在长上下文检索 GraphWalks 上取得 95.2%,高于 Opus 5.5 和 GPT-6.2 Sol,但命令行与部分代码测试仍由 Opus 5.5 小幅领先。
选型时应分开看长文档检索、实际编程表现和任务成本,单项检索成绩不足以替代完整工作负载测试。
补充能力边界,The Decoder 的报道列出:Neon 支持文本、图片、视频、音频和 PDF 输入,提供约百万 Token 上下文,最多可输出百万 Token。
它可调用电脑操作、代码执行、文件搜索,以及 Google 搜索和地图信息,但不支持图像、音频生成。多模态输入与多模态生成,是两件不同的事。
该报道中的每百万输入、输出 Token 价格同样为 3 美元和 15 美元,均为 Hydrogen 的两倍。
文章注明其发布时基准测试尚未公布,这不能用来否定其他报道中的测试信息。对接入团队,关键是分别确认输入、输出和工具能力,而不是用“支持多模态”概括全部产品边界。
极客公园的报道补充了工程使用方式:Neon 负责架构规划和状态审查,Hydrogen 执行代码修改、包更新与测试,遇到阻碍再交回 Neon 调整计划。这套双模型自动编排的价值,是减少开发者在规划与执行模型之间手动切换。
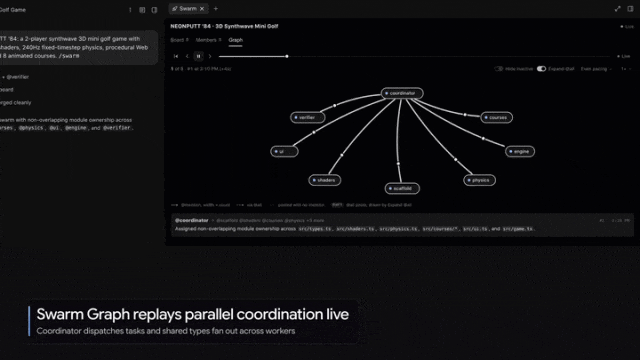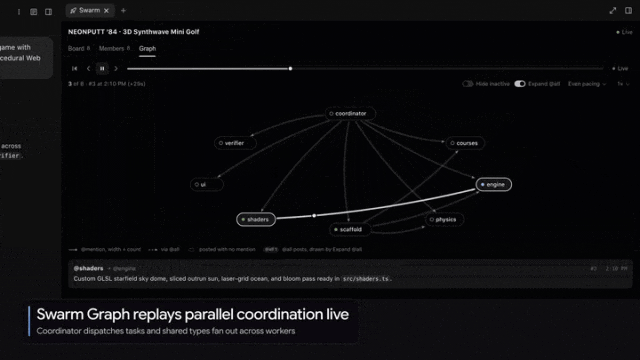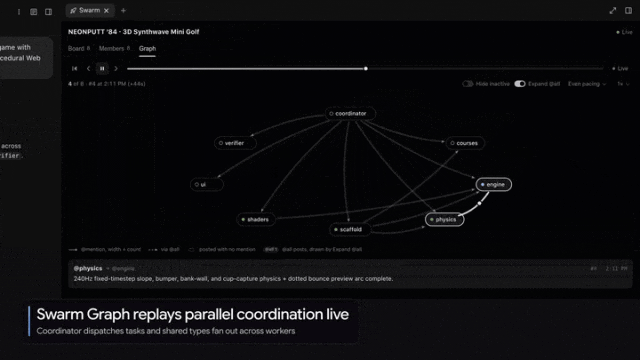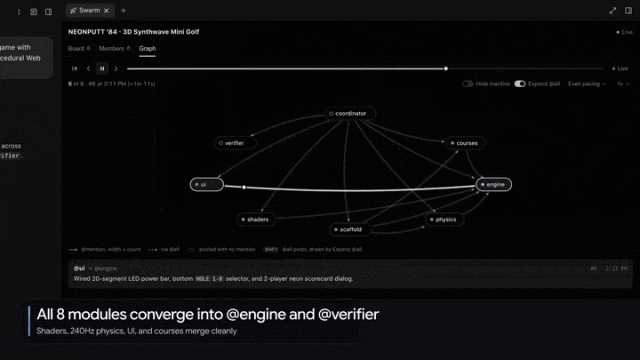
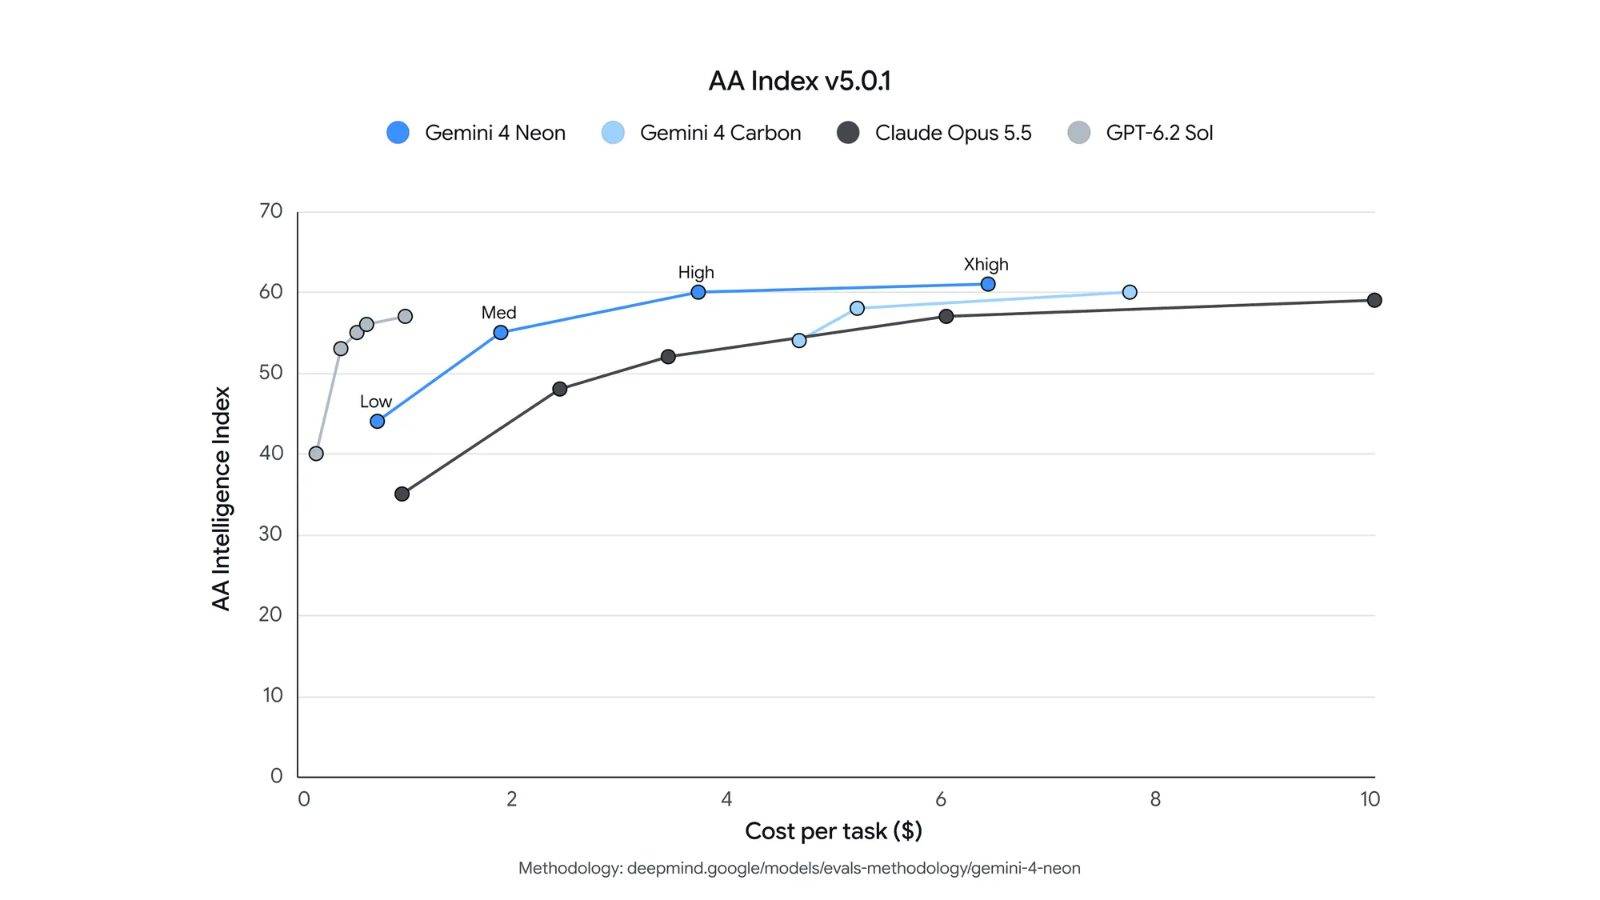
报道援引的 Antigravity CLI 结果显示,平均单任务成本为 6.86 美元,但这是特定环境下的结果,不是通用 API 单任务报价。
该文还称 Neon API 没有免费额度,最高思考档位在 AA 评测中的首答延迟为 56.51 秒。响应速度敏感的产品,应把推理档位、等待时间和任务完成成本一起测,不能只采用一个较低的成本数字。
Nota:Lo anterior son los puntos clave del texto original; el alcance de su aplicación se regirá por los documentos oficiales.
ChatGPT 实时听写取消 10 分钟限制
据 IT 之家报道,ChatGPT 新增实时听写,用户说话时即可同步看到转写文字,不必等录音结束,同时取消听写原有的 10 分钟时长限制。点击音频波形可以查看实时转写,录音结束后,还能在输入框中修改内容。
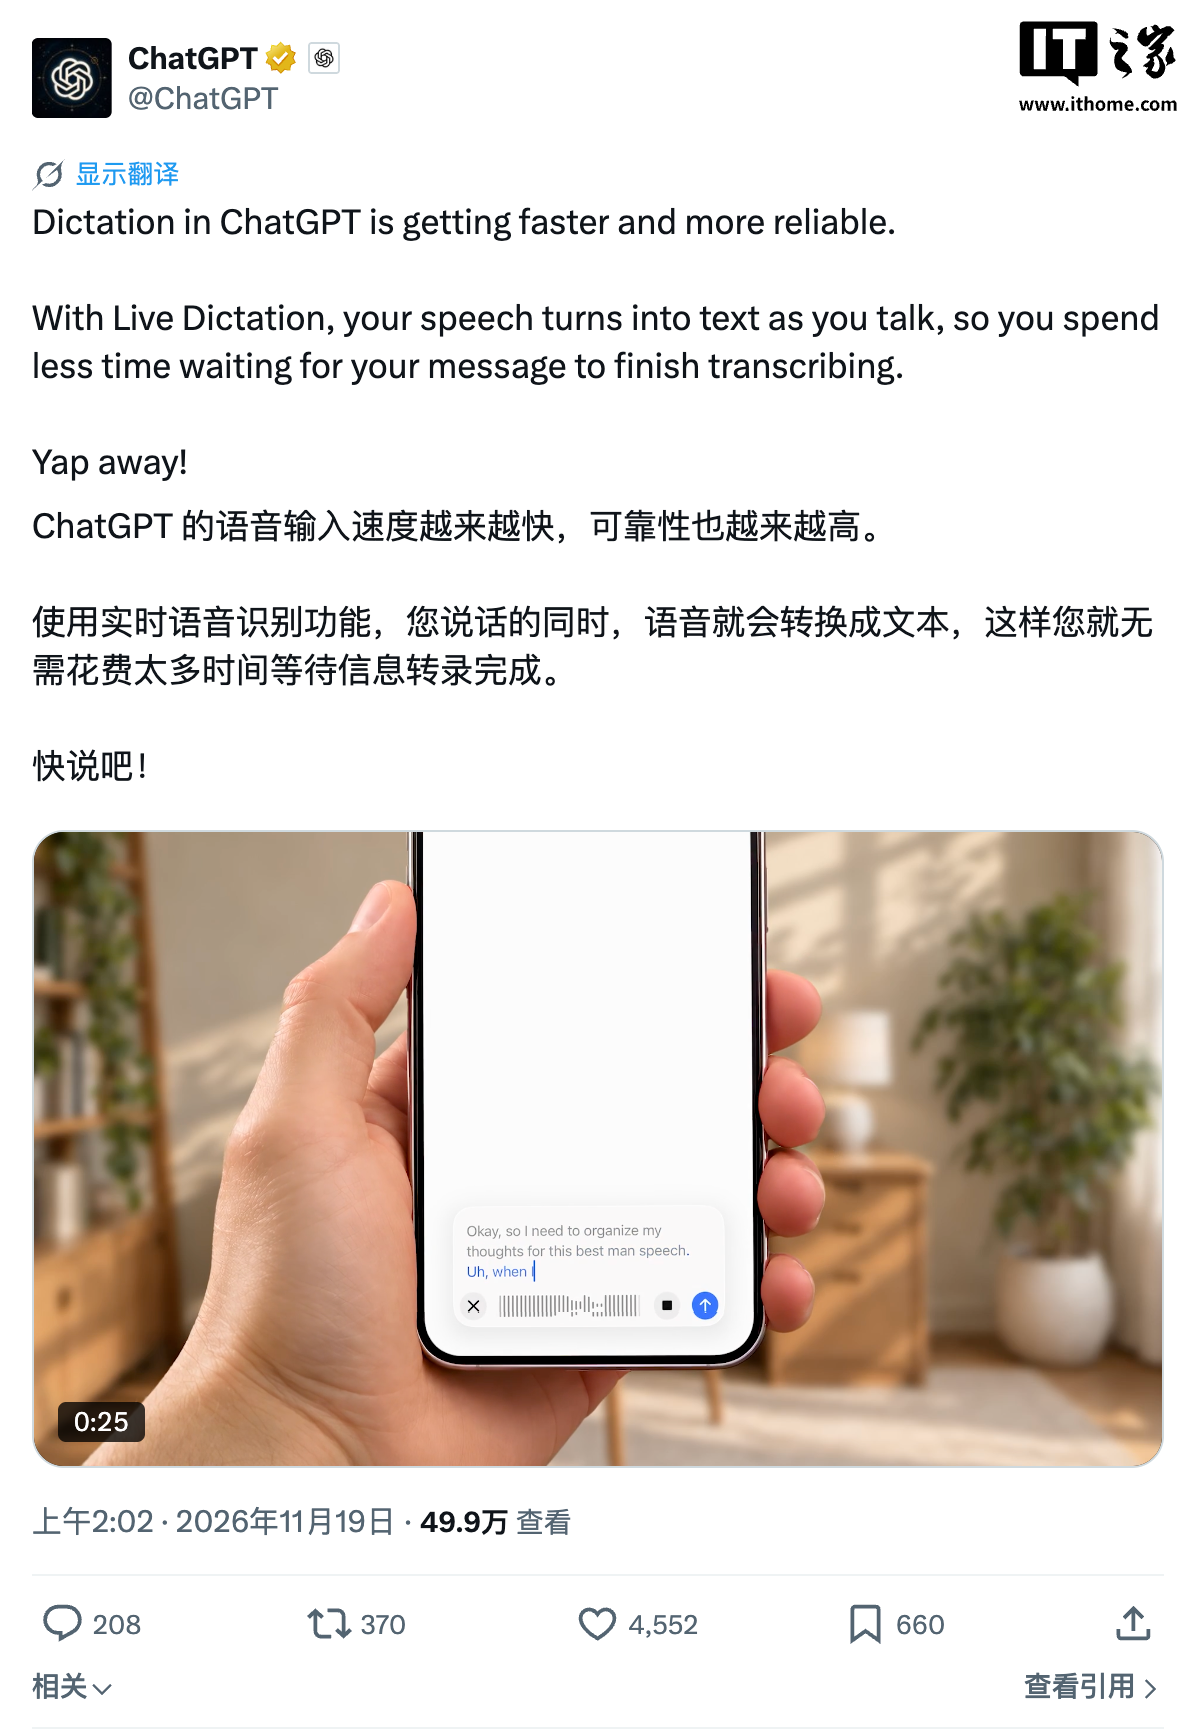
功能将陆续向全球所有 ChatGPT 用户开放,覆盖网页、桌面及 iOS、Android。对习惯口述需求和长提示词的人,最直接的改变是可以边说边检查,再修改提交;它改善的是输入过程,转写内容仍值得在发送前校对。
关于同一项更新,The Verge 的报道明确了开放范围:Live Dictation 正向全球所有套餐逐步开放,覆盖网页、桌面端及 iOS、Android 应用。“逐步开放”意味着这不是所有用户在同一时刻都已可用。
这次变化针对输入框听写。用于转写语音笔记和会议的 Record 录音模式仍处于测试阶段,仅面向指定付费套餐工作区开放。判断自己能否使用时,应先分清是口述输入还是会议录制,不能把听写覆盖所有套餐理解为 Record 也已全面开放。
Nota:Lo anterior son los puntos clave del texto original; el alcance de su aplicación se regirá por los documentos oficiales.
Anthropic 据报发行 813.4 亿美元
据爱范儿报道,Anthropic 以每股 83 美元发行 9.8 亿股,公开发行规模为 813.4 亿美元。
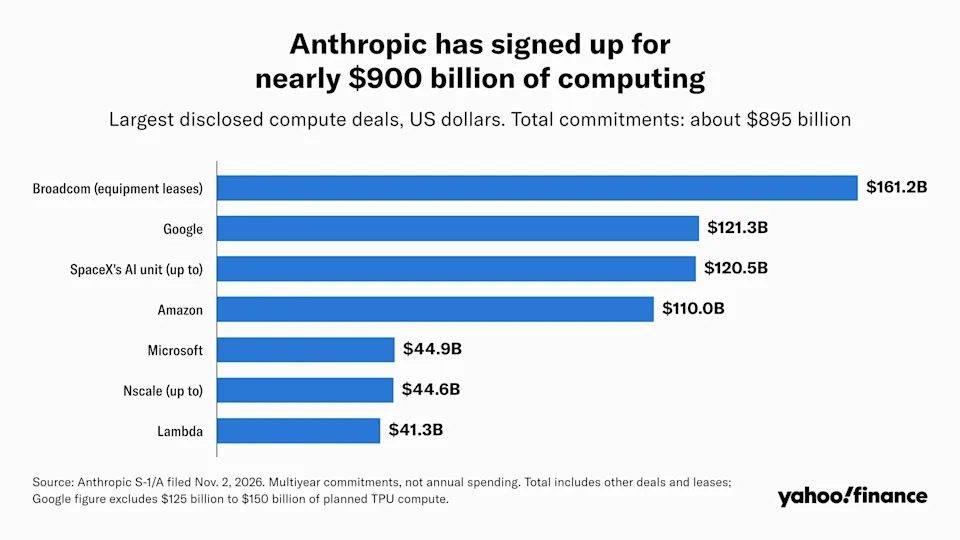
这个数字是发行规模,不能直接当作公司净所得。报道援引招股书称,公司承诺的算力及基础设施采购、租赁支出达 9009 亿美元,募资首要用途是购买更多算力。
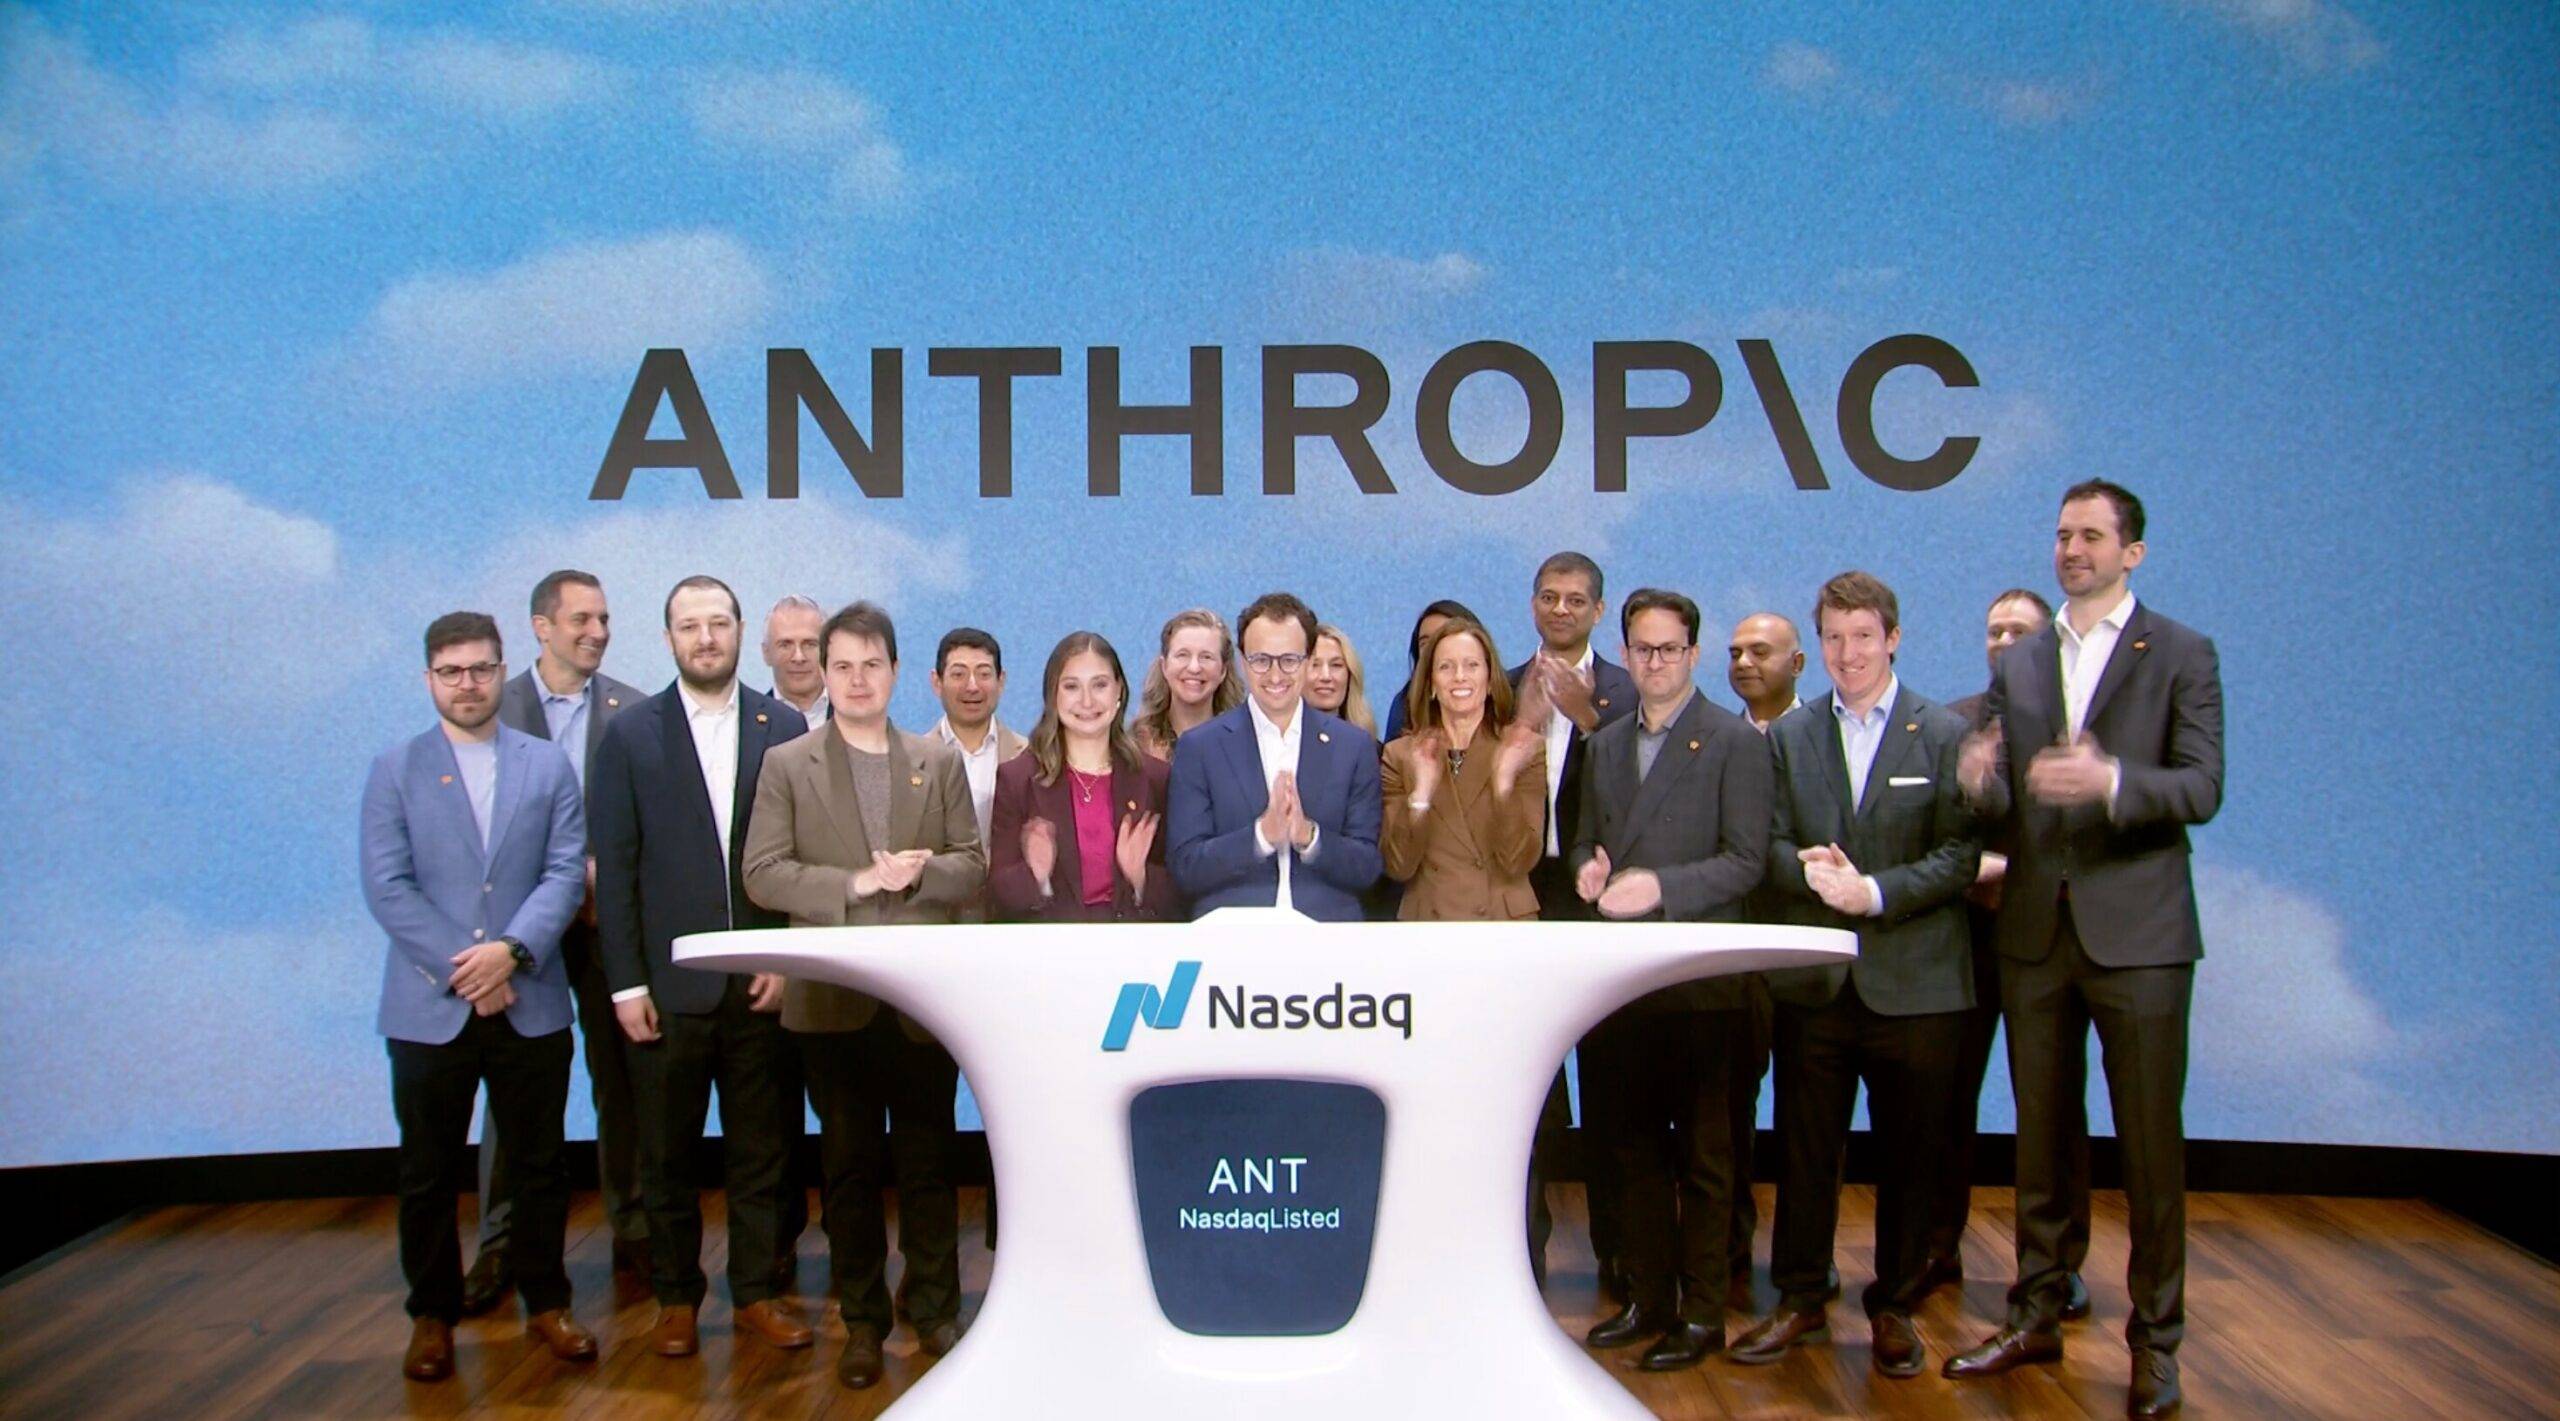
争议也围绕扩张与控制权展开:据报道,近百位研究者和企业创始人联署公开信,质疑其以安全为名扩大控制权;创始人持有的股份锁定 50.1% 投票权。
前者是联署者的批评,不应写成已经证实的动机。对 Claude 用户,发行规模不能直接回答新能力何时上线,更值得持续核对的是治理安排如何约束扩张决策。
发布端还有另一道约束。报道援引 CEO 达里奥·阿莫代伊的话称,安全措施开发是模型部署的主要瓶颈,公司在报道所述年度已因安全顾虑暂缓发布一款新模型。对企业客户,值得追踪的是能力开放时间和部署限制,而不是把融资完成等同于服务能力已经增长。
The Verge 对同一事件的讨论聚焦治理。Anthropic 高管主张,只有赢得竞争才能完成安全使命,而领先需要大量资金和算力。公司注册为公益公司,董事会须平衡使命与股东利益,但这项制度安排本身并不能回答所有安全问题。
该报道认为,旨在隔离股东盈利压力的治理结构,也削弱了对管理层权力的常规制衡;这是媒体的评价,需要保留观点归属。对采购团队,更有判断价值的是研发速度与安全要求发生冲突时的实际决策,以及谁能约束这些决策,而不是仅凭公益公司身份判断安全程度。
Nota:关于同一上市事件,《连线》以约 810 亿美元的口径报道募资规模。其指出,数据中心投产或扩建推迟,可能影响更强模型的训练;因此,获得资金并不意味着训练和交付能力能同步增加。
研究:共享容量信息,Agent 仍未用满资源
一篇关于多 Agent 资源使用的论文,把问题放在两个模拟服务器之间:语言模型 Agent 选择服务器提交任务,其中一个服务器已经恢复,但状态报告仍将其列为不可用;每台服务器每轮容量有限,被拒绝的任务需要重试。
研究关注的是,容量变化后,共享可用资源的证据能否帮助群体充分利用资源。
论文标题给出的结论是,即使共享了容量增加的证据,Agent 群体仍存在资源利用不足。现有摘录没有提供具体实验数值、模型配置或完整比较结果,这些还需要查看论文全文确认。
这是一条独立的协作工程观察,不能拿来证明 Decider 或 Gemini Decision 1 的效果。
Nota:Lo anterior son los puntos clave del texto original; el alcance de su aplicación se regirá por los documentos oficiales.
HiGAI-Net:加密下识别生成式 AI 流量
另一篇论文 HiGAI-Net 关注生成式 AI 服务的加密流量分类。其摘要指出,无线接入网目前缺少在承载层可靠识别 ChatGPT、Microsoft Copilot 或 Google Gemini 流量的方式。
加密握手和 ECH 等机制限制了被动检查可获得的信息,Gemini 部分转向 QUIC 后,SNI 的可见性也取决于 ECH 是否部署。
论文把问题落在网络服务质量上:缺少逐流应用身份,就难以为生成式 AI 服务实施差异化 QoS。
摘要列出三层分类的加权 F1:AI 与非 AI 流量门控 98.5%,ChatGPT、Copilot、Gemini 服务分辨 86.4%,文本与语音/视频模式区分 61.0%。完整方法与泛化表现仍需看论文全文确认,这些分层指标不能说明已具备成熟商用能力。
Nota:Lo anterior son los puntos clave del texto original; el alcance de su aplicación se regirá por los documentos oficiales.
Enlaces de referencia
- 雷峰网:Decider v1.3:多题共享文档,结果可定位到原文
- 雷峰网:Gemini Decision 1:最多 1000 项独立判断,依赖任务仍需分轮
- 爱范儿:Neon 已上线多个入口,每百万输入、输出 Token 为 3 和 15 美元
- THE DECODER:Neon 能接收多模态材料,但不生成图像和音频
- 极客公园:Neon 与 Hydrogen 分工编排,低任务成本也要连同延迟看
- IT之家:ChatGPT 实时听写:边说边看,取消原有 10 分钟限制
- The Verge:听写覆盖范围扩大,不等于 Record 会议录制同步开放
- 爱范儿:Anthropic 被报道公开发行 813.4 亿美元,扩张与治理受关注
- WIRED:资金之外,Claude 扩张仍受机房建设与安全措施约束
- The Verge:公益公司身份之外,Anthropic 的安全承诺如何落实
- arXiv:研究观察:共享资源信息,不代表 Agent 能充分利用容量
- arXiv:HiGAI-Net 研究:加密条件下,如何识别生成式 AI 流量


评论列表 (0条):
加载更多评论 Cargando...