


BLOG / 2026.11.11
Meta 最小的 Muse 模型,把一次评测任务的成本压到了约 0.14 美元——这是官方博客对 Muse Ember 的说法。
官方博客标注的发布日期是 2026 年 11 月 9 日,页面元数据为 00:00 UTC,即北京时间 11 月 9 日 08:00,距今已超过 48 小时。11 月 10 日小互发了完整解读,官方定价、评测表和评测报告今天仍可核对。
官方把它称为目前最小、最高效的模型,面向复杂推理的执行,以及 Agent 每天反复要做的步骤:工具调用、编程子任务、路由、抽取和长文档解析。本站没有接入该 API。
官方原文写:在任一推理档位,它的单位美元智力都高于 Claude Haiku 5.5 和 GPT-6 Luna;它用大约三分之一的成本追平 Haiku 的最高分,并且单次 Artificial Analysis 任务成本约为 0.14 美元。
它被放在重复劳动那一层
博客把产品线分得很清楚:Muse Wonder 负责最难的问题,Muse Spark 负责编程和 agentic 工作流,Muse Ember 负责可规模化重复的编程与代理任务。
Ember 是首个用 Muse Wonder Full 训练出来的专用小模型,原生理解文本、图像、音频和视频,上下文窗口 1M token,输出最多 512K token。
多模态在这里是拿来干活的。官方举的例子是:让 Agent 直接读截图、图表和扫描件,处理语音备忘、会议录音和视频,或者看着截图直接操作电脑,不必再挂一个单独的模型。
这个分层本身就限定了读法。官方的建议是:最难的题交给 Muse Wonder 做规划,Muse Ember 负责跑量。它承担的不是旗舰角色。
安全方面,官方称发布前按 Meta Superintelligence Scaling Framework 评估了化学与生物、网络安全和失控风险,所评估的类别都低于该框架的高风险阈值。
官方还评估了它代用户行动时是否遵循意图、如何处理敏感信息、能否拒绝藏在网页或工具输出里的改向指令,以及高影响操作前是否征求人的意见。
这些是官方安全声明,不是第三方审计结论。官方也强调,尽管是小模型,它接受的是同一套核心安全训练和测试。
0.14 美元是官方约数,曲线上还有更细的点
先看标价。提示不超过 200K token 时,每百万输入 0.10 美元,缓存输入 0.004 美元,输出 0.50 美元;更长的提示是 0.30、0.012 和 1.50 美元。
模型标识为 muse-ember-1.0,可在 Muse Code 和 Meta Model API 调用,支持 Responses API。
「约 0.14 美元一次任务」写在官方正文里,对应的是 Artificial Analysis 任务成本,是个约数。
同一页的成本曲线按标价估算,给了两个更细的点:0.116 美元对应 33.9 分,0.136 美元对应 35.8 分。Haiku 5.5 最高档在这张图上是 0.411 美元、36.2 分。
图注同样要读:曲线取自 Artificial Analysis 的原始结果,其中 Ember 的成本是按拟定定价估算的,并非实际账单。
按这两个点算,0.136 美元约为 0.411 美元的三分之一,和官方「约三分之一成本追平 Haiku 最高分」对得上;只是 35.8 分仍比 36.2 分低 0.4 分,「追平」是官方措辞。
官方还写,Ember 胜过 Luna 的每一档设置,并处在 Artificial Analysis 完整榜单的效率前线上:没有哪个模型能以更低的单次任务成本拿到更高分。
和 Muse Spark 1.3(max)的官方对照表更直白:Intelligence Index 36 比 37,单次任务成本 0.14 美元比 2.39 美元,单价 0.10/0.50 比 1.25/4.25。
官方表上没有「17 倍」这个词。小互用 2.39 除以 0.14 得到约 17 倍,那是转述里的算术,不是官网原话。
领先的表和落后的表要一起看
官方汇总里,Muse Ember(max)在 AutomationBench-AA 上是 37.8,远高于 Haiku 的 13.9 和 Luna 的 20.2。
Agents’ Last Exam 是 61.6,略高于 57.0 和 57.1;Terminal-Bench 4.0 是 40.9,略高于 Haiku 的 39.2,Luna 只有 16.4。
反过来,FrontierCode 2.0-AA 上 Haiku 是 34.9,Ember 是 27.2,Luna 是 25.2。效率前线不等于每项第一。
其他官方汇总:GDP.pdf-AA 上 Ember 与 Luna 都是 22.8,Haiku 是 20.8;OSWorld 2.1 部分分为 69.5、68.9 和 50.5,官网另列了严格通过率;PerceptionBench(带工具)是 80.6、78.6 和 62.8。
内部综合的 Personal Superintelligence Index 是 46.8、36.1 和 37.0;Coding Agent Index-AA 是 46、37 和 31。这些分数来源不一,有的来自 Artificial Analysis,有的是 Meta 内部评测。
官方评测报告把条件写得更死。Ember 成绩按 max reasoning、经 Meta Model API 产出。
Agents’ Last Exam 用 Linux 任务子集,对所有模型都排除了 105 项中的 5 项;官方排行榜比的是 Codex、Claude Code 这类产品,内部则用同一套 agent loop。
AutomationBench-AA 是 Artificial Analysis 对 Zapier 一套 657 项业务工作流的复跑,主指标是全部目标达成且未违规的 pass@1。
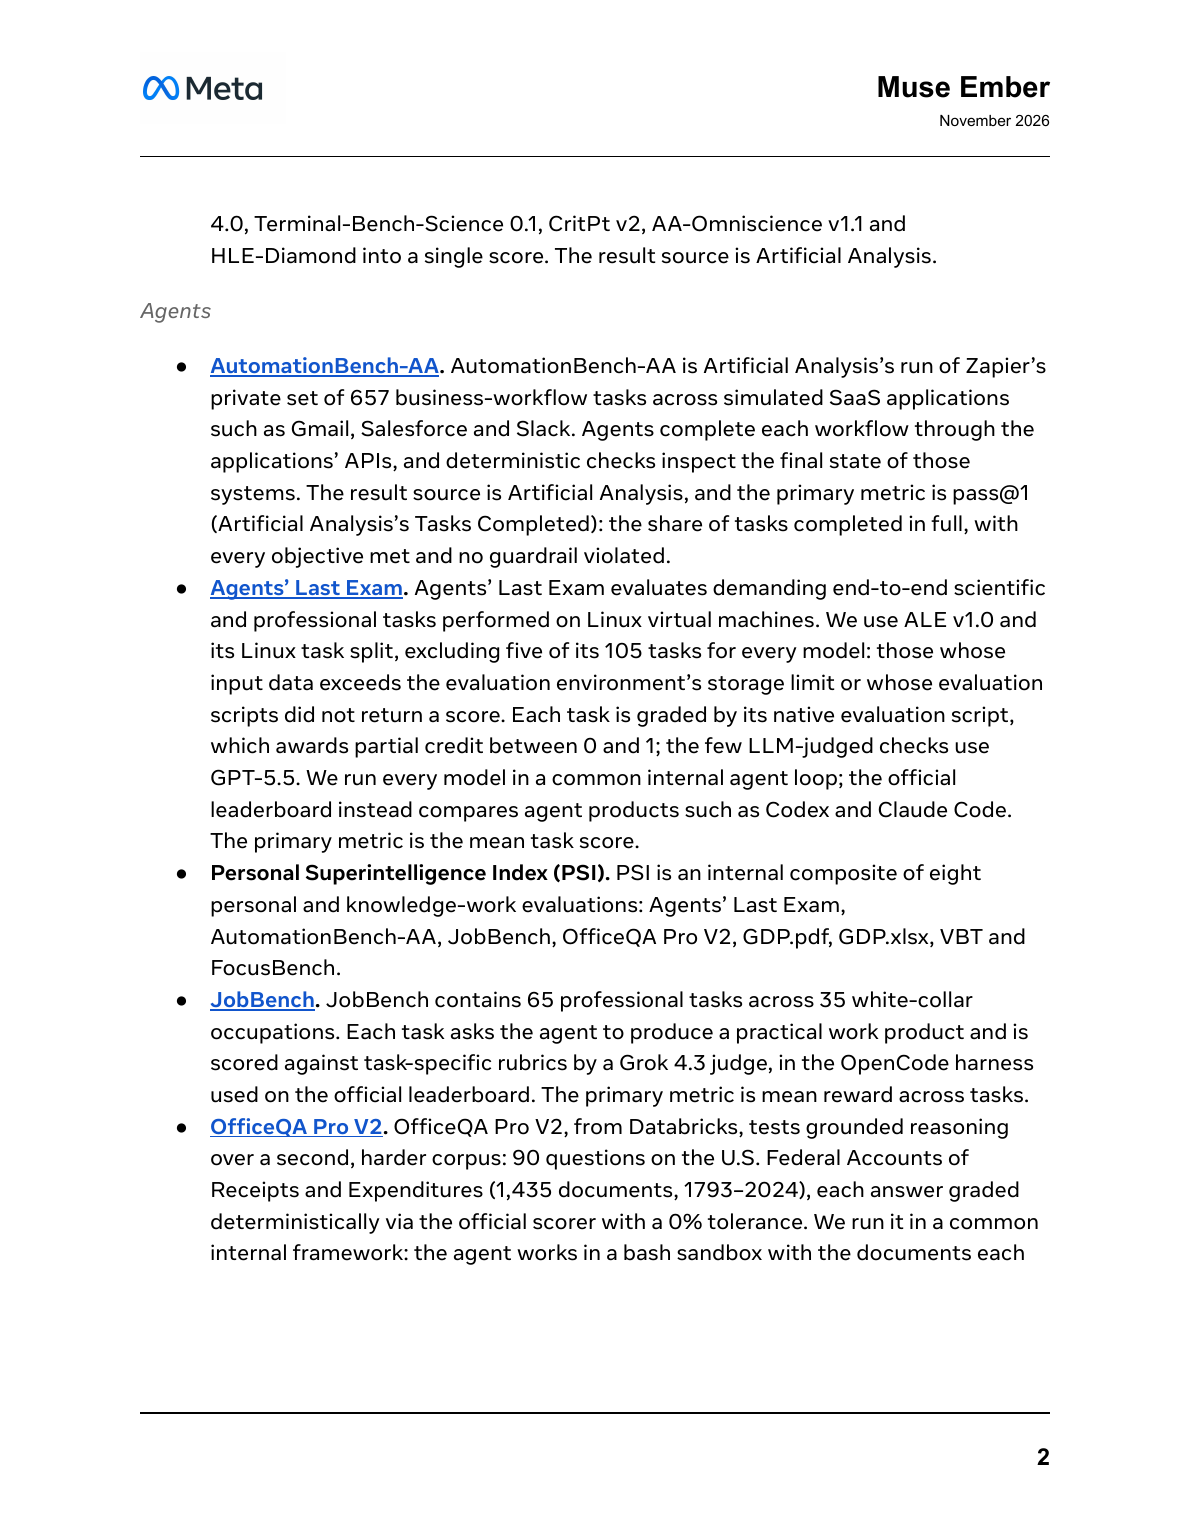
Terminal-Bench 4.0 含 66 项更难的终端任务。
这项上,Ember 用的是 Artificial Analysis 在 mini-swe-agent 上的成绩,Haiku 用 Anthropic 系统卡里的 Claude Code 成绩,Luna 用排行榜上的 Codex 成绩,并不是同一套脚手架。
FrontierCode 2.0-AA 是 Cognition 的真实仓库改动,Artificial Analysis 跑其私有 132 项集,按维护者是否会合并来计分。
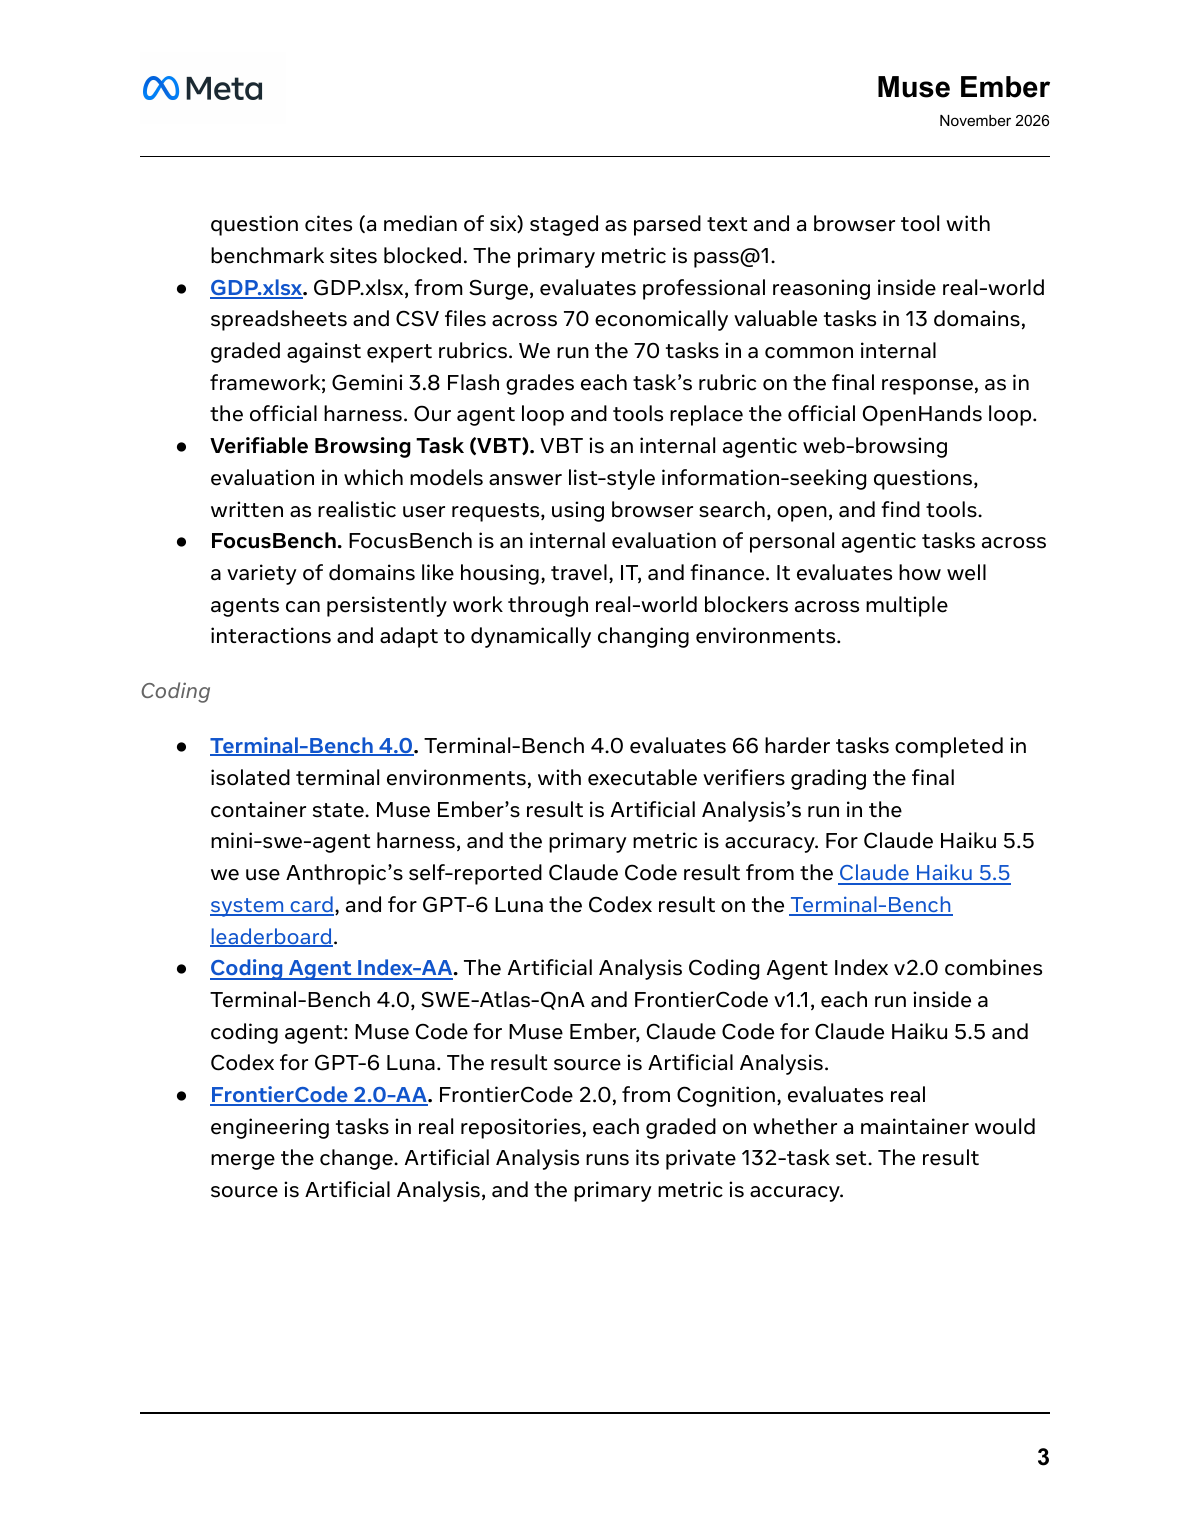
OSWorld 2.1 是 108 项长时间电脑操作,内部用各家自己的 computer-use 配置,而不是官方 runner;PerceptionBench 是 3,000 道短答案视觉题。
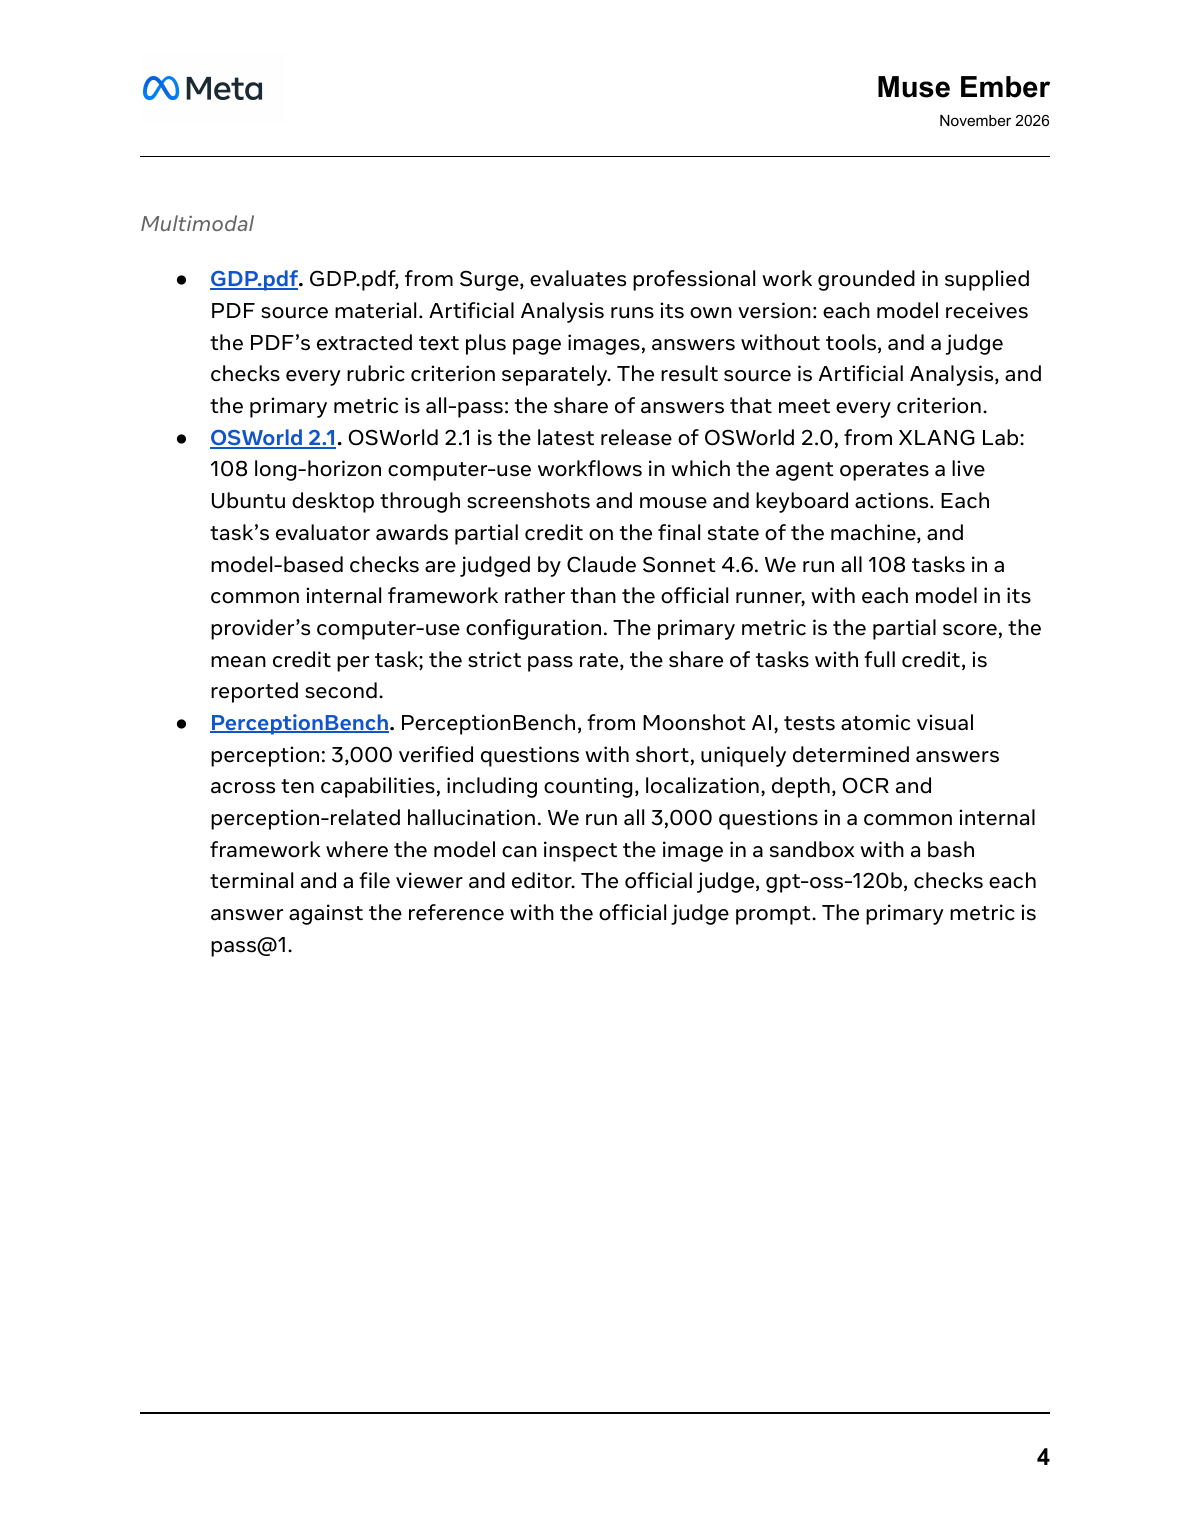
报告还写明,内部对竞品的复跑是尽力而为,提示词和工具未必调到最优。
合作方引言是体验描述,不是可复核的指标
博客引用了 Box、Cline、Oracle、Cloudflare 和 You.com 的早期测试评价。Cloudflare 称尾部延迟最多快约 30%;You.com 称编码任务 p95 为 2.2 秒,输出 token 少 36% 到 48%,比主流开放权重模型快约 4 到 13 倍。
这些是合作方自己的表述,官方没有把它们写成可独立复核的基准分数,这里只当发布配套材料看,不改写成通用性能结论。
能调用,账单还是要按上下文长度算
官方写,Muse Ember、Muse Spark 和 Muse Wonder 现在也可在 Google Cloud 和 Oracle Cloud 上使用。
短提示子任务场景下,0.10/0.50 的标价和「约 0.14 美元一次评测任务」是官方给出的效率故事。提示一旦超过 200K,每百万 token 单价跳到输入 0.30、缓存输入 0.012、输出 1.50 美元。
划不划算,取决于自己的上下文长度和调用次数。评测任务的单价,不能直接乘到生产流量上。官方还写,更高效的模型仍在训练中。
Our assessment:Muse Ember 最硬的官方主张,是在大约三分之一成本上靠近 Haiku 5.5 的最高分。把它理解成全面超越同档模型并不成立:FrontierCode 上它落后,部分内部评测还用了自己的任务子集和不同脚手架。
Reference Links
- Meta AI Research:Introducing Muse Ember
- Meta:Muse Ember Evaluation Report(官方 PDF)
- 小互:单次任务 0.14 美元:Meta 发布最小多模态模型 Muse Ember


Comment List (0):
Load More Comments Loading...