


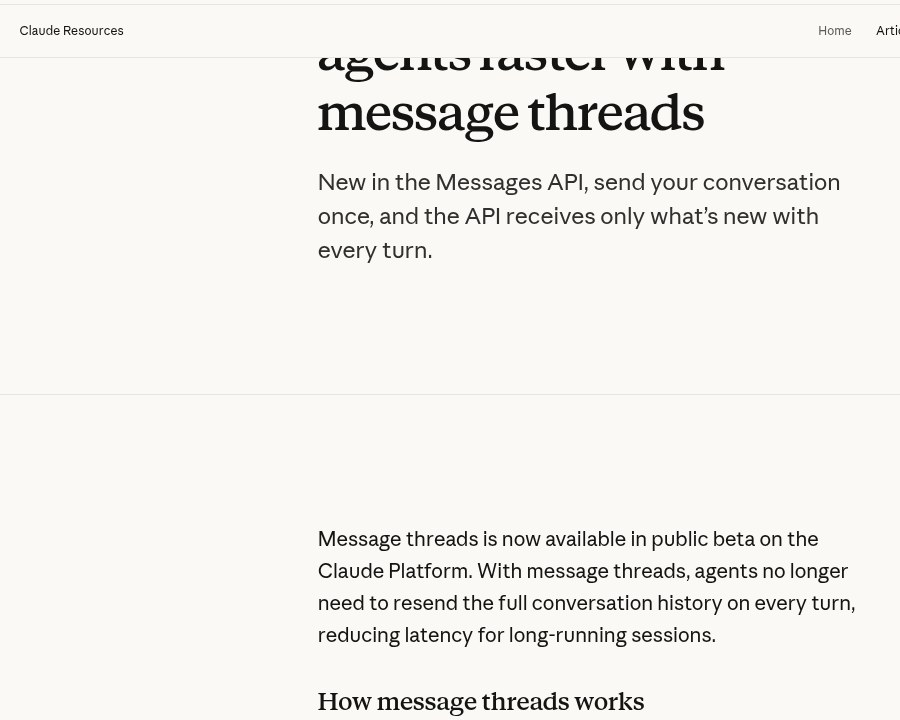
在 Claude Messages API 上跑长会话 coding / computer-use Agent 时,公测 Message Threads 很容易被理解成「少传历史=少花钱」。结论先说:Threads 是延迟工具,不是账单工具——它主要砍上传与重复校验带来的 TTFT;模型仍读全对话,token 用量与价目不变。降成本仍靠 Prompt Caching(以及压缩、编辑、分流)。下文为官方资料解读(核验日 2026-11-05,Asia/Shanghai),不含本站压测数字。
一句话判断
- Threads 解决什么
- 长会话每轮重传整段历史带来的上传/校验延迟;官方资源文称多数 Claude Code 场景下,约 500k–1M token 请求的中位 TTFT 约降 35%。
- Threads 不解决什么
- 不改定价与速率限额;不替你做 prompt cache;不永久存会话。
- 账单怎么砍
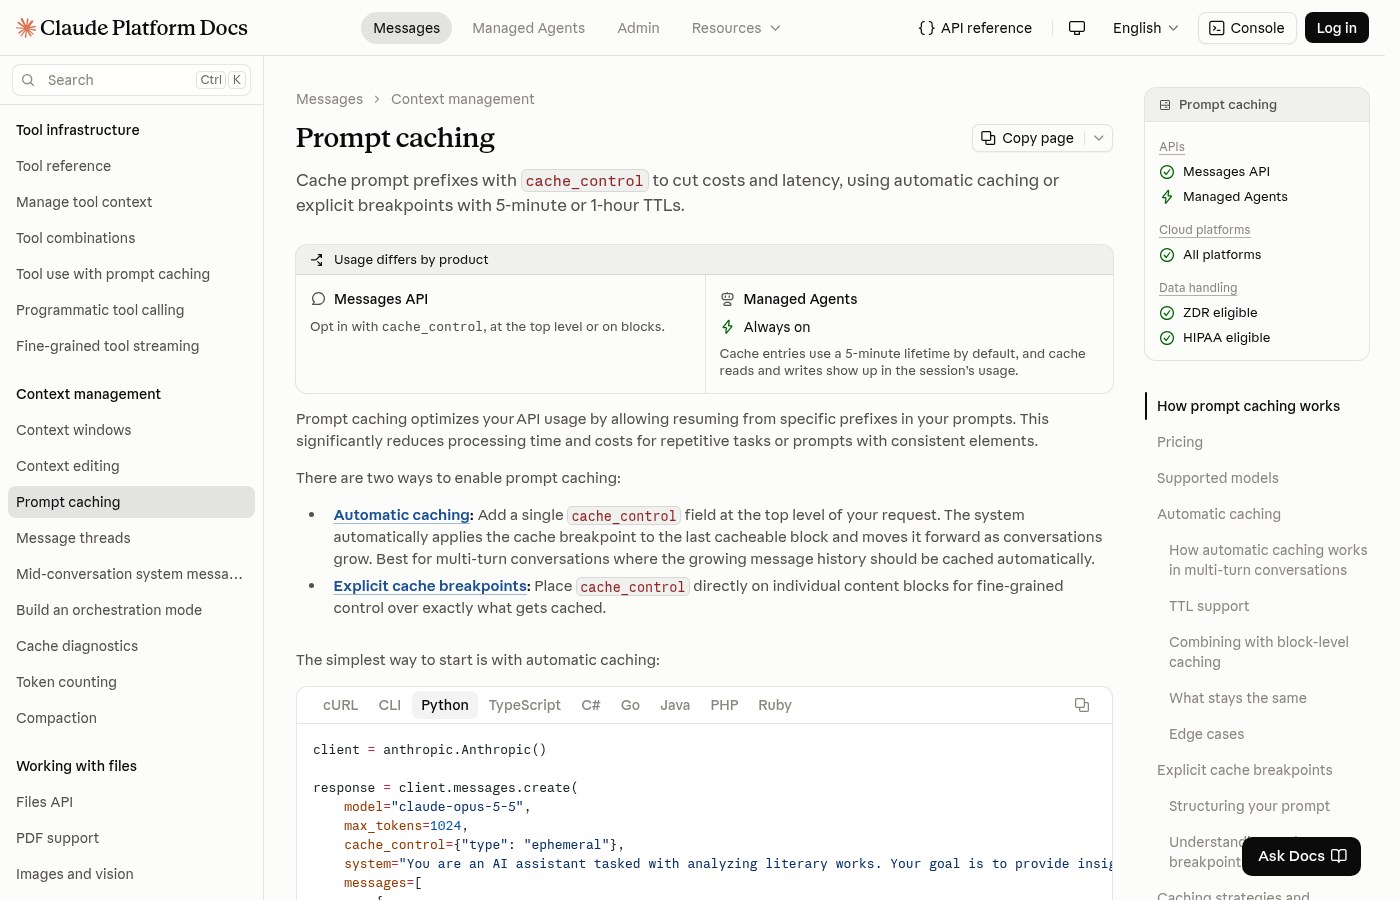
- 继续用 Prompt Caching(自动或显式 breakpoint),必要时配合摘要压缩与编辑策略。
先分清:延迟工具 vs 账单工具
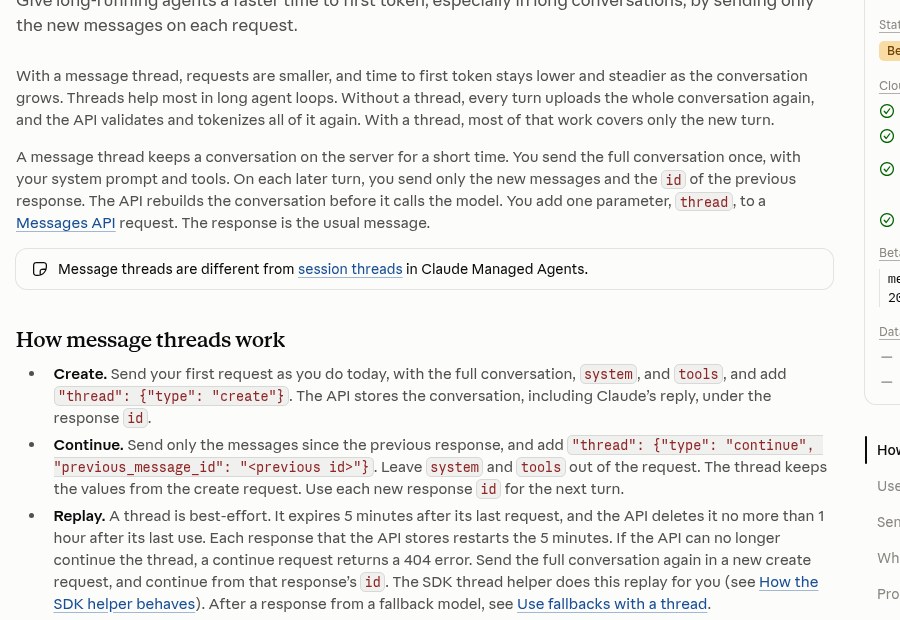
长 Agent 循环里,每一轮若都把 system、tools、整段消息再上传一遍,网络与服务端校验会拖高 TTFT。Message Threads 让你在 create 时送全量,后续 continue 只送新增消息和上一轮 response id;API 在服务端重建对话后再调模型。
重建不等于「模型只看新消息」。官方写得很清楚:请求变小了,但 Claude 每轮仍读完整对话,token 用量不变;Threads 不改变定价或速率限额The
| dimension (math.) | Message Threads | Prompt Caching |
|---|---|---|
| 主要收益 | 降低上传/校验带来的 TTFT | 降低重复前缀的计费输入(cache read 远低于 base input) |
| 对账单 | 官方:不改定价;用量按完整对话计 | 需显式/自动 cache_control;cache write/read 有独立价目 |
| 生命周期 | 约 5 分钟空闲过期;最多约 1 小时后删除;best-effort | 默认约 5 分钟 TTL,可选 1 小时;与线程相互独立 |
| 客户端职责 | 必须自备完整对话副本,做好 404 重放 | 保持可缓存前缀稳定,监控 usage 中的 cache 字段 |
把 Threads 当成「免费压缩账单」会做错架构:延迟改善了,发票几乎不动。先问瓶颈是 TTFT 还是 $/成功任务,再选工具。
什么时候值得开 Threads
- 适用:活跃长会话——编码 Agent 上百轮 tool_result、computer-use 截图堆积、文档/图片很重、TTFT 已明显随上下文变差。
- 不太适用:短问答、偶发单轮、空闲常超 5 分钟却无重放路径、依赖 Message Batches / on-demand compaction / 组织开启 HIPAA readiness 或 Inference hooks(官方列明 Threads 不支持)。
- 合规注意:Threads 非 ZDR eligible;内容在内存加密、不落盘,并在末次使用后不超过约 1 小时删除。需要 ZDR 路径时不要默认绑 Threads。
接入时必须准备的三件事
- Beta 头:每轮带
anthropic-beta: message-threads-2026-08-12(或 SDK helper 自动加)。 - Create / Continue 字段纪律:
system/tools只在 create;continue 再送会 400。模型与若干 fingerprint 字段须与 create 一致。 - 重放路径:continue 遇
thread_not_found(404)时,用本地副本整段 create 再建线程。SDK helper 可代做一次重放,但进程外持久化仍要你自己存。
# 示意:首轮 create(完整对话)→ 次轮 continue(只送新增)
# 正式字段以当日 docs 为准;此处不替代 SDK 类型检查
curl -sS https://api.anthropic.com/v1/messages \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2026-10-21" \
  -H "anthropic-beta: message-threads-2026-08-12" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-opus-5-5",
    "max_tokens": 1024,
    "cache_control": {"type": "ephemeral"},
    "system": "You are a coding agent.",
    "messages": [{"role":"user","content":"… first turn …"}],
    "thread": {"type": "create"}
  }'
降账单:仍然看 Prompt Caching(可与 Threads 叠用)
官方专章写明:线程不会替你做 prompt cache。Caching 规则与无线程时相同——你要用顶层或块级 cache_control。文档示例在 Threads 请求上放顶层 cache_control: {"type":"ephemeral"},让每轮可读先前缓存并写入新轮次。
叠用时记住几条边界(文档核验):
- 带
thread的请求最多约 4 个cache_controlbreakpoint;顶层 automatic caching 也占一席。 - create 上挂在
system/tools的 breakpoint 会在后续 continue 继续计数;重放 create 时要整理旧消息上的 breakpoint,避免超限。 - 看 usage:
cache_read_input_tokens/cache_creation_input_tokens/input_tokens,不要只看「请求体变小了」。
叠用检查清单(上线前)
- 瓶颈是 TTFT?→ 开 Threads,并验证空闲 <5 分钟或具备重放。
- 瓶颈是输入 token 账单?→ 配 Prompt Caching;确认最小可缓存长度与 TTL。
- 两者都要?→ Threads + 每轮相同的顶层
cache_control;监控 cache hit,而不是假设「少传=少计费」。 - 会话要跨进程/跨天?→ 自建存储 + 摘要压缩;不要把 Threads 当会话数据库。
不适用与翻车点
- 空闲过期:约 5 分钟无请求即可能无法 continue;须本地全量重放。
- append-only:不能在原线程里改历史;编辑/分支 = 新 create。官方 on-demand compaction 与 Threads 不兼容,摘要须你在本地做完再新开线程。
- fallback / refusal:fallback 模型写出的轮次可能不会被线程存储;refusal 后不要 continue 旧线程。
- 指纹不一致:改 model 等 fixed 字段会
thread_fingerprint_mismatchThe
Explanation of the Evidence:本文依据 Message threads 文档,Anthropic 资源文together with Prompt caching 文档(2026-11-05 打开核对)。TTFT「约 35%」为官方对 Claude Code 场景的陈述,不是本站压测。无执行环境,故不写第一人称跑通数字。


Comment List (0):
Load More Comments Loading...