


This article isSide-by-Side Comparison:个人项目上向量库时,我用同一批 embedding、同一组查询Comparison Qdrant,Chroma,pgvector。比的是安装成本、过滤能力、运维负担、本地友好,不是品牌口号。读完你应能选一个今晚装上,并跑通最小检索。
横评开场:同批嵌入我怎么控变量
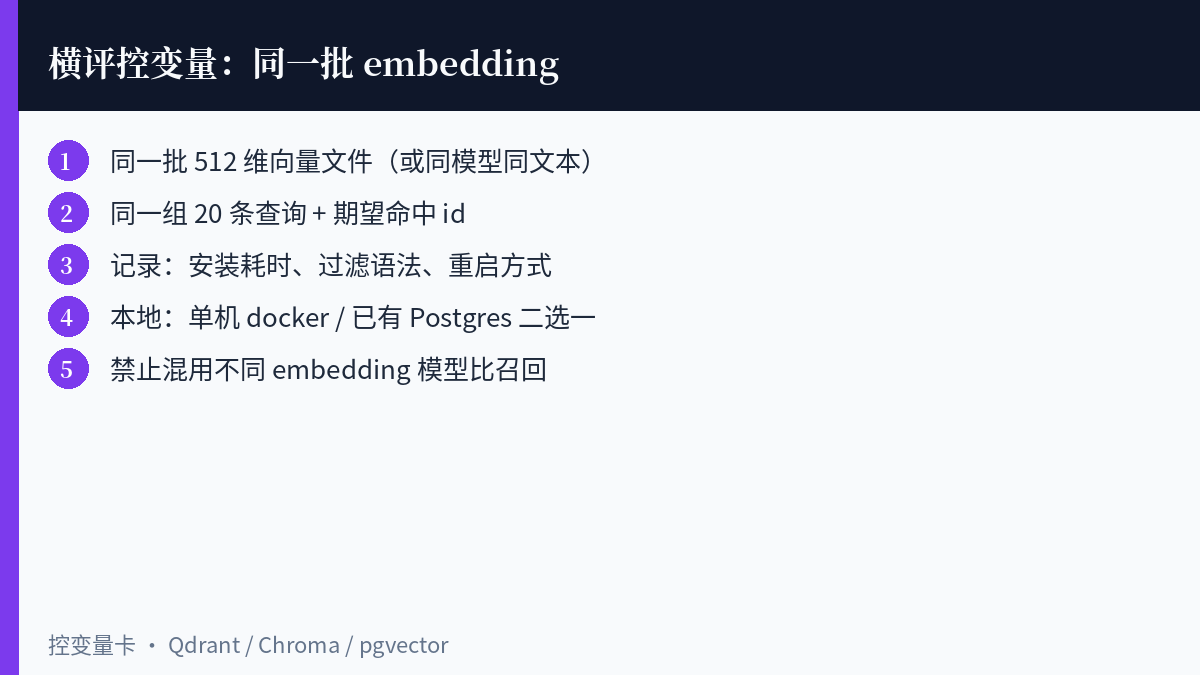
结论先行:没有「永远第一」的向量库,只有「你这台机器、这份数据、这周运维预算」下的第一。我控四件事:同一批向量文件(同模型、同维度、同文本切片);同一组 20 条查询与金标 id;同一台笔记本或同一台小云机;记录安装耗时、过滤写法、重启与备份路径。禁止用不同 embedding 模型去比召回,那是在比模型不是比库。
阅读对象是个人项目与三人以内小团队:本地 RAG 试玩、内部知识库、多租户原型。你若已经在云上买了托管向量服务且合规要求绑死供应商,这篇横评对你参考意义有限——直接看厂商 SLA 即可。
评测当天我固定维度示例为 512 或 768(与你的模型一致即可),payload 至少带 doc_id / tenant / tag / updated。查询侧同时测「纯向量 top-k」与「向量 + 过滤」。下面三节按同一模板写,末尾用表收口。
Qdrant:过滤与生产向 API 更完整
适合谁:你要明确的过滤语法、payload 索引、以后可能上多集合或多租户;能接受 docker 起一个专用服务。不适合:只想在 Python 里 pip install 五分钟看个 Demo、完全不想碰另一份进程。
安装观感:官方文档以 Docker / 二进制为主,本地一条 docker run 就能起来;也有云托管。对我这种「本机先跑通再谈集群」的路径很友好。HTTP/gRPC API 稳定,Python/JS 客户端齐全。
过滤:payload filter 表达力强,布尔组合、范围、匹配都常见于文档示例。个人项目里我最常用 tenant + tag 过滤,避免检索串租户。运维:数据目录挂卷即可备份;要留意内存与磁盘随向量增长。本地友好度:中高——多一个容器,但行为接近生产。
踩坑:维度写错会在 upsert 时报错,这是好事;真正麻烦的是过滤字段忘建索引,大数据量时变慢。先按官方建议给高频过滤字段建索引,再谈召回调参。
个人项目里我怎么用 Qdrant 做「同批」对比:先把 embedding 导出为 JSONL(id、vector、payload),用官方客户端批量 upsert;再对 20 条查询分别跑无过滤与 tenant 过滤。记录 top-3 命中与耗时中位数即可,不必一上来压测 QPS。若你后续要多集合(比如「产品文档」与「工单」分开),Qdrant 的 collection 模型比「全塞一个表」清晰。
何时我不选 Qdrant:笔记本电脑内存紧张,且这周只想证明「检索有没有用」——多一个 JVM/进程不是负担,但心智成本有。验证阶段用 Chroma,决定长期自建向量服务再迁 Qdrant,迁移成本主要是导入脚本,不算推倒业务。
Chroma:本地 Python 试玩路径最短
适合谁:研究笔记、课程作业、快速验证「切片+检索」是否值钱;希望默认体验偏 Python。不适合:你已经确定要用 Postgres 全家桶,或明确要强一致的 SQL 事务包住业务表与向量。
安装观感:pip install chromadb 就能 PersistentClient 落到本地目录;也有服务端模式。个人项目第一晚我经常用它验证数据清洗,而不是一上来搭集群。
过滤:metadata where 条件够用在中小集合;复杂布尔与生产级索引策略要对照当前版本文档,别拿一年前的博客当真理。运维:本地目录备份简单;换机器注意路径与依赖版本锁死。本地友好度:高——少概念,快反馈。
踩坑:Demo 代码和「以后要给别人用」之间有鸿沟。你一旦要多用户、权限、审计,就会发现自己在 Chroma 外面包一层业务服务——这不是缺点,是阶段问题。横评里我把它定位为「验证与轻量」,不是贬低。
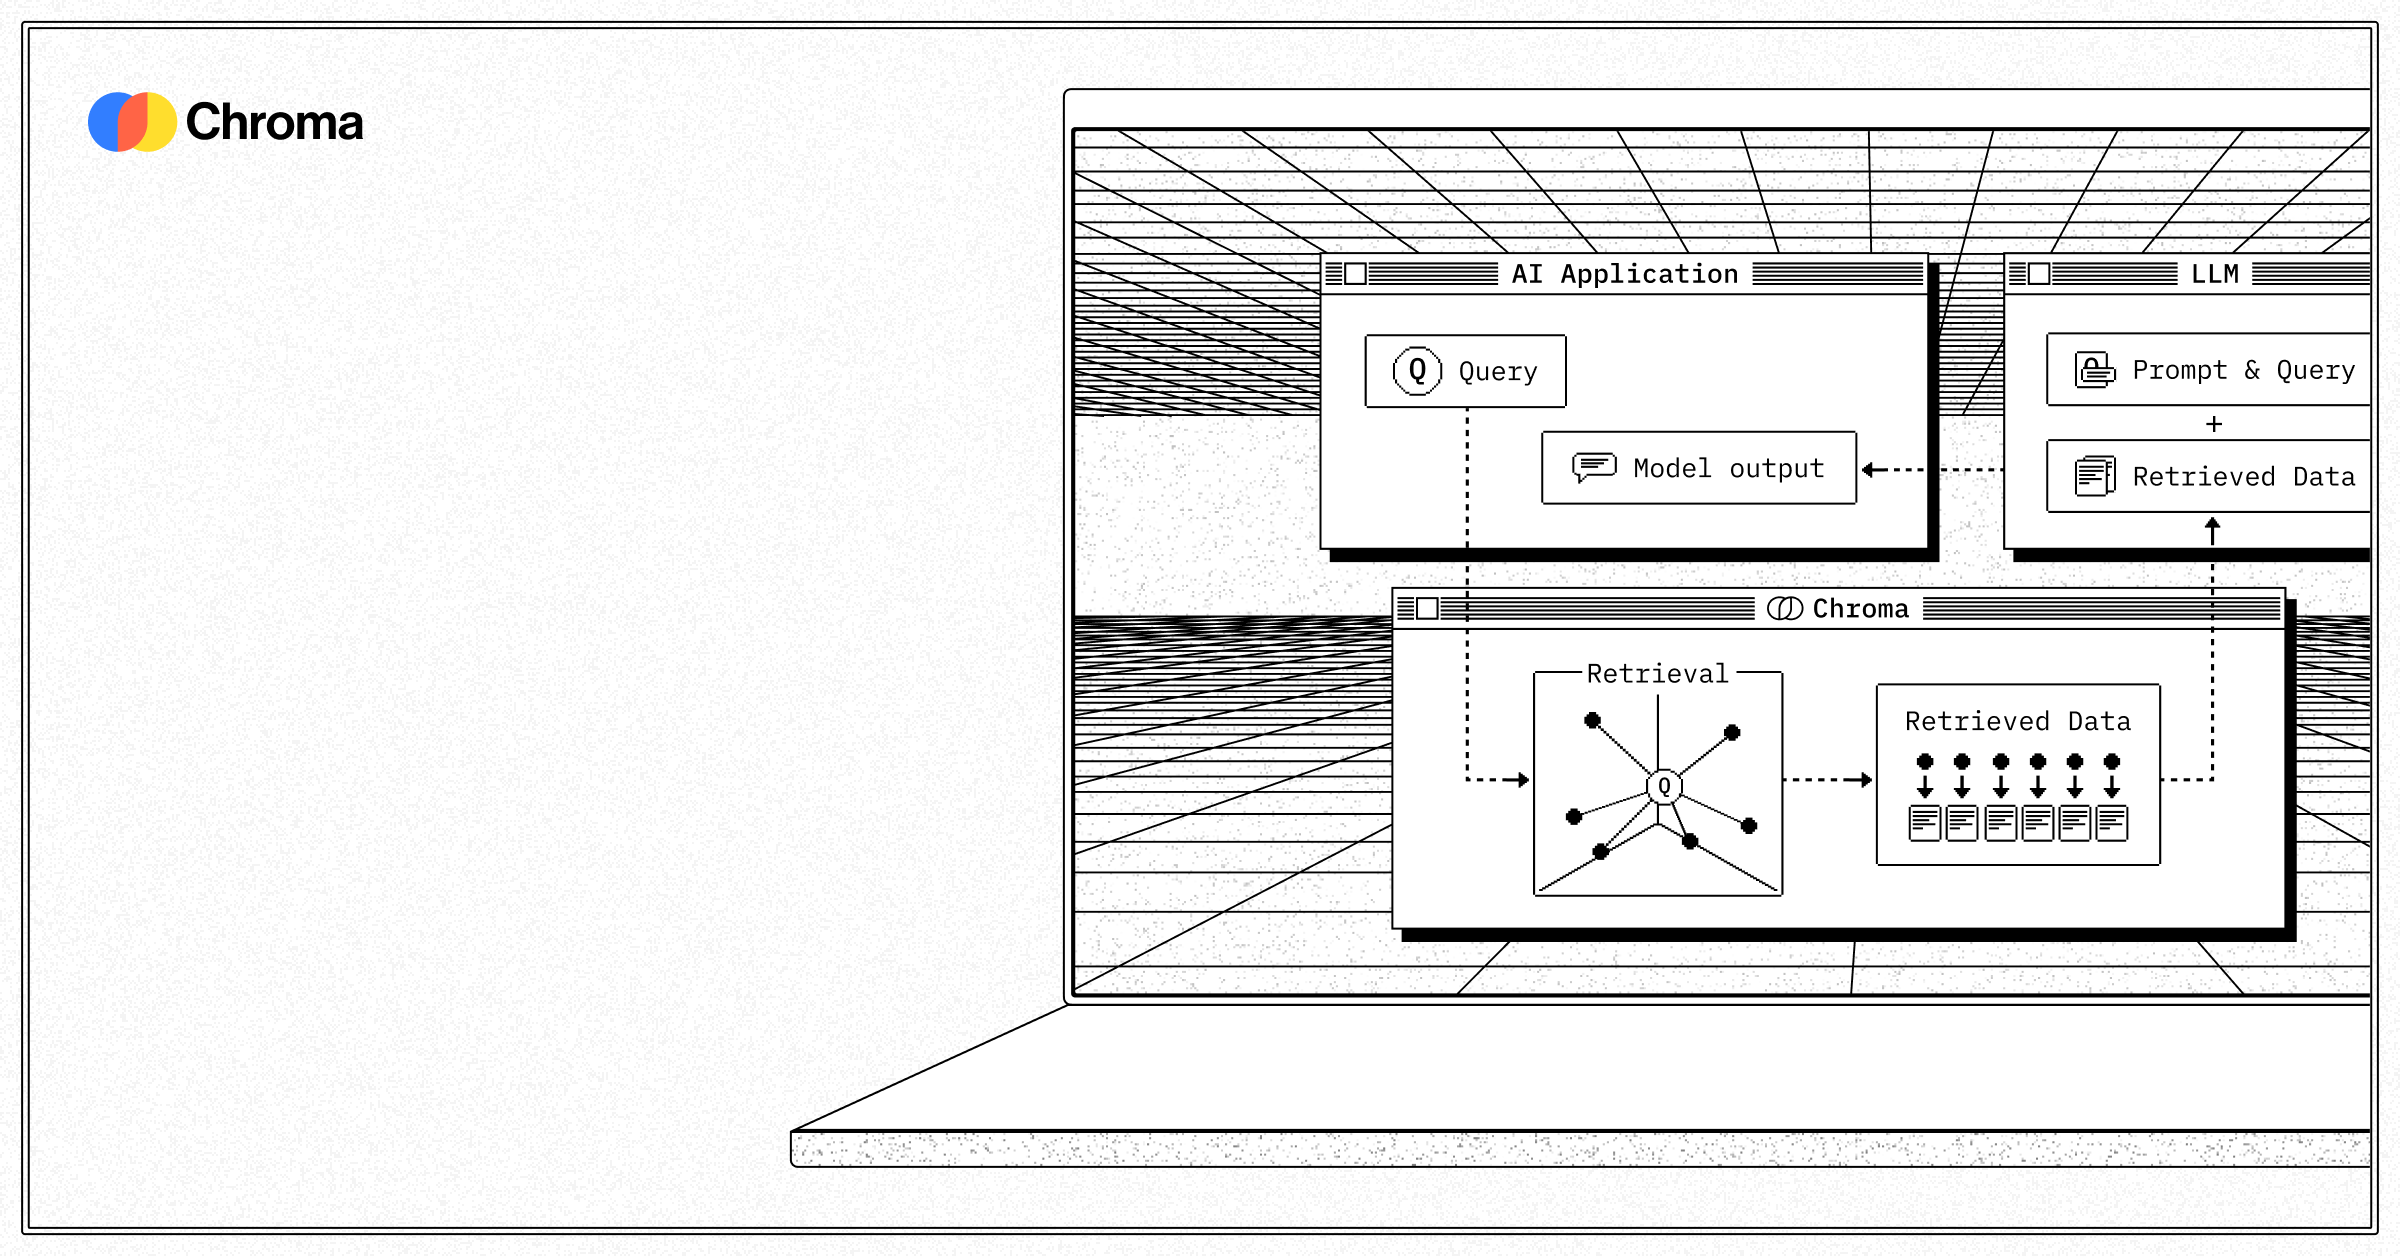
Chroma 在同批对比里的角色是「对照组与快速基线」。同一 JSONL 用 collection.add 灌进去,where 过滤跑同一批查询。若 Chroma 基线召回已经很差,先别怪库——多半是切片或 embedding 模型问题;此时换 Qdrant/pgvector 也救不了。
我遇到的真实坑:Notebook 里用了内存 Client,关机丢数据,第二天以为「检索坏了」。个人项目请默认 PersistentClient 并备份目录。另一坑是把不同模型的向量写进同一 collection,维度偶发一致但语义空间不同,召回会诡异——同批横评的「同模型」纪律就是防这个。
pgvector:已有 Postgres 时最省事
适合谁:业务已经在 Postgres(用户表、权限、事务);希望向量与业务数据同库查询;运维不想多养一个中间件。不适合:你完全没有 Postgres,还为了向量去学一套库管——那不如先用 Qdrant/Chroma 验证。
安装观感:扩展 CREATE EXTENSION vector;云厂商托管 PG 多数可开。本地可用官方镜像或自编译。SQL 心智模型对后端同学极友好:向量就是一列,索引用 ivfflat / hnsw(以你安装版本文档为准)。
过滤:直接 SQL WHERE,与租户、权限、业务状态天然一体——这是它相对专用向量库的最大优势。运维:备份跟 PG 走;要注意真空、索引重建窗口。本地友好度:对「已有 PG」极高,对「从零」中等。
踩坑:把超大集合塞进单表又不设索引,查询会惨。另一极端是过早上复杂分区。个人项目:先小表 + 合适索引 + 与业务同事务写入,跑通再谈分表。
pgvector 同批对比时,我把 JSONL 转成 COPY 或批量 INSERT;查询用同一度量。优势是:可以用 SQL 把「向量近邻」与「订单状态=已支付」写在同一句,权限跟现有 RLS 走。个人项目若已有用户表、文档表,少一个同步管道,出错面更小。
代价也要说清:你要会基本的 explain、索引与扩展升级。云上托管 PG 若不允许装扩展,这条路直接关闭。本地用 Docker Postgres + pgvector 镜像可以,但别忘了把数据卷挂出来,否则一删容器向量陪葬。
把同一批 embedding 真正跑一遍时,我还会固定三张检查表,避免「感觉还行」:
检查表 A · 数据一致性。向量条数、维度、id 是否一一对应;有没有 NaN;payload 缺字段比例。缺字段超过 5% 先修清洗,再比库。
检查表 B · 查询一致性。20 条金标查询的原文、期望 id、允许的近义命中。换库只换客户端,不改这 20 条。
检查表 C · 环境一致性。CPU/内存上限、磁盘路径、容器版本号写进笔记。隔周复测时版本漂移会让你误判「库变慢了」。
公开文档入口我固定这三个,写作与复测都从官网/仓库走,不靠二手总结:Qdrant Documentation,Chroma Docs,pgvector GitHub。版本特性以你安装日文档为准,文中命令示意只负责「最小可跑通」。
Comparison Table and Selection Conclusions
| dimension (math.) | Qdrant | Chroma | pgvector |
|---|---|---|---|
| Installation Cost (Personal Computer) | Docker 一条命令;多一个进程 | pip 最快;也可服务端 | 需 Postgres;已有库则几乎零增量 |
| 过滤能力 | payload filter 强,贴近生产 API | metadata where 够轻量场景 | SQL WHERE + 事务,业务一体 |
| 运维负担 | 独立服务;卷备份清晰 | 本地目录简单;上规模要重新评估 | 并入 PG 备份与监控 |
| 本地友好 | 中高 | 高(试玩首选) | 已有 PG 时最高 |
| My Default Recommendation | 要专用向量服务与清晰过滤 | 今晚验证 RAG 是否值钱 | 业务已在 Postgres |
选型一句话:先问自己有没有 Postgres——有,优先 pgvector;没有且只要今晚验证,用 Chroma;已经确定要独立向量服务与更强过滤,用 Qdrant。不要同时装三个「都试试一晚上」——控变量要求你同一批数据,但执行上先打通一个闭环。
迁移路径(条件句):Chroma 验证成功 → 数据量仍小、已有 PG → 迁 pgvector;需要独立向量服务与更复杂过滤 → 迁 Qdrant。Qdrant ↔ pgvector 互迁时,保持同一 embedding 文件,只重写导入与查询层,业务提示词与切片逻辑不要一起改,否则你分不清是库的问题还是链路的问题。
成本直觉(非报价承诺):多养一个向量容器,大约是「多盯一个磁盘与一个端口」;并入 PG 则是「多盯一个扩展与索引重建窗口」。个人项目选「你已经会的那种失败」——会 Docker 就 Qdrant/Chroma,会 SQL 就 pgvector。
今晚落地:选定后安装与最小检索
下面三套最小路径,选一条做。验收标准相同:导入同一批向量 → 5 条查询 top-3 含金标 → 再带一次过滤查询。
路径 A · Qdrant(Docker)
docker run -d --name qdrant -p 6333:6333 -v "$PWD/qdrant_storage:/qdrant/storage" qdrant/qdrant

# 用官方 Python 客户端创建 collection(维度改成你的)
# upsert 同一批点:id / vector / payload={tenant,tag,doc_id}
# query:vector 检索 + Filter must tenant=...
路径 B · Chroma(本地持久化)
pip install chromadb
# PersistentClient(path="./chroma_data")
# collection.add(ids=..., embeddings=..., metadatas=..., documents=...)
# collection.query(query_embeddings=..., n_results=3, where={"tenant":"demo"})
路径 C · pgvector
-- 在已有 Postgres
CREATE EXTENSION IF NOT EXISTS vector;
CREATE TABLE items (
  id bigserial PRIMARY KEY,
  tenant text,
  tag text,
  embedding vector(512)  -- 改成你的维度
);
CREATE INDEX ON items USING hnsw (embedding vector_cosine_ops);
-- INSERT 同一批;查询:
-- SELECT id FROM items WHERE tenant='demo'
-- ORDER BY embedding <=> '[...]' LIMIT 3;
Key Configuration Points.维度必须与 embedding 模型一致;过滤字段写入时就填,不要检索阶段才想起来;把金标 20 条查询存成 JSON,下次换库直接重跑。备份:Qdrant 拷贝 storage 卷;Chroma 拷贝持久化目录;pgvector 走 pg_dumpThe
Troubleshooting a crash.结果全飘:先怀疑 embedding 模型或预处理不一致,再怀疑度量(余弦/L2)与索引类型。过滤后变空:检查 payload/metadata/列是否真有该 tenant。Docker 起不来:看端口占用与磁盘权限。PG 扩展找不到:确认镜像或云实例已启用 vector 扩展。
同批验收脚本骨架(伪代码,按你选的客户端改)。
# 1) load vectors.jsonl  # id, vector, payload
# 2) upsert_all(engine)
# 3) for q in queries.json:  # text already embedded OR embed now with SAME model
#        hits = search(engine, q.vector, top_k=3, filter=q.filter)
#        record(q.id, hits, gold=q.gold_ids)
# 4) print recall@3, filter_empty_rate
# 5) save report-YYYYMMDD.md next to the vector file
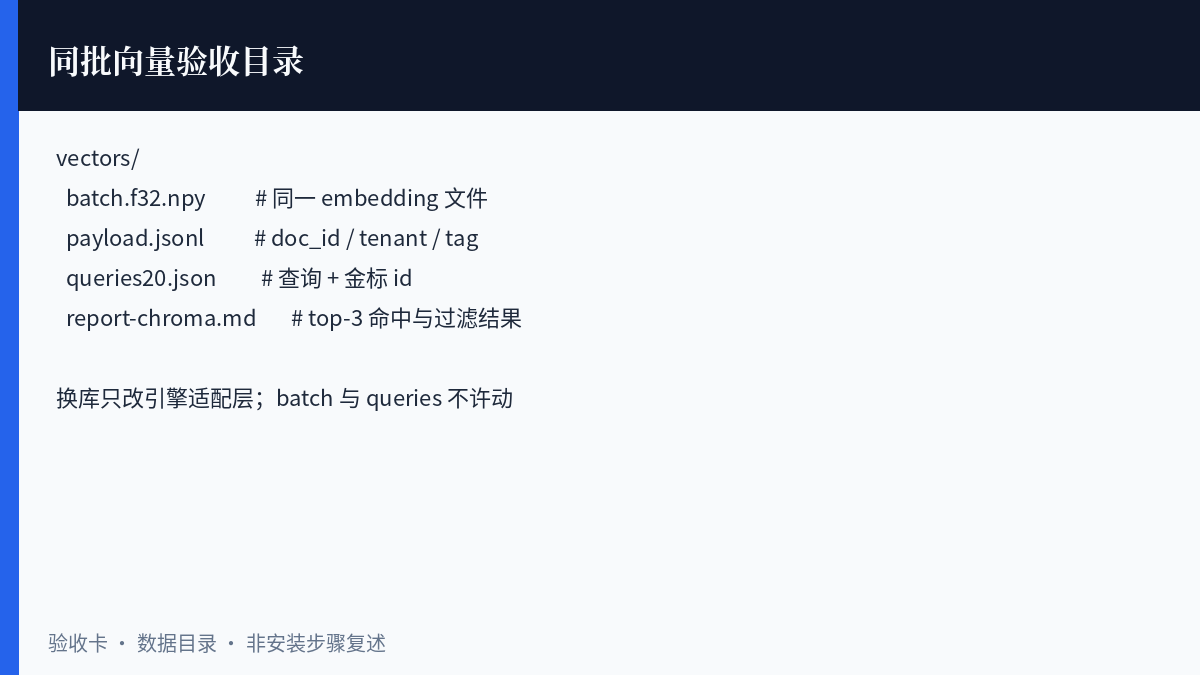
把报告和向量文件放同一目录,下周换库时只换引擎适配层。这就是「同一批嵌入」横评能复现的最小工程化。
若三选一仍犹豫:今晚用 Chroma 跑通报告;若你仓库里已有 Postgres schema,直接抄路径 C。Qdrant 留给「确定要独立向量服务」的第二天,不阻塞今晚闭环。
收尾:横评的目的不是让你收藏三份官网,而是今晚选定一个、导入同一批向量、跑通带过滤的查询。闭环在手里,品牌文章可以明天再读。


Comment List (0):
Load More Comments Loading...