


DEEP DIVE / 2026.11.08
把均值、税率、对账差额交给模型「心算」,表面上省一次工具调用,报表却可能在小数点上翻车。结论先说:精度敏感的数字应强制走代码执行;叙事、常识和一位数心算不必。
下文按 Anthropic 官方 Code execution 文档解读(核验日 2026-11-08,Asia/Shanghai),不是本机实测。
「工具已经加进请求」不等于「每个数字都跑过代码」。官方写明:简单算术和常识题,模型可以直接回答。产品要的是可核验结果时,必须显式要求执行,并检查响应里的执行结果是否成功、对应计算是否完整。
先分清口算和沙箱执行
模型口算是把中间步骤留在生成文本里,对了也难以复现,错了更难追责。代码执行则把计算放进服务端沙箱,返回 stdout、return_code 和可能的生成文件。
Anthropic 把它做成 server tool:只要在 tools 里声明版本 type 与 name: code_execution,命令在服务端跑完。一般不用自己回传 tool_result;若响应因 pause_turn 暂停,还需按文档续接,不能把暂停当成计算已完成。
文档列出三个在用版本:code_execution_20250825 支持 Bash 与文件操作;code_execution_20260120 增加 REPL 状态保持,以及从沙箱里程序化调用你的其他工具。不过 Haiku 4.5 不支持这两项能力,接受新版工具类型也不意味着这些能力可用。
code_execution_20260521 运行时与前者相同,但会向模型说明每个 Python cell 有 90 秒墙钟限制。
三个当前版本都不必加 anthropic-beta 头。官方建议换新模型时核对工具版本页,优先用集成能支持的最新版。仅 Python 的旧版 code_execution_20250522 仍能跑旧工作流,但不保证和新模型长期兼容。
OpenAI Responses API 也有官方 Code Interpreter(type: code_interpreter,必须带 container)。文档写明容器闲置约 20 分钟过期。
下文限制、配额和价格以 Anthropic 文档为准,便于对照核验。
官方何时会跑、何时跳过
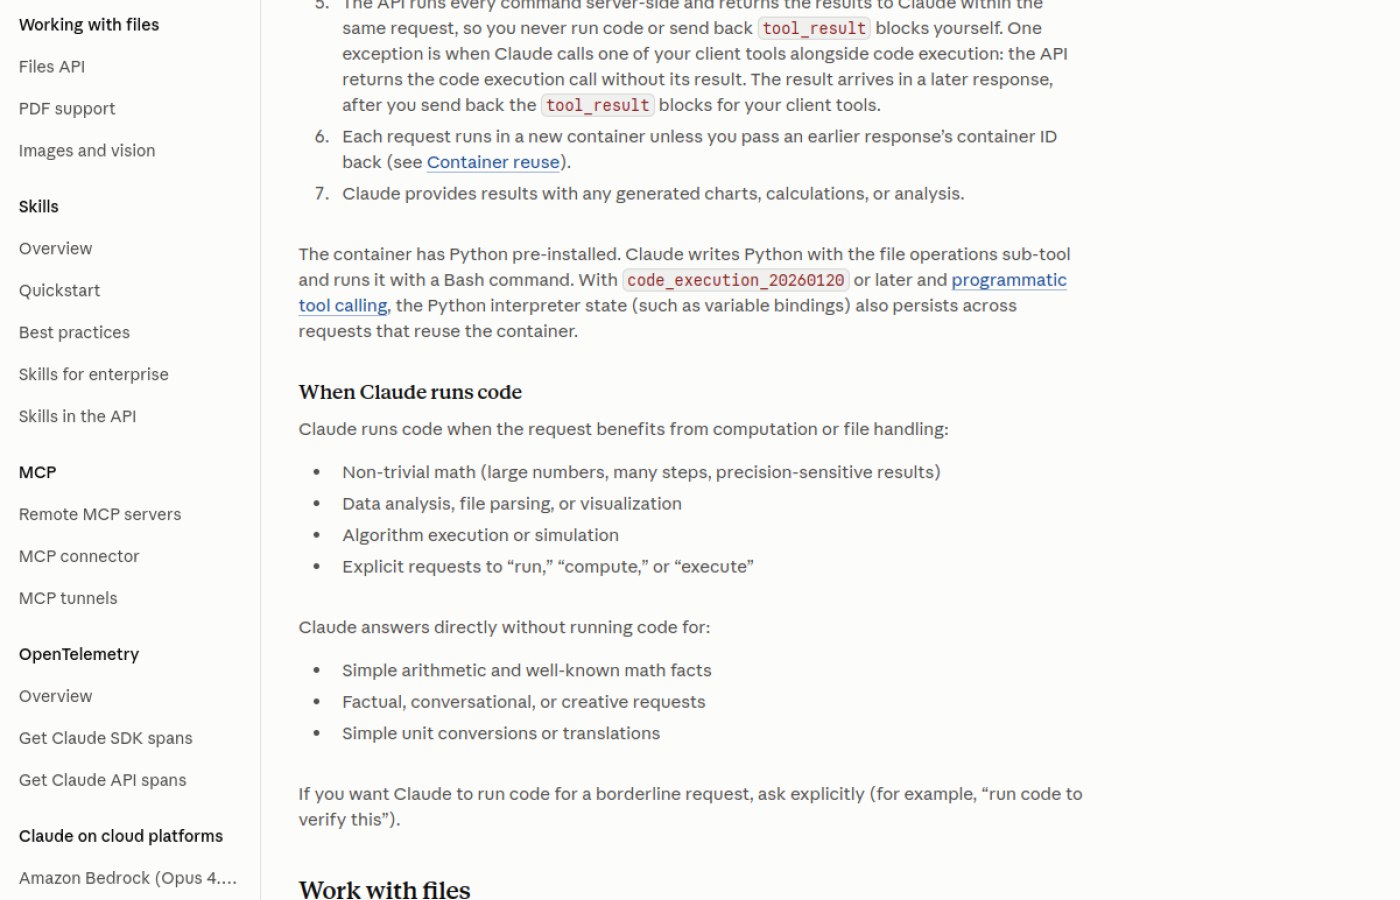
文档专节「When Claude runs code」写得很清楚。会倾向执行的情况包括:非平凡数学(大数、多步、对精度敏感)、数据分析、解析文件、可视化、算法或仿真,以及用户明确说 run / compute / execute。
它也列出了直接回答、不跑代码的情形:简单算术和众所周知的数学事实、事实性、闲聊或创作请求,以及简单单位换算或翻译。
这正是产品设计的分界线。你若只是「把工具挂上」,模型仍可能对一张对账表口算后直接给结论。官方自己的建议是:临界请求要显式要求,例如「run code to verify this」。
落地时不要只看最终自然语言。应检查响应里是否出现 server_tool_use(例如 bash_code_execution)及其结果块;没有这些块,就不能声称「数字已经算过」。只有调用记录也不够:还要关联工具调用与结果、确认退出码为 0、无超时或错误,并核对输出是否对应本次输入。
沙箱边界与计费口径
沙箱是隔离的 Linux 容器:Python 3.11、x86_64、约 5 GiB 内存、5 GiB 工作区、1 个 CPU。官方明确:完全没有互联网,不能在运行时安装软件包,只能用预装库。
预装库覆盖常见数据科学生态,例如 pandas、numpy、scipy、matplotlib、openpyxl、pypdf。容器里还有 unzip、sqlite、rg 等命令行工具。缺库且必须上网装包时,这条官方路径不适用。
默认每个请求是新容器;要保留文件,或在较新版本里保留解释器状态,需把上一轮响应里的 container.id 传回去。容器创建后最多保留约 30 天;闲置约 5 分钟会被 checkpoint,仍可在 30 天窗口内恢复。
过期后再带旧 ID 会报错,应去掉 container 参数重开。自建 Bash 或 REPL 同时存在时,官方提醒两个环境不共享变量和文件,要在 system prompt 里写清各用哪个。
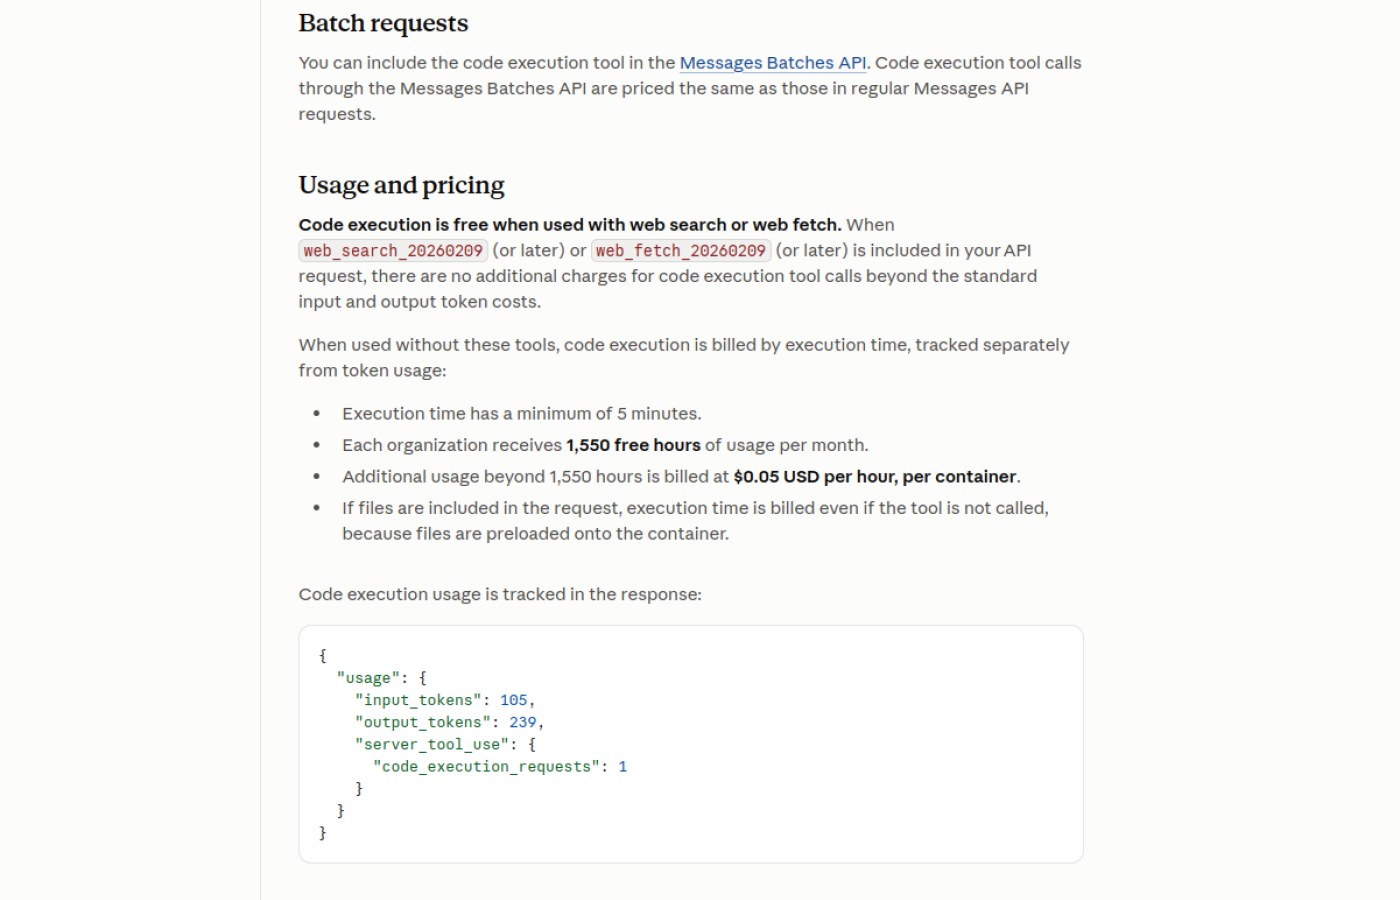
计费以文档美元口径为准:与 web_search_20260209(或更新)或 web_fetch_20260209(或更新)一起用时,代码执行不再另收,只算常规 token。
单独使用则按执行时间计,每次至少 5 分钟;每个组织每月有 1,550 免费小时,超出部分每容器每小时 0.05 美元。请求里如果带了文件,即使模型没调用该工具,也会因预加载而计执行时间。
代码执行数据不符合 Zero Data Retention,也不符合 HIPAA;容器数据最多保留约 30 天;但经 Files API 导出的文件会一直保留,直到显式删除,不能把容器到期当成这些文件已删除。这是合规上的硬停止条件,不能靠「我们只跑一下统计」绕过去。
适用、不适用与强制条件
下表只整理公开文档能支撑的判断,方便例会拍板。它不是跑分,也不替代你自己的合规审查。
| 情形 | 建议 | 依据 |
|---|---|---|
| 对账、税率、统计量、多步公式 | 强制走代码执行 | 官方列为倾向执行;强制与验收是应用侧设计 |
| CSV / Excel 分析或要下载图表 | 强制;文件走 Files API | 文档支持上传分析与 $OUTPUT_DIR 回收文件 |
| 一位数心算、文案、观点 | 不必开 | 官方写明简单算术和创作可直接回答 |
| 必须安装沙箱没有的包 | 不用这条官方路径 | 容器无网,不能运行时装包 |
| 数据不能出域,或要 ZDR / HIPAA | 停止,改走自控环境 | 文档:不符合 ZDR,不符合 HIPAA |
| 已有本机或 VPC 内权威计算环境 | 以你的执行工具为准 | 官方提醒多套执行环境不共享状态 |
口诀是:数字要能复现就强制执行;结论属于判断而不是计算结果时不必;数据出不了域或沙箱缺库时,换你控制的执行环境,而不是指望官方沙箱「变通」。
- 声明工具:请求带上当前文档推荐的
code_execution_*版本;换模型前先读 Models API 里的capabilities.server_tools.code_execution.supported。 - 显式要求:提示词写明「用代码执行工具验算,并给出命令与输出」,不要只写「请计算」。
- 检查证据:应用层断言响应含代码执行结果块;关联调用和结果,确认成功退出,再核对输入、公式、单位与输出;不能仅凭出现过执行块或
stdout就验收。 - 管好容器:多轮分析要回传
container.id;过期就重建,不要假设变量还在。 - 先看合规:需要 ZDR 或 HIPAA 时,这条路径直接停用。
和 Schema、评测集怎么分工
站内近文《同一条任务我先锁 JSON Schema,再谈文采》解决的是输出形状:字段齐不齐、类型对不对。Schema 锁不住「税额算没算对」。
《上线前我宁可用 50 条评测集卡死幻觉》解决的是上线前回归。评测集能抓住已经写进集的错法,却不能在每一笔实时对账里替你跑公式。
代码执行补的是可检查的运行时计算过程,而不是自动保证计算正确。模型仍可能选错公式、漏行或混淆单位;二进制浮点也可能带来金额舍入误差。金额应约定舍入规则,使用十进制 Decimal 或整数最小货币单位,并对总额与边界值复核。三者应叠用,而不是互相替代:Schema 管结构,代码执行管中间计算,评测集管是否还记得「必须执行」这条纪律。
也不要把它和 Message Threads、更便宜的 computer-use 档混为一谈。前者关延迟与会话传输,后者关桌面操作成本;都回答不了「这个数字是不是跑出来的」。
我们的判断:精度敏感的数字应强制走代码执行,并检查响应里的执行证据;不要假设「工具已声明」等于「已经算过」。沙箱无网、单独使用按时长计费,且不符合 ZDR / HIPAA。本文是官方资料解读,不含本站实测数字。
参考链接
- Anthropic Docs:Code execution tool
- Anthropic Docs:Tool reference
- Anthropic Docs:Programmatic tool calling
- OpenAI Docs:Code Interpreter
- 站内:同一条任务我先锁 JSON Schema,再谈文采
- 站内:上线前我宁可用 50 条评测集卡死幻觉


Список комментариев (0 записей):
Показать ещё отзывы Загрузка...