


把杂乱办公文件直接丢给 LLM,十次有九次在表格和版式上翻车。我现在的习惯是:先过 MarkItDown,再谈提示词。仓库是微软开源的 microsoft/markitdown。本文是聚合结构:以 MarkItDown 为第一站,把 Docling、Unstructured、pandoc 按「什么时候该换」聚到一条路由上,而不是死磕单个工具的参数;最后两节是安装跑通和翻车验收,照着做就能落地。结论先说——快转办公文件很香,复杂扫描表别指望它独自扛。它值得进工具箱,不值得被吹成文档理解终结者。和同日工具横评那篇对照:横评讲三家同输入;本篇把 MarkItDown 当主角讲怎么用。
定位:它解决什么、不解决什么
MarkItDown 把 PDF、Word、PPT、Excel、图片、音频等转成 Markdown,面向「给 LLM 吃」而不是排版还原。它不是完整文档理解中台,是本地或脚本里能一把梭的转换器。你要的是「模型读得懂条款」,不是「打印出来像素级一致」——目标不同,选型就不同。
适合:个人或两人小队的前置清洗;当天要看到模型读起来像什么,再决定哪些文件升级到 Docling;docx/pptx/xlsx 批量转 MD 喂模型。
不适合:已承诺客户「扫描工资表结构 100% 还原」;高保真复杂扫描表、要精确版面还原的场景——那种承诺不该由它单独承担。
读 README 时我先看:支持格式列表、可选 extras、命令行入口、已知限制。版本号不在本文锁死,以免你按过期参数装失败。以克隆当日的 README 为准,是开源专栏的基本礼貌。
项目卡片
| 项 | 内容 |
|---|---|
| 仓库 | https://github.com/microsoft/markitdown |
| 许可 | 以仓库 LICENSE 为准(安装前再确认当前文件) |
| 语言 | Python |
| 适合 | docx/pptx/xlsx/pdf 等批量转 MD 喂模型 |
| 不适合 | 高保真复杂扫描表、要精确版面还原的场景 |
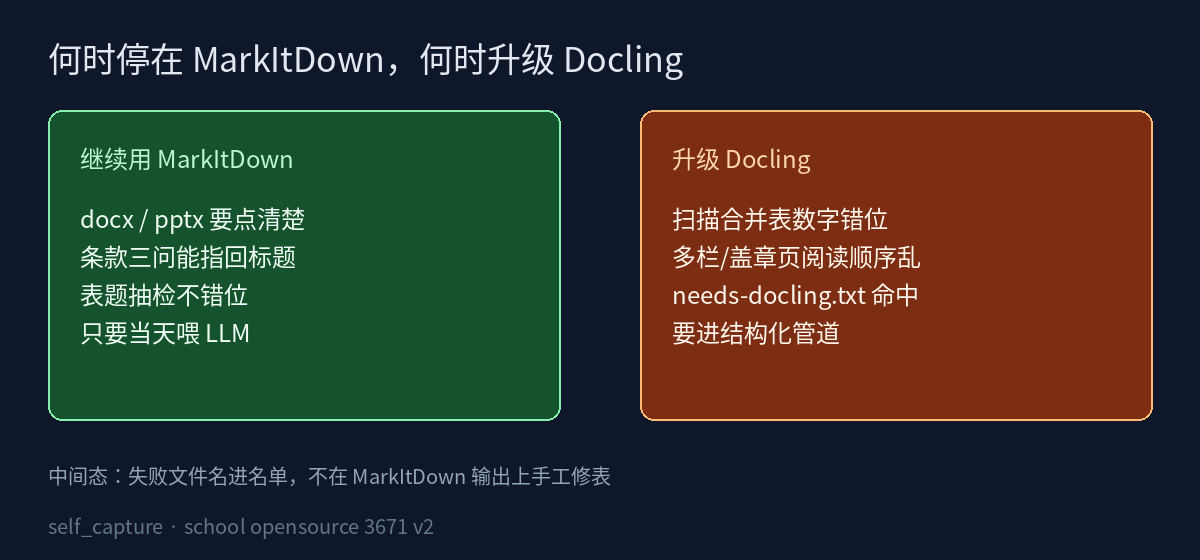
上图是我的路由直觉:条款三问能指回标题、表题抽检不错位,就继续用 MarkItDown;扫描合并表数字错位、多栏/盖章页阅读顺序乱,就整文件进 needs-docling.txt,不在 MarkItDown 输出上手工修表——手工修表无法回归,下一波文件来时还得再修。
用例:docx 制度与 pptx / 扫描 PDF
用例一:一份《差旅报销制度》docx。标题和列表转出来干净,模型能按条款回答「过夜费上限」。嵌在文档中的简易表基本能认,合并单元格多的表会糊,需要人工瞄一眼。验收动作很土:随机抽三条制度问题,看回答是否能指回 MD 里的小标题。
用例二:培训 pptx + 扫描 PDF。pptx 每页要点进 MD 后适合做「讲义检索」;幻灯片上的复杂示意图只会变成残缺描述,需要人工补一句「见图,MD 未还原」——诚实标注缺失,比假装啥都能转更让同事信任。扫描 PDF 能出字,但薪资表一类结构容易散——这和工具横评里的结论一致,复杂扫描我改 Docling。不要因为「同属 PDF」就假设行为一样;电子版 PDF 和扫描件是两种动物。
我会把失败文件名记进 needs-docling.txt,而不是在 MarkItDown 后处理里堆特例。特例一多,等于私造第四个工具且无人维护。扫描策略:先用 MarkItDown 出一版,抽表内数字题;错位超过阈值,整文件改 Docling。
优点:安装轻、格式覆盖广、和「喂 LLM」目标对齐;脚本里好串;失败时也容易换下一工具。
缺点:不是版面真理;扫描大表、复杂多栏要验收;依赖组合踩坑时要读 extras 说明;别指望它替你做权限与脱敏。
| 工具 | 何时换它 |
|---|---|
| Docling | 扫描件、表结构优先 |
| Unstructured | 已有企业解析与分片流水线 |
| pandoc | 经典文档互转、不一定为 LLM 优化 |
和团队协作时约定输出目录结构,例如 md/原文件名.md,并在 CI 里对空文件、极短输出、明显乱码做失败门槛。安全上:别把未脱敏合同批量上传到在线演示环境。本地转完、抽检完,再决定进哪个向量库。开源许可证允许你改脚本,不等于客户允许你把原文传到第三方。工作副本存放时长写进约定;销毁要有记录;客户原文不进个人网盘。MarkItDown 只是转换器,不帮你承担泄密责任。
我把 MarkItDown 放在工具链第一站,还有一个很实际的原因:失败成本低。装得快,卸得也快;输出是普通文本,坏了就丢。重型管道失败时,你往往已经为环境、模型权重和权限申请付了时间。先用轻工具暴露语料真相,再决定要不要付重工具的账单,是稳妥的工程顺序。若有人拿「微软出品」当质量保证——别。出品方背书的是开源发布,不是你的验收题。验收题永远是你的。
安装与最小跑通(今晚就能做)
客户丢来一堆制度 Word 和培训 PPT 要进检索时,我若先在转换层纠缠重型全家桶,一周都在配环境。MarkItDown 让我当天看到「模型读起来像什么」。按官方 README:新建虚拟环境,安装核心包,再按需要加 PDF 等相关 extras。第一次失败多半是 extras 没装齐或系统缺少底层依赖,而不是「项目不可用」。把完整报错贴进笔记,比在群里说「装不上」有用。
python -m venv .venv && source .venv/bin/activate
pip install "markitdown[all]"   # extras 名称以当前 README 为准
markitdown 差旅制度.docx -o md/差旅制度.md
test -s md/差旅制度.md && echo SMOKE_OK
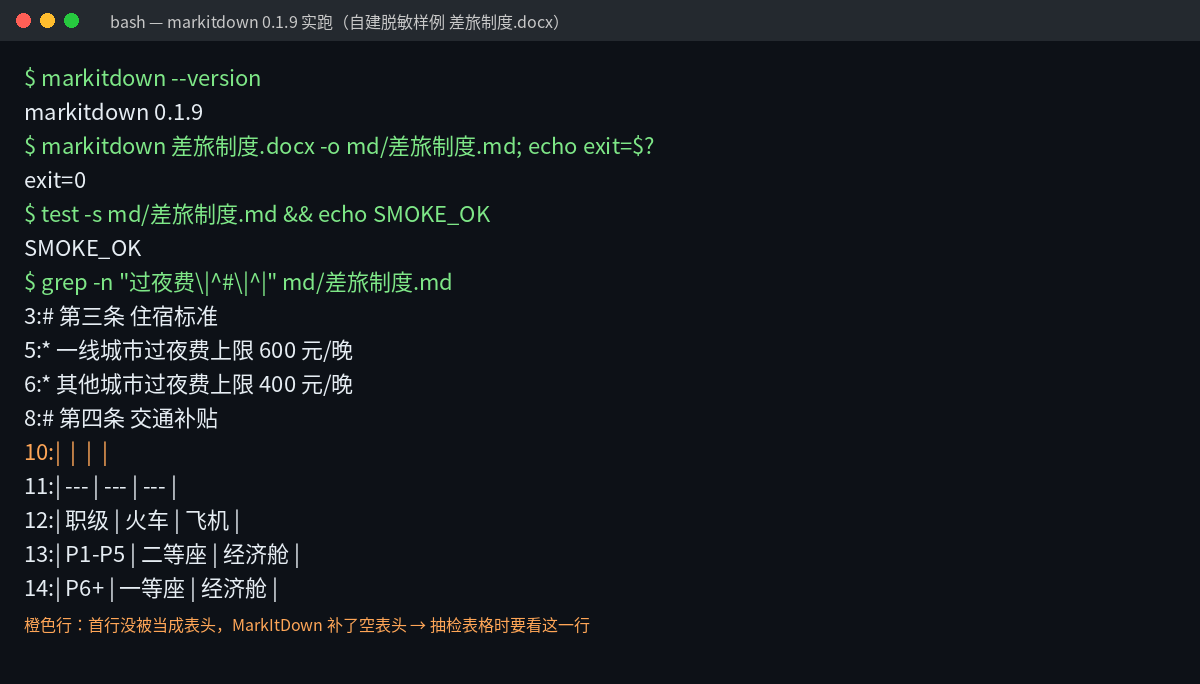
上图是我用 0.1.9 版对一份自建脱敏样例的实跑:退出码 0、文件非空、条款标题和过夜费列表都在。但注意橙色那行——docx 表格的首行没被识别成表头,输出里多了一行空表头,「职级/火车/飞机」掉进了数据行。模型多数时候还能读懂,可一旦你按表头做结构化抽取就会错列。这就是为什么冒烟之后还要人工抽检。
冒烟三行不过,先别写批处理:命令是否退出 0;输出是否非空;抽一个标题问模型能否答到点上。批处理只会放大失败。装上之后立刻跑官方或自备的最小样例;样例不过,不要开始写自己的封装。
翻车与验收:三问、难例集、CI 红灯
常见翻车按出现频率排:一是 extras 没装齐,PDF 或 pptx 直接报缺依赖,按报错补装即可;二是 docx 的「标题」样式(文档大标题)落成普通文本、表格首行变数据行,像上图那样,抽检时专盯第一行;三是扫描 PDF 出字但表格散架,不修,整文件改 Docling;四是加密 PDF 要么报错、要么只出极短内容,靠 test -s 加行数阈值拦住。每类翻车各留两份脱敏难例,升级版本就重跑一遍,变好变坏都记下来。
三问验收(人工,可直接抄进仓库):
- 过夜费上限(或你业务里的等价条款)能否指回 MD 小标题?
- 列表是否未糊成一段?
- 表内数字题是否错位?错位 → 文件名记入
needs-docling.txt,整文件升级,不手工修表。
转换前记录文件来源、格式和是否扫描件,扫描件默认进入人工复核队列。转换后先看标题层级,再看列表和表格,最后看页眉页脚、脚注这类噪音是否混进正文。用同一组三问分别问原文和 MD 版本,答案不一致就标记为待升级,而不是调提示词去掩盖。每次升级 MarkItDown 版本后重跑难例集,结果变好或变坏都写进变更记录。进入向量库之前再做一次脱敏抽查。
封装时我只保留三个接口:输入路径、输出路径、失败时非零退出。日志里打印工具名与版本查询命令的输出,方便三个月后知道当时跑的是谁。版本漂移是开源协作的日常,不记录版本的「曾经能跑」等于玄学。关于「是否要包一层 Web UI」:个人试用不必。团队若非要 UI,先保证命令行路径可回归;UI 只是皮。命令行回归套件才是骨头:同输入、同题库命中,破了就红灯。
和 CI 的最小结合:对样本目录跑转换,断言输出行数大于阈值、不含明显乱码替换字符、关键标题字符串仍在。等团队大了,再把 Docling 路由测也加进去。贡献与反馈:若发现某类中文公文结构系统性坏掉,准备最小复现文件(脱敏)再去上游沟通;没有复现的「中文支持差」很难被处理。对内则先保证自己的难例集与题库。
你今晚就能做的最小动作:打开 microsoft/markitdown README,安装,转一份自家制度,抽三问。三问过了,再谈批量与封装;未过不要装懂。顺序不能反。办公杂文件喂模型之前,我先过 MarkItDown;表一散就升级工具,不硬扛。安装与能力边界以 GitHub 当前 README 与 LICENSE 为准,本文不替代文档。
我会在 README 旁开一个本团队的「踩坑附录」:某版 extras 名称、某类加密 PDF 直接放弃、某类图片型扫描必须改 Docling。附录比向上游提情绪化 issue 更有用。上游忙着演进,你们的文件分布只有你们自己清楚。加密 PDF、扫描件、多栏公文三类,建议各留至少两份脱敏难例,版本升级必跑。
若读完只改一个习惯:把 microsoft/markitdown 的 README 钉在浏览器,把自家三问验收钉在仓库。两个钉子比安利十次「微软开源了」更能让项目活过下周。写进日历的三十分钟——安装、转一份制度、抽三问——比收藏一百篇评测更接近可用的工具链。三问不过就记进失败名单,过了再谈批量与封装。顺序不能反,否则后面全是无效的大返工。


评论列表 (0条):
加载更多评论 読み込み中...